



 MWC 2018
 2018
 Computex

 IFA 2018



Китайская Xiaomi, известная в первую очередь как производитель мобильных устройств, оборудования умного дома, а теперь и электромобилей, заявила о себе в новом качестве. Она решила занять место в исследованиях в области робототехники.









Источник изображений: xiaomi-robotics-0.github.io
Компания представила Xiaomi-Robotics-0 — модель искусственного интеллекта с открытым исходным кодом, сочетающую в себе визуальный, языковой компоненты и компонент действия; у неё 4,7 млрд параметров. В модели объединяются распознавание визуальных образов, понимание языка и способность производить действия в реальном времени, что, как отметили в Xiaomi, составляет ядро «физического интеллекта». Она уже установила несколько рекордов как в симуляциях, так и в реальных испытаниях.
ИИ-модели для роботов обычно действуют в замкнутом цикле: восприятие, принятие решения и выполнение операции. Робот видит объекты окружающего мира, понимает, что от него требуется, составляет план действий и реализует его — Xiaomi-Robotics-0 создавалась, чтобы сбалансировать широкое понимание с точным управлением моторикой. Для этого здесь использована архитектура «смеси трансформеров» (Mixture-of-Transformers — MoT), которая помогает распределять обязанности между двумя основными компонентами.
Первый компонент — визуально-языковая модель (VLM), выполняющая функцию «мозга». Она обучена интерпретировать отдаваемые человеком команды, в том числе расплывчатые, такие как «пожалуйста, сложи полотенце», а также понимать пространственные отношения на основе визуальных сигналов высокого разрешения. Задачи этой части — обнаружение объектов, ответы на вопросы в визуальной области и логические рассуждения. Второй компонент в Xiaomi называют экспертом по действиям (Action Expert). Эта часть модели имеет архитектуру диффузионного трансформера (Diffusion Transformer — DiT). Она не предполагает выполнения одного действия за раз, а генерирует последовательность действий, используя методы сопоставления потоков, что обеспечивает точность и плавность движения.
Слабой стороной VLM является то, что при обучении выполнению физических операций они, как правило, теряют часть заложенных ранее способностей к пониманию. Инженерам Xiaomi удалось избежать этой проблемы, обучая модель одновременно на мультимодальных данных и данных о действиях. В теории это означает, что такая система может одновременно рассуждать об объектах окружающего мира и учиться в нём передвигаться. Процесс обучения включает несколько этапов. Сначала механизм «предложения действий» заставляет VLM предсказывать возможные распределения действий при интерпретации изображений — это помогает согласовывать внутреннее представление модели о том, что она видит, с тем, как выполняются операции. После этого работа компонента VLM приостанавливается, и DiT проходит отдельное обучение для генерации точных последовательностей из шума на основе ключевых признаков, а не дискретных языковых токенов.
Xiaomi удалось решить проблему задержки вывода — паузы между выдаваемыми моделью прогнозами и физическим движением робота. Для этого реализовали асинхронный вывод, разделив вычисления модели и действия робота: движения остаются непрерывными, даже если модели требуется дополнительное время на обдумывание. Для повышения стабильности используется техника Clean Action Prefix, предполагающая возврат в модель предсказанного ранее действия, что обеспечивает плавное движение без рывков во времени. Маска внимания направляет модель на актуальный визуальный ряд, понижая приоритет прошлых состояний, в результате чего робот оказывается отзывчивым к внезапным изменениям окружающей среды.
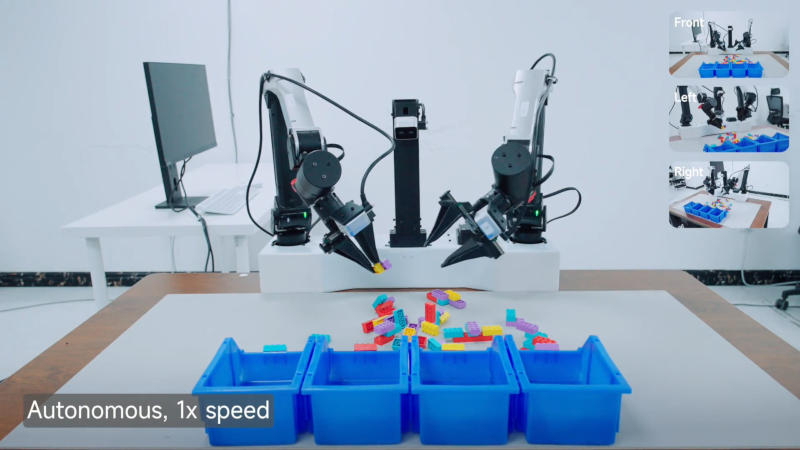
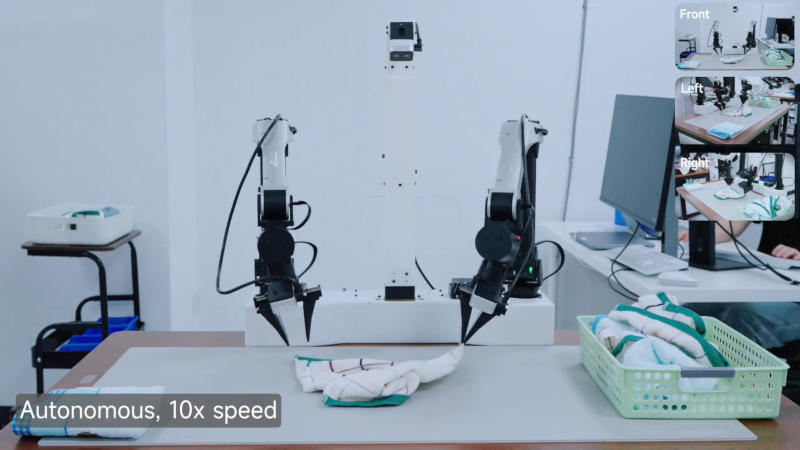
В симуляциях LIBERO, CALVIN и SimplerEnv модель Xiaomi-Robotics-0 превзошла около 30 других, сообщил разработчик. В реальных экспериментах она проверялась на роботе с двумя манипуляторами: в задачах с последовательностями действий, таких как складывание полотенец и разборка блоков конструктора, робот демонстрировал стабильную координацию рук и глаз, одинаково эффективно манипулируя как жёсткими, так и мягкими объектами. Модели действительно удалось сохранить сильные визуальные и языковые возможности, особенно в задачах, связанных с физическим взаимодействием.
Источник:


