



 MWC 2018
 2018
 Computex

 IFA 2018



Google представила лёгкую и быструю открытую модель искусственного интеллекта EmbeddingGemma 2 — открытую модель для поиска по текстам, коду, изображениям, аудио и видео прямо на устройстве. На практике она позволяет искать в коллекции медиафайлов объекты или события по их текстовому описанию без отправки каких-либо данных в облако.







Источник изображения: blog.google
Модель превращает разные виды данных в единый формат — числовые векторы из 768 значений, отражающие содержание. В результате текстовый запрос можно соотнести с изображением или звуком, даже если у файла нет подходящего названия и описания. То есть вместо совпадения слов система сопоставляет близость содержимого по смыслу.
Главное отличие EmbeddingGemma 2 от первой версии — выход за пределы текста. Новая модель обрабатывает изображения и звук напрямую: собирать комбайн из распознавания речи, генерации подписей к картинкам и отдельной модели для текстового поиска больше не требуется. А для видео можно проиндексировать кадры вместе с фрагментами аудио и находить конкретные моменты.
Модель EmbeddingGemma 2 построена на архитектуре открытой Gemma 4 и распространяется по допускающей коммерческое использование модели Apache 2.0. При размере 740 млн параметров она с лёгкостью запускается локально на современных потребительских устройствах.
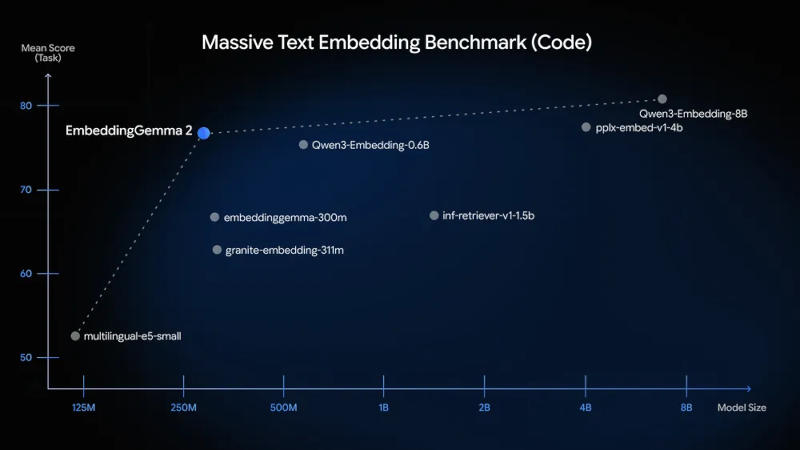
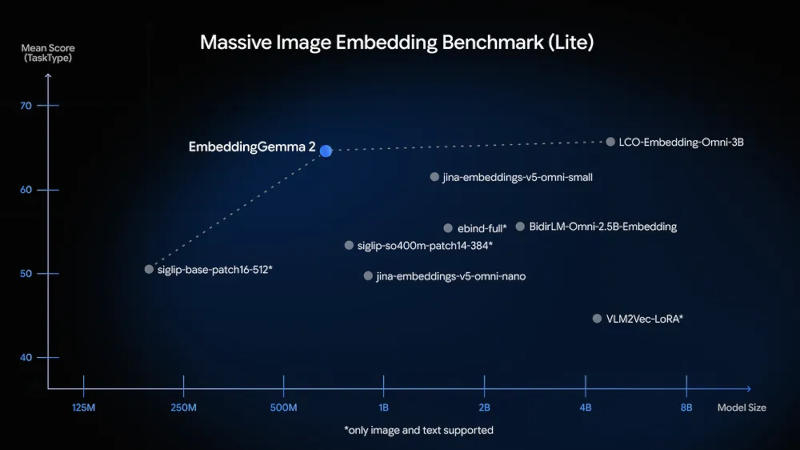
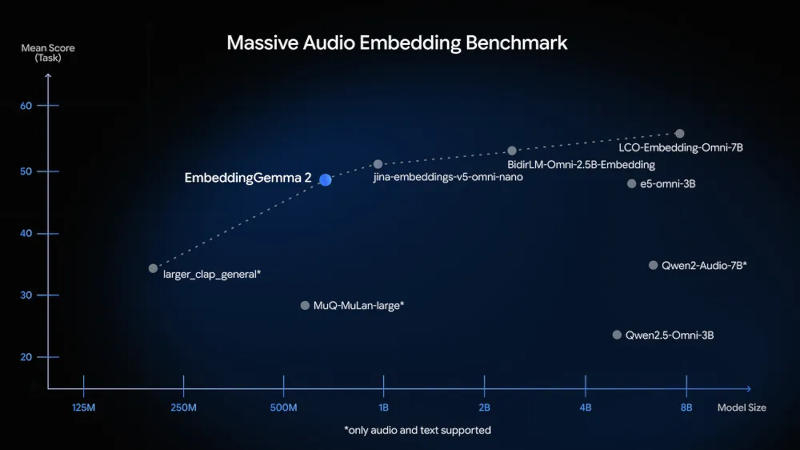
В профильных тестах MTEB (Massive Text Embedding Benchmark) для кода и MAEB (Massive Audio Embedding Benchmark), утверждает разработчик, она продемонстрировала лучшие результаты для моделей размером до 1 млрд параметров. EmbeddingGemma 2 не уступает, а то и превосходит гораздо более крупные модели в задачах работы с текстом, изображениями и звуком.
Одной из отличительных особенностей модели является её модульная архитектура: для задач, связанных только с текстом, ей требуются всего 270 млн параметров; для мультимодальных функций и обработки изображений потребуется подключить кодировщики размером ещё 170 млн параметров; для аудио — ещё 300 млн параметров. За счёт технологии Matryoshka Representation Learning (MRL) разработчики могут динамически сокращать размерность выходных векторов с 768 до 512, 256 или 128 элементов — можно на величину до шести раз сократить занимаемый векторными базами данных объём памяти.
EmbeddingGemma 2 эффективно работает даже в условиях жёстких ограничений ресурсов. В тестах на Pixel 11 Pro квантование помогло модели занять всего 191 Мбайт оперативной памяти для весов, отвечающих только за текст; в мультимодальном варианте — около 567 Мбайт. По сравнению с моделью первого поколения новая сохранила высокую эффективность в работе с многоязычным текстом; в бенчмарке MTEB Code она повысила результат с 68,76 до 78,68 балла. Это значит, что она хорошо подходит для задач индексирования кодовой базы и задач поиска информации для пишущих код ИИ-агентов. Локальная работа на устройствах обеспечивает пользователям конфиденциальность данных.
В сочетании со «старшей» Gemma 4 служебная EmbeddingGemma 2 позволяет реализовать на устройстве конвейеры RAG (Retrieval-Augmented Generation) — учитывая, что у обеих моделей один токенизатор и аудиокодировщик, они могут работать в единой среде с меньшим суммарным потреблением памяти. Веса моделей доступны на платформах Hugging Face и Kaggle; вскоре они появятся на Gemini Enterprise Agent Platform. EmbeddingGemma 2 запускается и встраивается при помощи стандартных средств, включая transformers, llama.cpp, Ollama, LM Studio и другие.
Источник:


