


Опрос
|
реклама
Быстрый переход
До 32 768 ядер Zen 6 в одной системе: AMD представила эталонную стойку Helion для автономных ИИ-агентов
12.10.2026 [18:28],
Сергей Сурабекянц
Компания AMD внедряет в экосистему ЦОД новое эталонное решение стоечного типа. Helion — это стандартизированный проект 21-дюймовой стойки, дополняющий стойку Helios, которую AMD представила в прошлом году на OCP Global Summit. По словам AMD, новая Helion может вмещать до 32 768 ядер Zen 6 в конфигурации, использующей только центральные процессоры благодаря высокой плотности компоновки 256-ядерных чипов EPYC 9996 Venice. 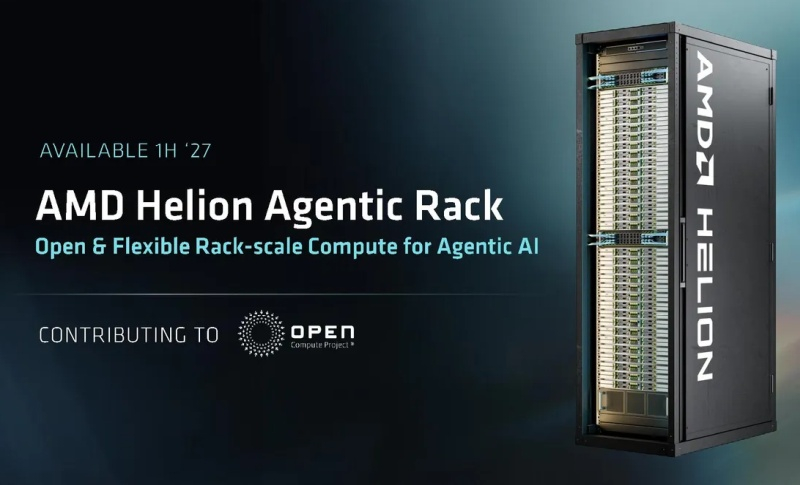
Источник изображений: AMD Конструкция стойки Helion стандартизирована и базируется на спецификации ORv4 (Open Compute Project). Она отличается от стандартных стоек увеличенными шириной и высотой. Helion рассчитана на размещение 44 модулей (лотков) формата OpenU шириной 21 мм и высотой 48 мм, что несколько больше параметров стандартного модуля EA1-310. Эталонный проект поддерживает как воздушное охлаждение, так и системы прямого жидкостного отвода тепла. Конструкция Helion соответствует стандарту OCP DC-MHS (Data Center Modular Hardware System). По данным OCP, стандарт MHS призван обеспечить «совместимость ключевых элементов инфраструктуры центров обработки данных, периферийных вычислений и корпоративных систем». 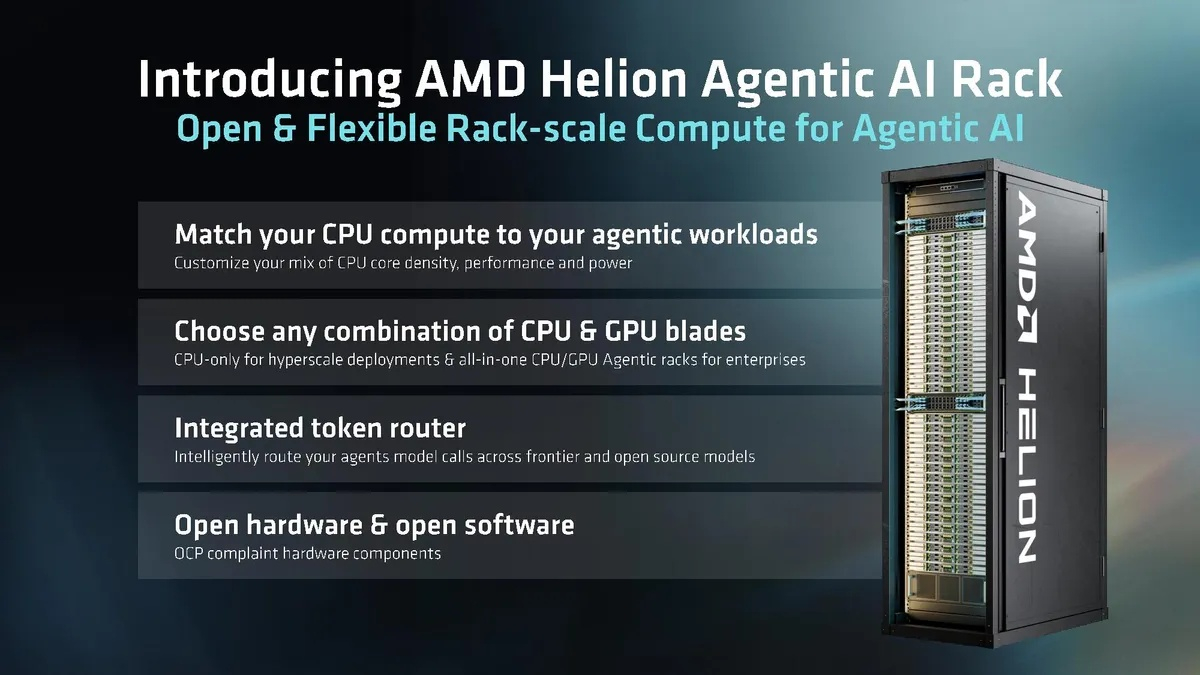 Хотя AMD подготовила визуализации проекта, сама компания не будет продавать готовые стойки. Это эталонный проект, который AMD передаёт сообществу OCP, а на рынок его выведут OEM- и ODM-производители. Глава AMD Лиза Су (Lisa Su) объявит список партнёров позднее, во время основного доклада на саммите OCP Global Summit. AMD не назвала компании, которые будут заниматься внедрением системы, однако намекнула, что заказчики Helios, вероятно, будут использовать и стойки Helion. В отличие от Helios, созданной для обучения ИИ и выполнения задач инференса (вывода), Helion представляет собой более гибкое стоечное решение, ориентированное прежде всего на использование центральных процессоров. В конфигурации, использующей только центральные процессоры (CPU), система может вмещать до 128 процессоров EPYC 9996, обеспечивая впечатляющее общее количество ядер — 32 768 на одну стойку. Подобная компоновка, вероятно, будет напоминать «песочницу» для работы ИИ-агентов, подключённую к системе инференса. 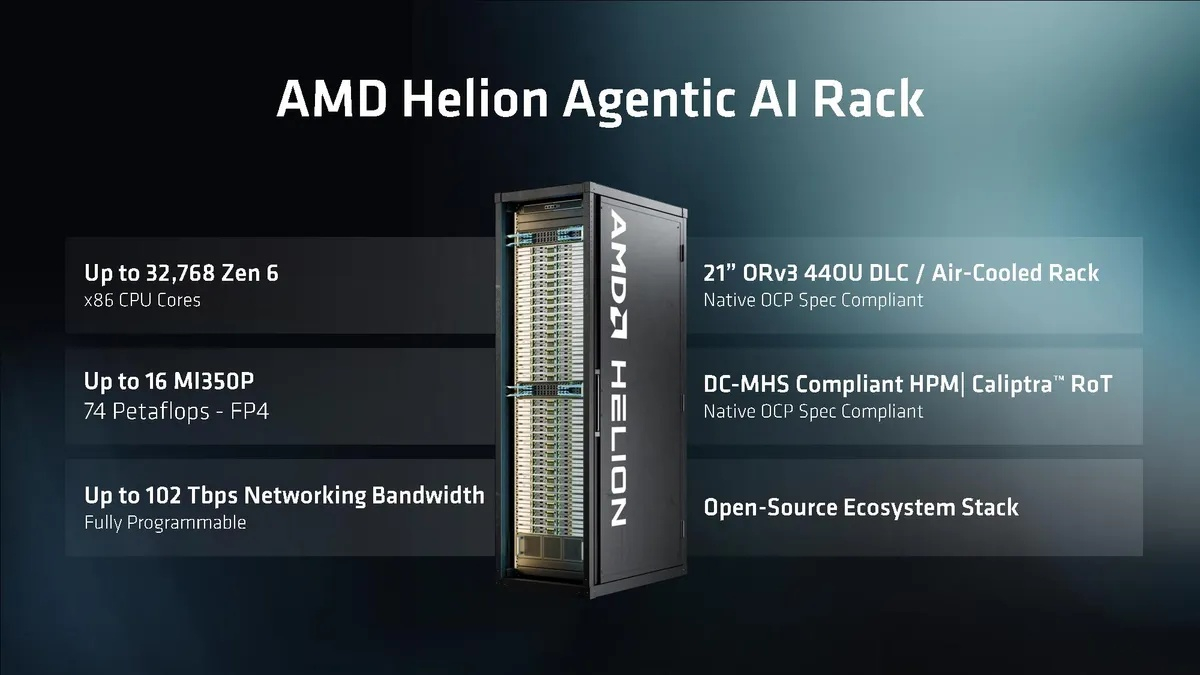 Такая модель организации работы персональных ИИ-агентов уже применяется сегодня — например, в проектах Meta✴✴ Muse и OpenAI Dots. У каждого пользователя есть изолированная среда («песочница»), использующая часть вычислительных ресурсов хост-системы, которая опирается на сервер для выполнения инференса. Часть задач — например, компиляция программного обеспечения — выполняется на этих серверах с CPU, тогда как ресурсоёмкие операции ИИ-инференса происходят на других мощностях. Предположительно, именно на эту модель ориентируется AMD при разработке системы Helion, учитывая, что гиперскейлеры наращивают вычислительные мощности CPU для поддержки ИИ-агентов. В то же время архитектура решения отличается гибкостью: она поддерживает установку до 16 графических процессоров (GPU) MI350P и обеспечивает пропускную способность сети до 102 Тбит/с, хотя и за счёт сокращения количества центральных процессоров. По заявлению AMD, эта гибридная конфигурация предназначена для корпоративного сектора и представляет собой универсальное решение «всё в одном», объединяющее функции управления данными, сетевого взаимодействия и работы с ИИ. 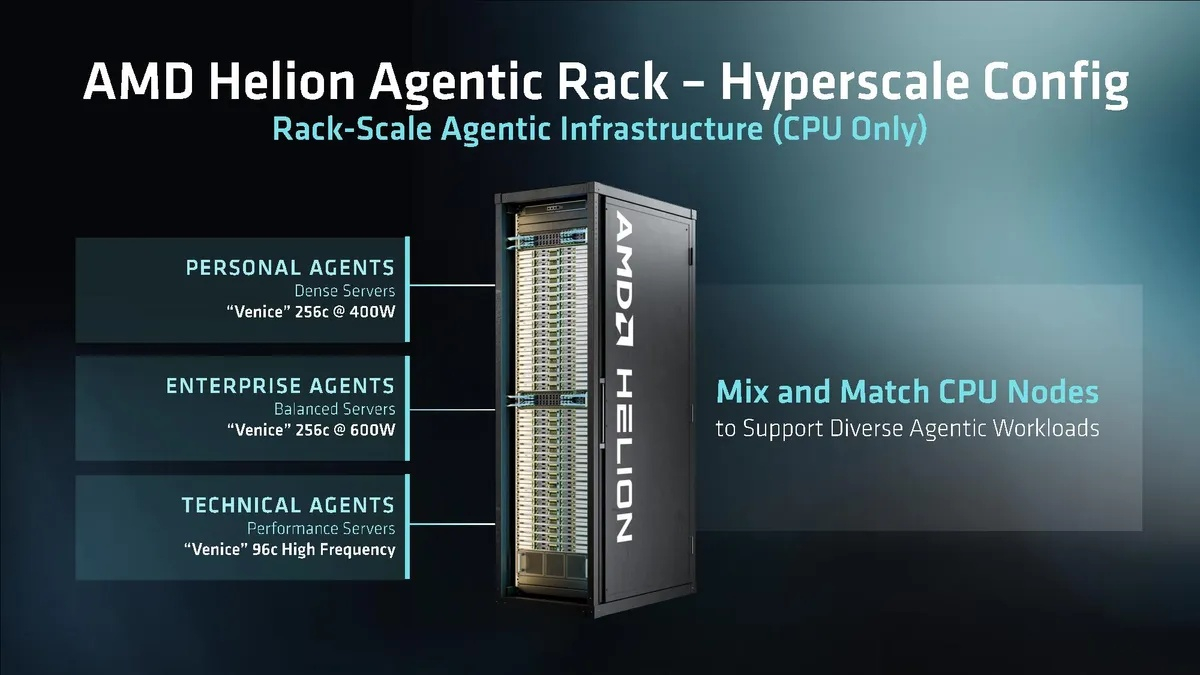 В соответствии с планами AMD, стойки Helion станут доступны в первой половине 2027 года. Их выпуск, вероятно, совпадёт с периодом активного внедрения процессоров на базе архитектуры Zen 6, массовое развёртывание которых ожидается уже в конце текущего года. За шесть лет производительность стоечных решений AMD возрастёт в двадцать раз
18.08.2026 [22:54],
Сергей Сурабекянц
В дополнение к обычным планам развития продуктов и технологий, AMD в 2025 году представила инициативу «20x2030», которая обещала увеличить энергоэффективность стоечных решений для ИИ в 20 раз к 2030 году. AMD исходила из предположения, что её стоечные системы 2026 года будут в три раза производительнее, чем поколение 2024 года. На практике, они оказались эффективнее в четыре раза, что позволяет рассчитывать на перевыполнение планов AMD к 2030 году. 
Источник изображения: AMD Стоит оговориться, что AMD оценивает свой прогресс на уровне стоек, а не на уровне процессоров и ускорителей ИИ, что, очевидно, даёт компании большую свободу в оптимизации производительности. Компания учитывает улучшения в вычислительной производительности, технологическом процессе, пропускной способности памяти, перемещении данных, интерконнектах, программном обеспечении и совместном проектировании на системном уровне. По словам AMD, три основные характеристики оборудования определяют производительность системы ИИ: вычислительные возможности, пропускная способность памяти и пропускная способность интерконнекта. Новые технологические процессы и архитектуры повышают производительность вычислений с плавающей запятой на ватт, а улучшения в интеграции памяти и высокоскоростные интерконнекты увеличивают пропускную способность, доступную чипам. AMD ожидает, что эти разработки в совокупности обеспечат в 20 раз более высокую производительность ИИ на ватт к 2030 году по сравнению с базовым показателем 2024 года. Память и интерконнекты играют особенно важную роль, поскольку современные системы ИИ, как правило, перемещают огромные объёмы данных. AMD заявляет, что более высокая пропускная способность памяти, большая плотность полосы пропускания, улучшенная пропускная способность на ватт, большие кеши и более тесная интеграция памяти и вычислительных ресурсов могут снизить потери энергии и повысить эффективность работы. Более быстрые масштабируемые интерконнекты могут улучшить связь между ускорителями, центральными процессорами и другими компонентами, что также повышает эффективность работы. Оптимизация ПО AMD — ещё одна часть усилий, поскольку более высокая производительность, достигаемая благодаря оптимизации, в конечном итоге означает меньшее энергопотребление, необходимое для достижения ожидаемого результата. Четырёхкратное улучшение энергоэффективности (и, соответственно, производительности) следует рассматривать как оценку AMD, а не как прямое сравнение двух коммерчески доступных стоечных систем. AMD измеряет прогресс, сравнивая ежегодные репрезентативные стоечные конфигурации с базовым уровнем 2024 года, используя методологию расчёта производительности на ватт. Кроме того, в расчёте на 2026 год используются данные измерений реальных продуктов и результаты моделирования в тех случаях, когда окончательные показатели производительности были недоступны, что, по сути, означает, что AMD не использует свои новейшие ускорители Instinct MI455X для этих оценок. В случае успеха инициативы «20x2030» две будущие стойки AMD 2030 года смогут обеспечить тот же объем вычислительных ресурсов, что и 570 стоек 2024 года на базе процессора Instinct MI300X. Это, по сути, означает в 20 раз меньшее энергопотребление или в 20 раз более высокую производительность при том же энергопотреблении к 2030 году. Память в серверах Nvidia подорожала на 435 % при переходе от Blackwell к Vera Rubin — стойку оценили в $7,8 млн
22.05.2026 [12:18],
Павел Котов
Одна серверная стойка Nvidia VR200 NVL72 нового поколения на архитектуре Vera Rubin обойдётся облачному оператору примерно в $7,8 млн, подчитали в Morgan Stanley. Для сравнения, GB300 NVL72 стоит около $4 млн. Стойка нового поколения VR200 NVL72 содержит больше DRAM и NAND — на память приходятся около 25 % общей стоимости. 
Источник изображения: Nvidia В корпусах VR200 NVL72 компания Nvidia намеревается продавать процессоры Vera по $5000 и ускорители искусственного интеллекта Rubin по $55 000 за штуку. В стойках используются уже знакомые клиентам корпуса Oberon, но внутри установлены более сложные компоненты коммутации, сетевых подключений, печатные платы, системы охлаждения, изменились даже технологии упаковки чипов — всё это влияет на стоимость систем и складывается в ценник $7,8 млн за стойку. Только компоненты памяти в стойке VR200 NVL72 обходятся около $2 млн или на 435 % больше, чем в GB300 NVL72. 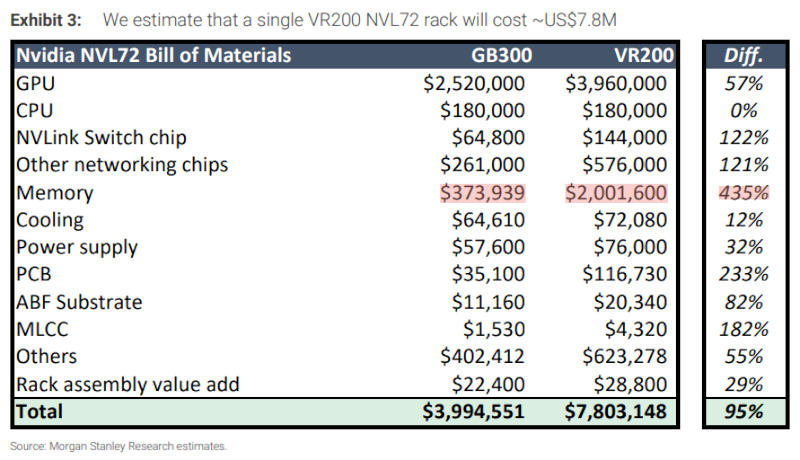
Источник изображения: x.com/Aaronwei3n На каждую стойку нового поколения приходятся 54 Тбайт памяти LPDDR5X — втрое больше, чем 17 Тбайт у GB200 NVL72. Nvidia, по оценкам SemiAnalysis, в I квартале платила по $8 за 1 Гбайт LPDDR5X, и дальше этот показатель может только вырасти, особенно если речь идёт о дорогих в производстве и тестировании модулях SOCAMM2. Таким образом, память для GB200 NVL72 обходится в $136 000 на каждую машину; в случае VR200 NVL72 это уже $408 000, а при росте цены до $10 за 1 Гбайт это будут уже $540 000 — даже без учёта наценки самой Nvidia. Кроме того, в каждой стойке VR200 NVL72 содержится память 3D NAND на сумму не менее $1 млн, тогда как в GB200 NVL72 её практически не было. В результате $2 млн за память на стойку Vera Rubin NVL72 представляется вполне предсказуемым показателем: здесь есть большие объёмы LPDDR5X и 3D NAND, не говоря уже о высокоскоростной HBM4 на самих ускорителях Rubin — и это в условиях дефицита и колоссальных цен на чипы памяти. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018







