


 MWC 2018
 2018
 Computex
 IFA 2018
⇣ Содержание
Опрос
|
реклама
Самое интересное в новостях
Мастерская локальных ИИ: первый подход к FLUX 3 Image Klein
Октябрьский анонс новинки FLUX 3 Image Klein от тех же самых разработчиков из германской Black Forest Labs (BFL), что и прежде радовала энтузиастов локальной генерации картинок своими продуктами, не прошёл незамеченным. Да, модель по объёму весьма субтильна, но правило «крупнее — значит лучше» в этом сегменте ИИ-приложений потеряло актуальность после того, как почти год назад Z Image Turbo наглядно продемонстрировала, что и весьма компактная по числу параметров нейросеть способна на равных тягаться с признанными лидерами T2I-сцены (text to image; генеративное преобразование текстовых подсказок в статичные картинки). FLUX 3 Image Klein льёт воду на ту же мельницу: достаточно взглянуть на её заявленные характеристики. Всего-то 5,6 млрд параметров — но выдача готовой картинки без апскейла в разрешении вплоть до 4К (2048×2048 точек) и сокращённое до 16 число шагов генерации для дистиллированной версии (с параметром CFG = 1). А ещё — готовность не только рисовать по текстовой подсказке, но и редактировать изображения; вплоть до точной расстановки объектов (представленных в виде загруженных, заранее подготовленных картинок) на строго определённые позиции в кадре. Кстати, именно описанный вариант с 16 шагами и CFG = 1 и называется просто Klein. Вместе с ней доступна и исходная FLUX 3 Image Klein Base — ровно с тем же числом параметров, но без фиксации CFG; количество шагов генерации здесь рекомендуется увеличивать до полусотни минимум. Впрочем, базовый вариант Klein для потокового инференса картинок, строго говоря, и не нужен: он потребуется тем, кто захочет, к примеру, натренировать на основе новой модели специфические LoRA. 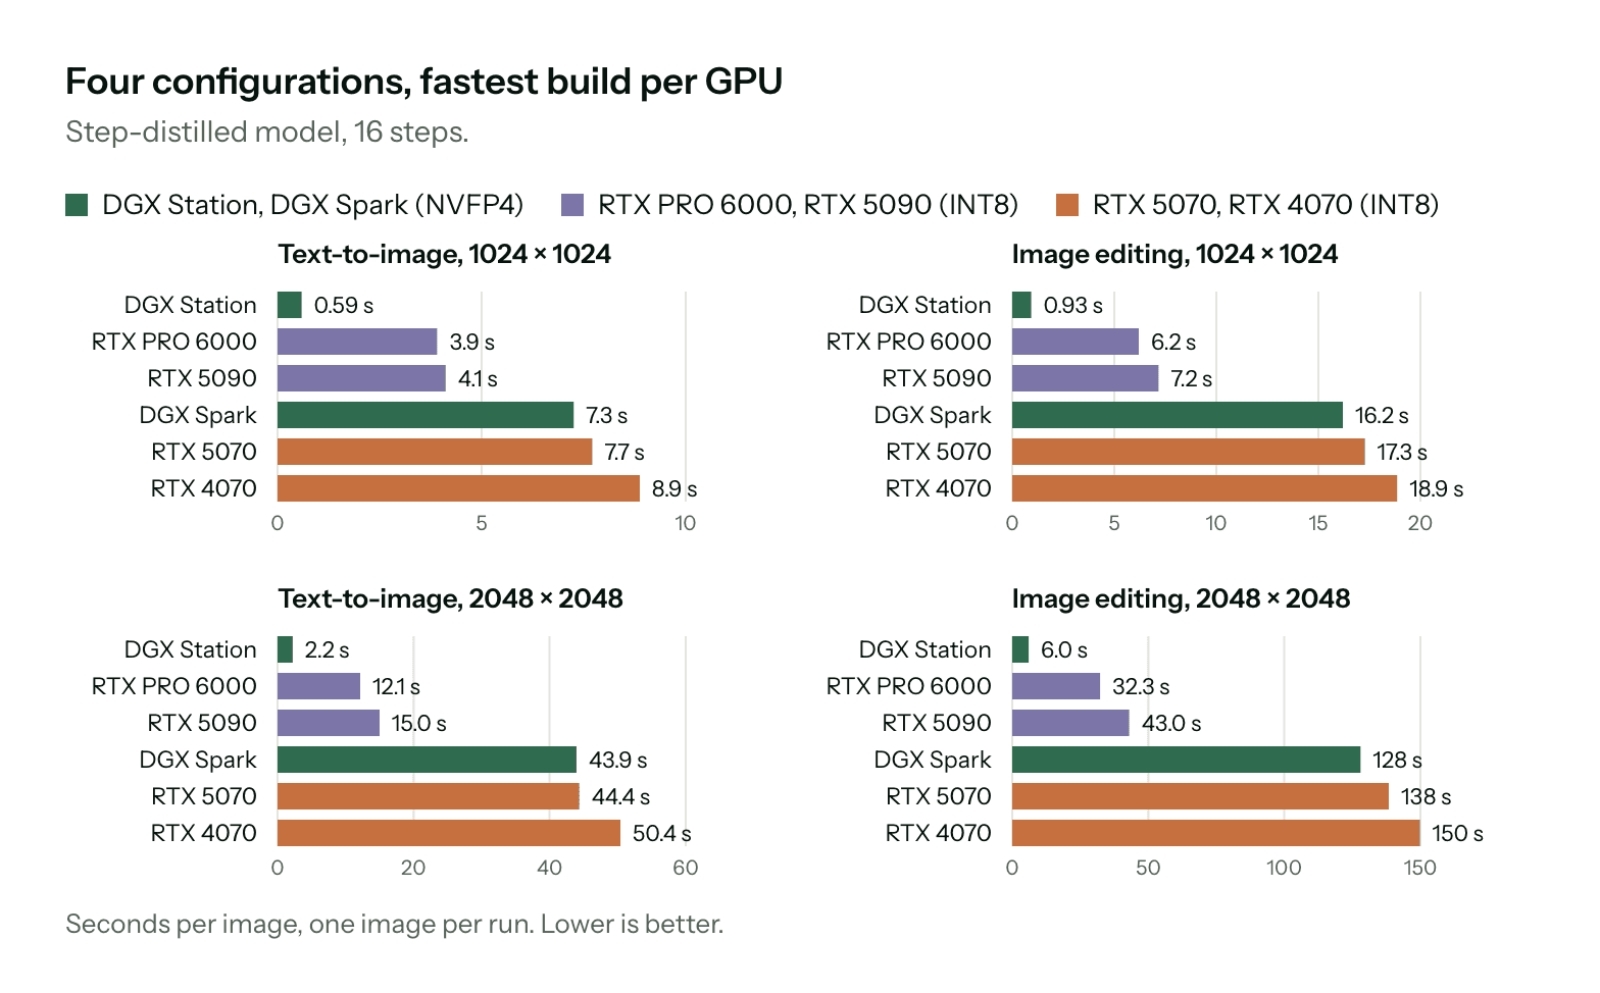
На RTX 4070 картинку в 4 Мпикс дистиллированная версия FLUX 3 Image Klein будет выпекать примерно с минуту. На нашей картофелИИне — чуть подольше, конечно (источник: BFL) В BFL также не без гордости отмечают, что применили для тренировки FLUX 3 Image Klein свежую систему Self-Flow, разработанную совместно с Массачусетским технологическим институтом. Система эта самостоятельно сопоставляет потоки данных, реализуя парадигму их самоконтролируемого взаимосогласования (self-supervised flow matching framework). В итоге модель, по словам исследователей, «изучает представления путём увязывания мультимодальной генерации с пониманием воспроизводимых концепций в рамках единой архитектуры». Имеется в виду, что базовую версию FLUX 3 обучали не только на картинках, но и на натурных видео (со звуком, кстати; для получения статичных картинок это не актуально, а вот на перспективу, для ИИ-генерации роликов сразу с аудиодорожками, — очень даже). Такой подход позволил зафиксировать в весах нейросети физически корректные причинно-следственные связи между взаимодействующими объектами — и тем самым значительно улучшить пространственную и временную достоверность полученных изображений по сравнению с моделями, которые тренировали только на наборах аннотированных статичных картинок. Важная оговорка: официальное сообщение о выпуске FLUX 3 Image Klein прямо подчёркивает, что 5,6 млрд параметров — это характеристика только ключевого блока модели, который извлекает из глубин латентного пространства — забрасывая в то на манер удочки цепочку входных токенов — готовое изображение. А вот чтобы эту самую цепочку получить, требуется отдельная модель, перекодировщик текста. В её качестве рекомендовано использовать Qwen3-VL-4B-Instruct, творение команды разработчиков из, внезапно, китайской Alibaba Cloud. Ну-ка, что там нудят пессимисты о стремительной деглобализации ИТ-(а заодно и ИИ-)индустрии? У этой модели насчитывается 4,4 млрд параметров; она и по сей день (с момента своего появления в октябре 2025-го) — наиболее мощный в своём классе представитель семейства Qwen. Очень здорово, конечно, — только выходит, что для преобразования текста в изображение при помощи FLUX 3 Image Klein придётся пропускать подсказку для начала через две нейросети: на 4,4 млрд и на 5,6 млрд параметров. Будет ещё и третья — правда, совсем крохотная, примерно на 300 млн параметров. Чтобы перекодировать скрытое изображение, выловленное из латентного пространства, в доступное для восприятия кожаных мешков представление (упорядоченный набор RGB-пикселов), потребуется вариационный перекодировщик, VAE (variational autoencoder). В Black Forest Labs не стали возиться с созданием нового специально для третьей версии FLUX — и рекомендуют применять flux2-vae.safetensors, разработанный ими же ещё для семейства Flux 2. 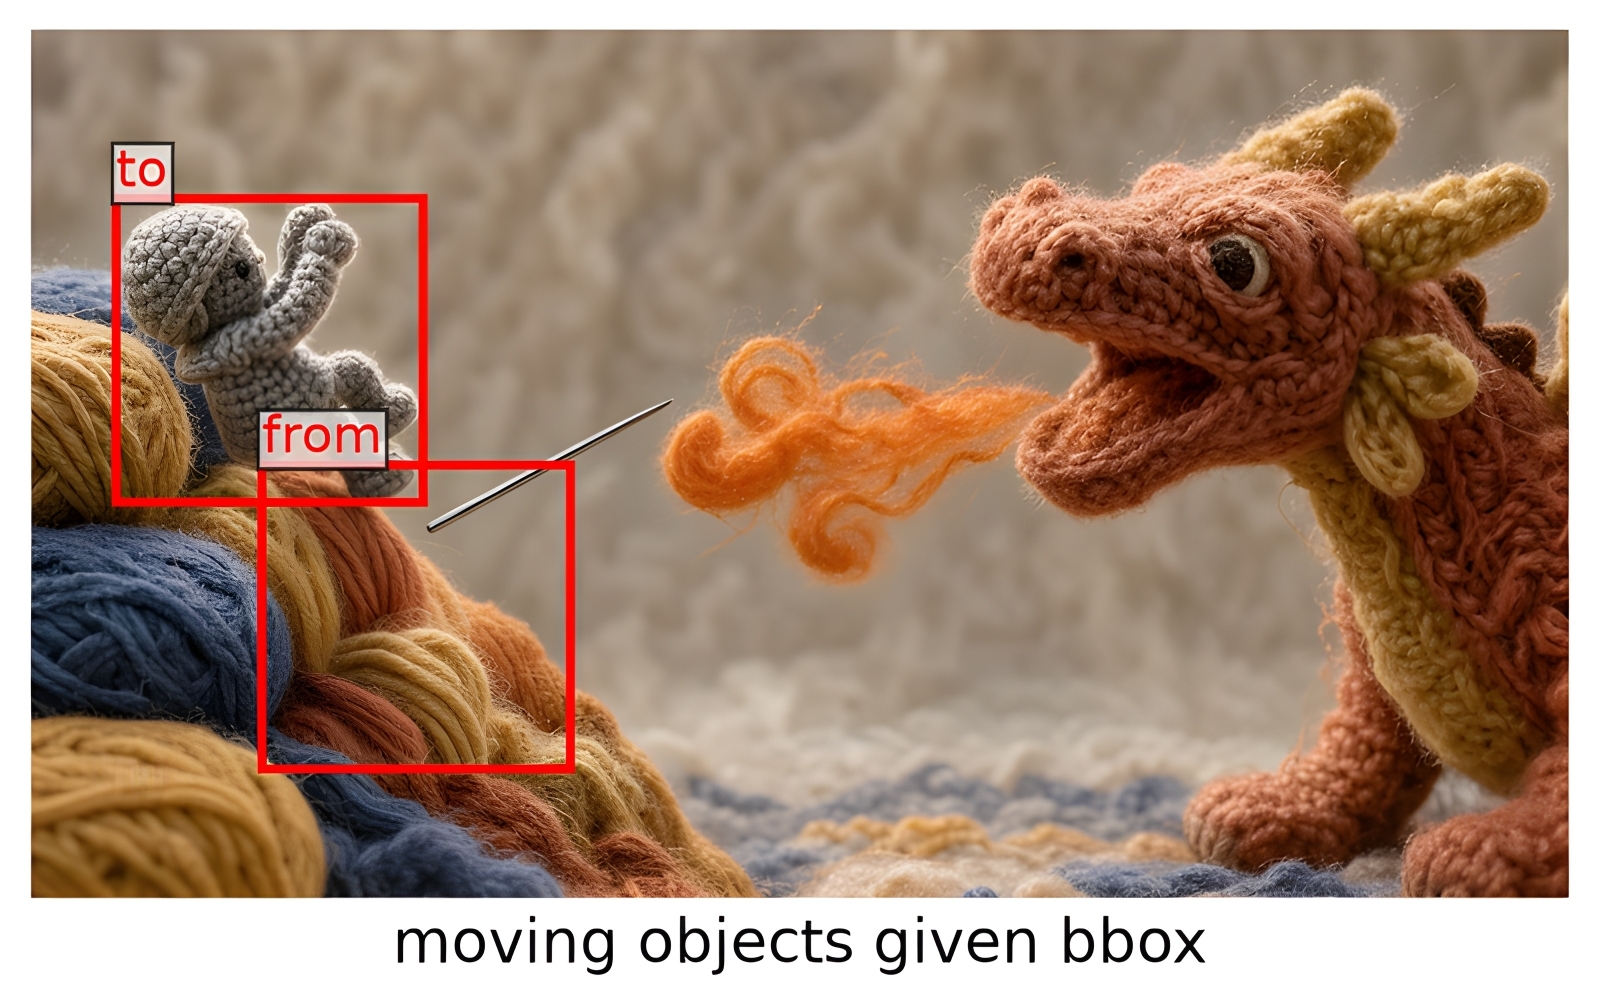
Подлинная сила FLUX 3 Image Klein таится в её способностях к редактированию изображений — вот как показано на этом примере: достаточно просто обвести объект рамочкой и указать для него новое место в кадре. Но чтобы до этого этапа добраться, необходимо всё же сперва выяснить, как модель в принципе работает (источник: BFL) Тем не менее, даже если полный размер готовой к использованию локально FLUX 3 Image Klein чуть превосходит 10 млрд параметров, это не отменяет того факта, что все три составляющие её нейросети будут загружаться в видеопамять по отдельности. А значит, знакомой завсегдатаям нашей «Мастерской» ИИспытательной картофелины — Core 7 i2-2700K, 24 Гбайт ОЗУ DDR3-1333, GeForce 1070 на 8 Гбайт — уж точно должно хватить для сравнительно быстрой генерации картинок с этой моделью. Ведь и преобразователь текста в токены, и корневой блок формирования картинки, и тем более VAE будут поочерёдно помещаться в 8 Гбайт видеопамяти целиком, не выплёскиваясь в куда более медлительное общее ОЗУ. В общем, серьёзная заявка на успех; пора разобраться, что тут и как! ⇡#Минуточку!Сперва подготовим рабочую среду к запуску новой модели. ComfyUI — а мы уже не раз рассказывали, откуда её брать и как развёртывать, — для работы с FLUX 3 Image Klein должна быть не младше версии 0.41.0. Проверить номер версии, если она устанавливалась давно, всегда можно в менеджере пакетов — и там же отдать команду на обновление рабочей среды, если потребуется. 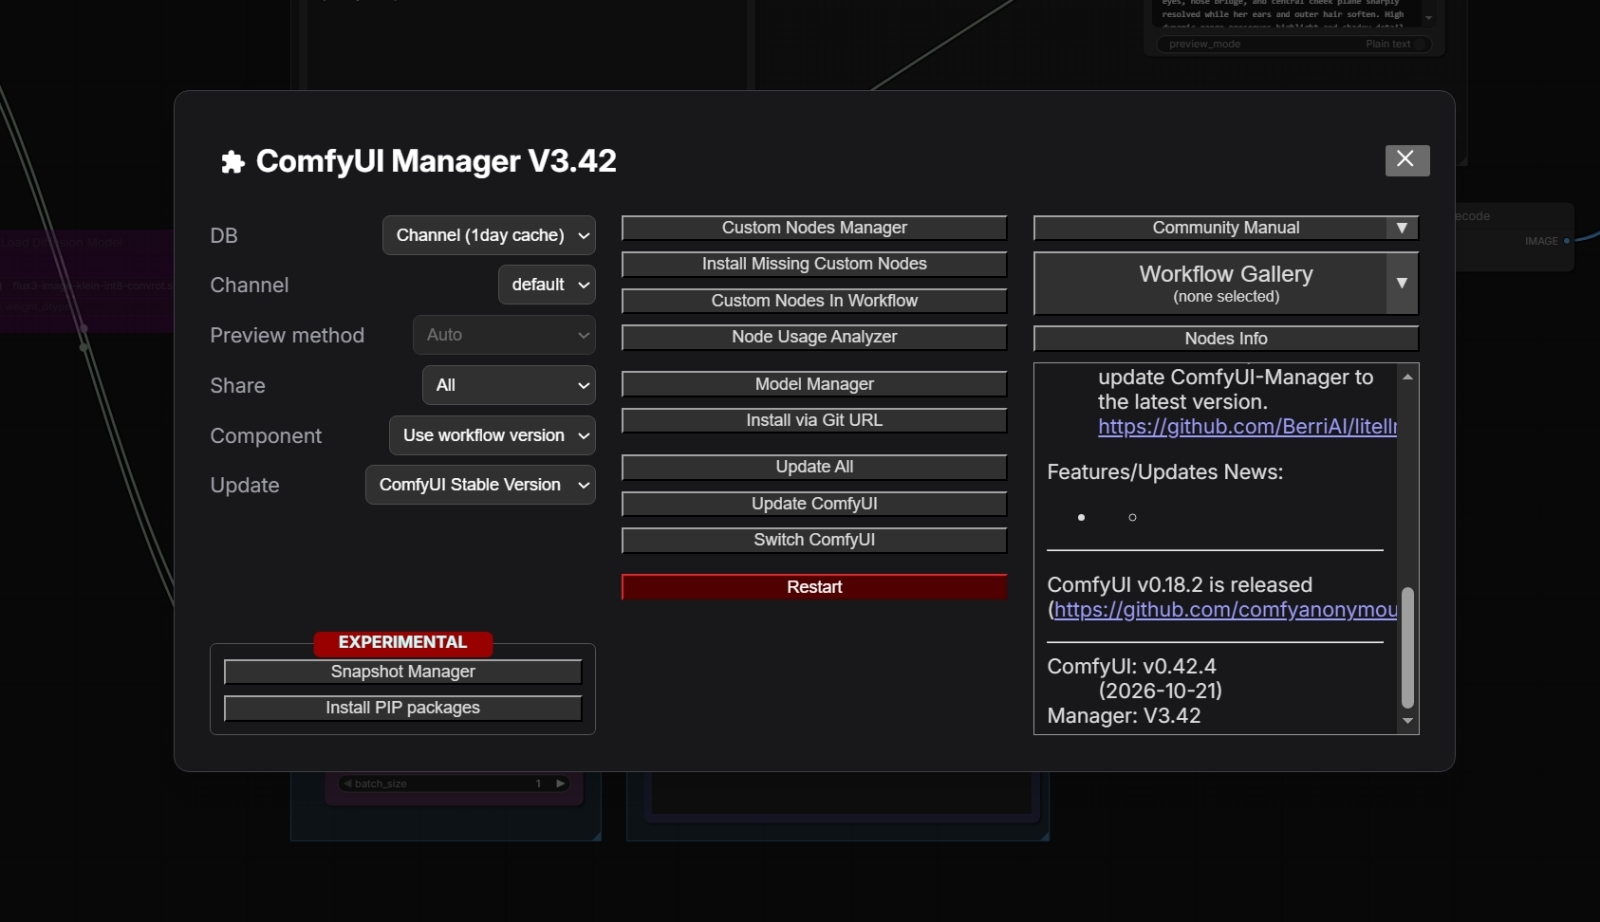
Справа в информационном окошке ComfyUI Manager, если прокрутить его вниз до конца, виден номер текущей версии; слева есть кнопка для обновления Дальше логично будет припасть к истоку и скачать все необходимые файлы прямо из официального репозитория BFL на Hugging Face (впрочем, доступны они и на CivitAI, и на других платформах), — однако уж здесь всё перестаёт быть так просто, как могло показаться с самого начала. Прямо в описании модели на странице репозитория непринуждённо упоминается ещё одна дополнительная нейросеть, в отсутствие которой настоятельно не рекомендовано запускать FLUX 3 Image Klein, а именно — FLUX 3 Image Klein Prompt Upsampler. На платформе последняя размещена под игривым именем flux3-image-klein-pup (pup — «щеночек»; остроумное сокращение для promp upsampler, признаём), но, судя по размерам, о чём подробно мы скажем чуть позже, щеночек этот — мастифа или алабая, не меньше. 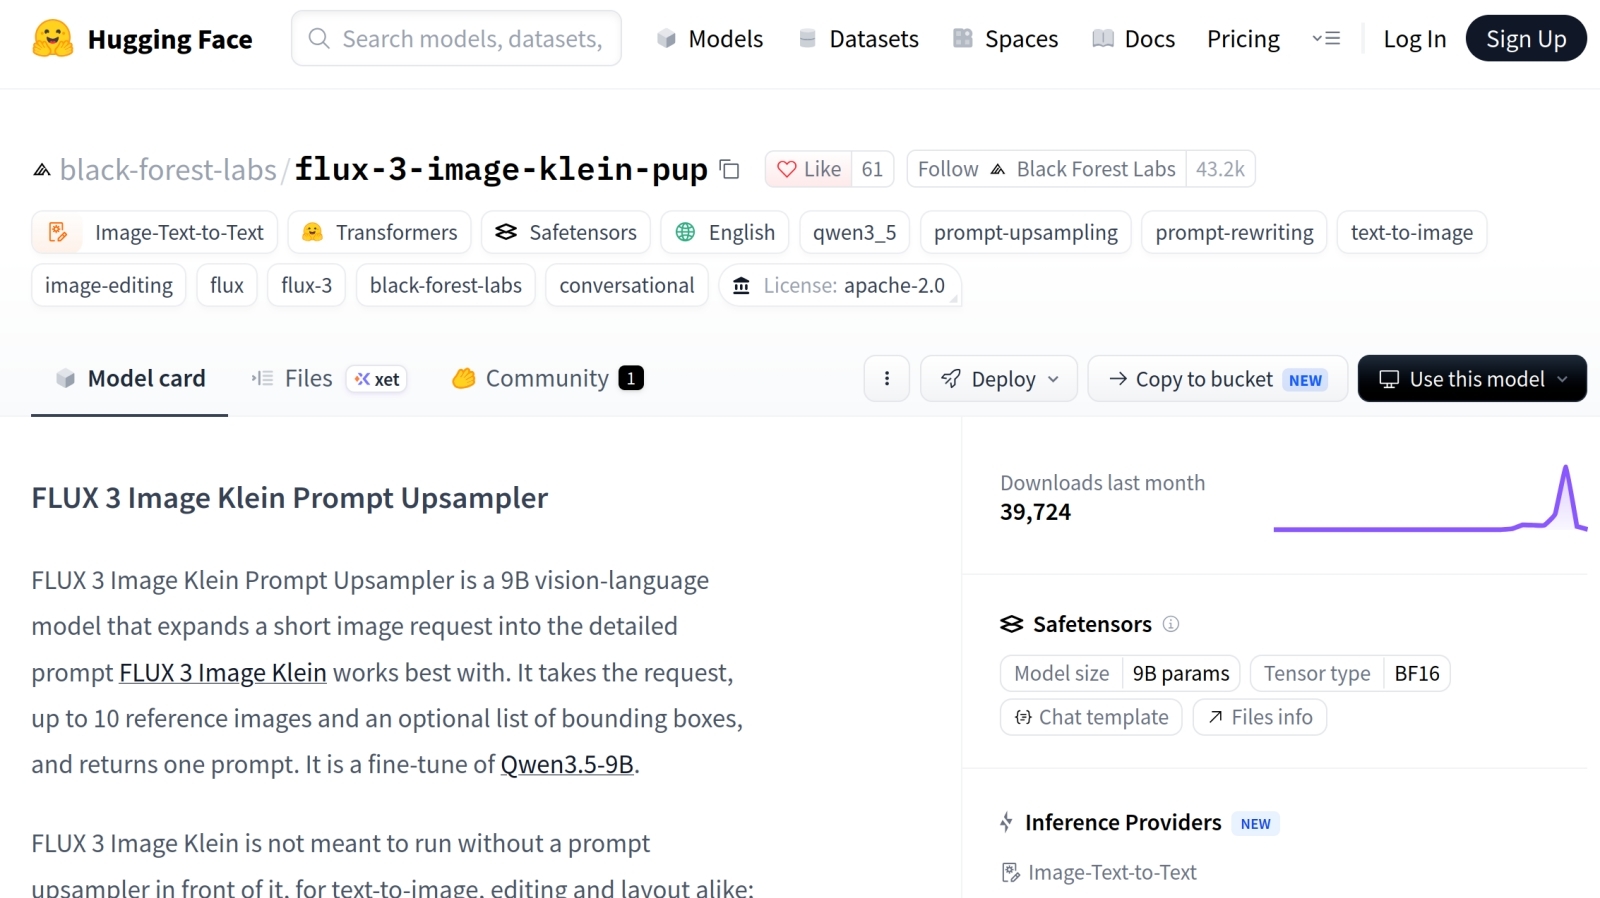
Источник: скриншот сайта Hugging Face С подобными «улучшайзерами подсказок» каждый энтузиаст ИИ-рисования наверняка сталкивался на профильных веб-сайтах вроде того же CivitAI; там они называются обычно «prompt enhancer» и активируются установкой галочки в соответствующее поле перед отдачей команды на онлайновую генерацию изображения. Суть в следующем: современные T2I-модели плоховато работают с короткими, бедными на детали подсказками, хотя Stable Diffusuion 1.5 и её ровесницы выдавали, бывало, просто-таки шедевры (для своего времени, конечно), получая для затравки даже одно-единственное слово. Просто те модели обучались на массивах аннотированных (снабжённых лапидарными тегами «1girl, masterpiece, by Greg Rutkowsky» и т. д.) картинок, более или менее тщательно отобранных. Это позволяло без дополнительных усилий (сверх самого подбора и разметки тренировочных изображений) связывать определённые ключевые слова с визуально заведомо привлекательной композицией и иными трудно формализуемыми художественными характеристиками картинки, по сути неявно внедряя на уровень сформированных у модели весов высокие эстетические критерии. Но начиная примерно с SDXL и первой версии FLUX T2I-модели стали тренировать на изображениях с подписями на естественном языке. Это было связано, в частности, с привлечением внешних перекодировщиков текста в токены — сперва более простых, чем Qwen3-VL-4B-Instruct, конечно, — способных извлекать из подсказки семантические связи и контекст. Всё это, конечно, прекрасно, но рядовой пользователь ленив: он по-прежнему хочет получать на основе подсказки «1girl» изображение уровня ну хотя бы «Джоконды». По этой, видимо, причине разработчики из BFL прямо говорят в описании своего (точнее будет сказать, «обогатителя», — в том же смысле, в каком руду обогащают перед выплавкой из неё металла) FLUX 3 Image Klein Prompt Upsampler: «FLUX 3 Image Klein не предназначена для работы в отсутствие обогащения исходной подсказки; это касается как преобразования текста в картинку, так и редактирования, и рисования по заданному шаблону». 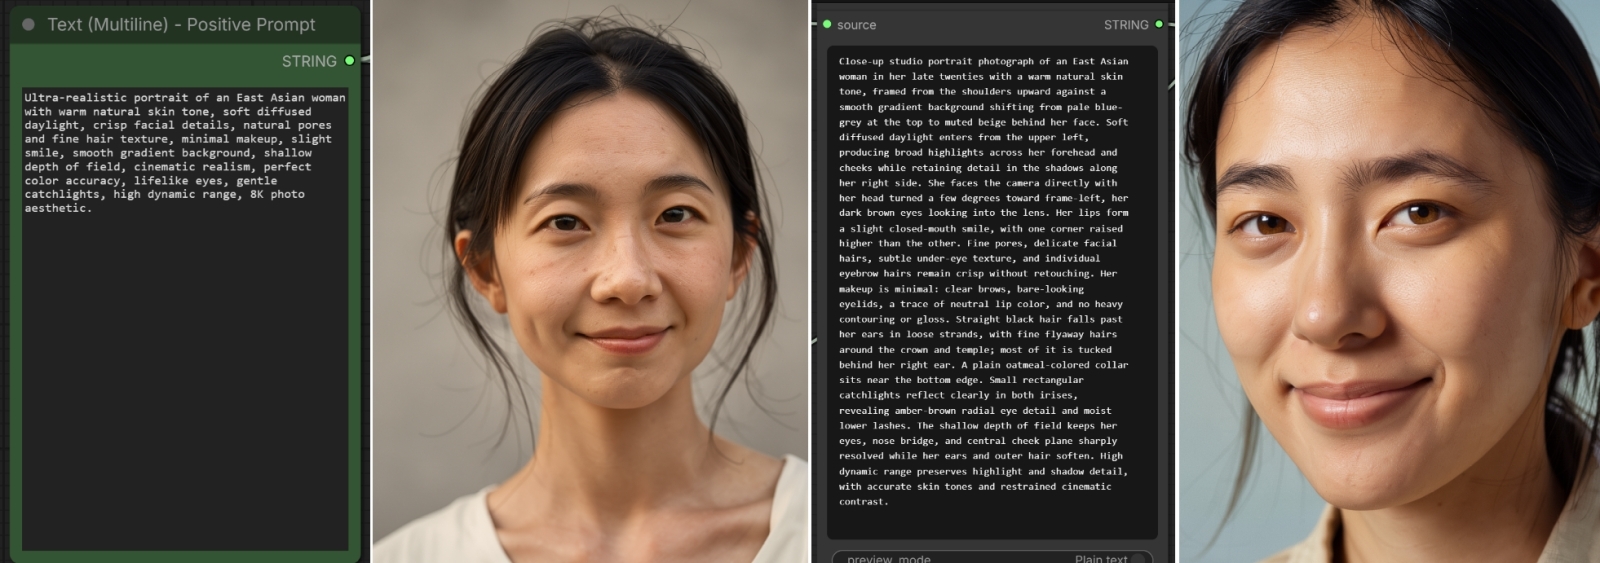
Слева — короткая подсказка для FLUX 3 Image Klein; далее — сгенерированная по ней напрямую (минуя Prompt Upsampler) картинка; затем — то, что получилось из исходной подсказки после пропускания через обогатитель; финал — изображение, созданное с тою же самой затравкой (seed), но уже по обогащённой подсказке Небольшая тонкость: FLUX 3 Image Klein Prompt Upsampler — это особым образом дотренированный клон Qwen3.5-9B, то бишь ещё одна обособленная (и внешняя по отношению к BFL) моделька на 9 млрд параметров (ничего себе щеночек!) Итого фактически исполняемый на локальном ПК размер FLUX 3 Image Klein раздувается уже примерно до 20 млрд параметров, причём обогатитель в исходном своём виде — без предварительной компактификации с применением GGUF или иного схожего метода — в 8 Гбайт видеоОЗУ уже совершенно точно не лезет. Здесь, собственно, можно было бы и распрощаться с надеждой превратить нашу боевую картофелИИну в скоростной генератор (и, главное, редактор, — именно способности FLUX 3 Image Klein к редактированию заворожили изначально энтузиастов локального ИИ-рисования) высококачественных изображений. Забегая вперёд, засвидетельствуем: после загрузки в обновлённую до версии 0.42.4 рабочую среду файла с модельной T2I-циклограммой, закачки всех необходимых для её работы нейросетей (суммарный объём — 20,3 Гбайт) и отправки задачи на исполнение, результат — картинку на 1,5 Мпикс, 1088×1472 — мы получили через полтора часа (1:33:48, чисто для протокола). Klein 2 Turbo изображение на 2,5 Мпикс на той же картофелИИне и в той же версии ComfyUI генерирует примерно за полчаса — от 28 до 35 минут. 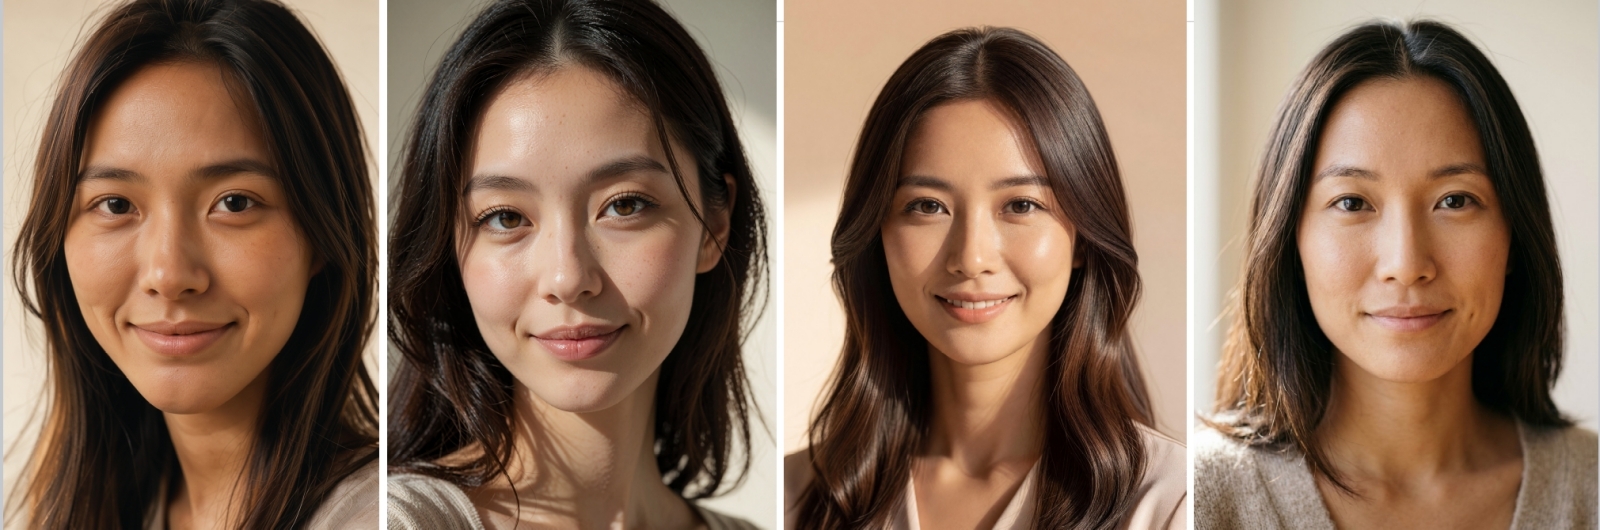
Слева направо — генерации по одной и той же обогащённой (с применением FLUX 3 Image Klein Prompt Upsampler) подсказки моделями: самою FLUX 3 Image Klein, Klein 2 Turbo, Grok Imagine v.1.5, Google Nano Banana 2.1 Казалось бы, самое время свернуть не начатое толком исследование и признать провал BFL с FLUX 3 Image Klein. Недаром энтузиасты вовсю критикуют её онлайн за слишком часто проявляющиеся неестественность человеческой анатомии, «пластиковость» кожи, да и в целом за сниженный уровень общеэстетических стандартов — чистая вкусовщина, конечно, но если сопоставлять картинки десятками, начинаешь понимать, что тут имеется в виду. Из локальных моделей новинке от BLF предпочитают упомянутую уже Klein 2 Turbo и Qwen Image 2.1 (которая тоже, кстати, предусматривает редактирование с предварительной загрузкой до 10 картинок), а из облачных — едва ли не все подряд из тех, что стали доступны за последний примерно год (в том числе и бесплатно; с понятными ограничениями на число генераций за определённый интервал времени). Так что же — расходимся, не на что тут смотреть? ⇡#Терпение и трудОтринем всё-таки предвзятость и будем двигаться последовательно. Для начала запустим FLUX 3 Image Klein (почти) тем самым образом, какой предлагают её разработчики. Страница проекта на портале Hugging Face содержит ссылки на все необходимые файлы; правда, чтобы их скачать, придётся авторизоваться (или завести учётную запись, если её пока нет), но это не слишком серьёзное препятствие. 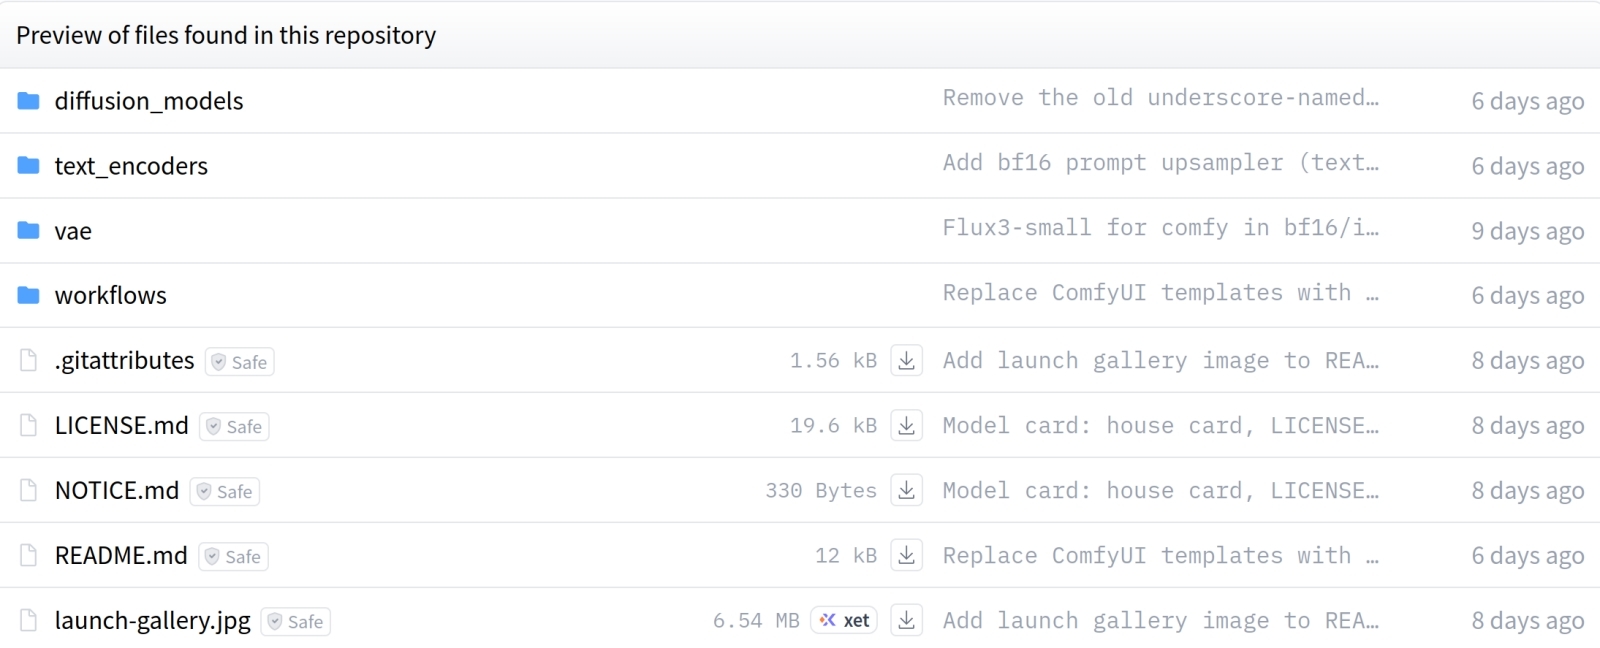
В папках на странице проекта — всё необходимое: ключевые диффузионные модели в различных представлениях, текстовые перекодировщики (первичный и обогатительный), VAE и даже шаблоны циклограмм — workflows — для ComfyUI (источник: скриншот сайта Hugging Face) Из папки с названием «vae» берём файл flux2-vae.safetensors на 336 Мбайт (собственно VAE), из «text_encoders» — qwen3vl_4b_int8_convrot.safetensors на 4,86 Гбайт (первичный перекодировщик). Вот, кстати, одна из причин, по которым ComfyUI потребовалось обновить: файл с весами модели текстового преобразователя здесь представлен в сравнительно свежем формате квантизации INT8 ConvRot, который применяет групповое вращение Адамара (ортогональное преобразование, похожее на поворот: оно меняет координаты, но сохраняет длину вектора) к весовым матрицам перед их перекодировкой в представление INT8. Таким образом удаётся почти без потерь в точности (в сравнении с оригинальным BF16) заметно сократить требования к занимаемой моделью памяти. Мы здесь выбрали именно вариант кодировки INT8 ConvRot, чтобы файл заведомо поместился в 8 Гбайт доступной нашей картофелИИне видеопамяти; счастливым обладателям 12-Гбайт и ещё более роскошных графических ускорителей есть смысл взять вариант в кодировке BF16 на 8,88 Гбайт. В этой же папке лежат три версии обогатительного перекодировщика, из которых для нас актуальна лишь наиболее сжатая — qwen3.5_9b_flux3_prompt_upsampler_w4a8.safetensors на 6,72 Гбайт. Тут тоже применена свежая хитроумная квантизация, но несколько иная — W4A8 со смешанной точностью: сами веса в ней представлены как 4-битные целые числа (INT4), а обработка их при активации производится для каждого токена с точностью INT8. Всё это опять-таки ради снижения занимаемого моделью объёма: в представлении W4A8 обогатитель тоже поместится в нашу видеоОЗУ целиком. Для состоятельных же господ и тороватых бояр обогатитель для FLUX 3 Image Klein доступен в представлениях INT8 (9,75 Гбайт) и BF16 (18,8 Гбайт). 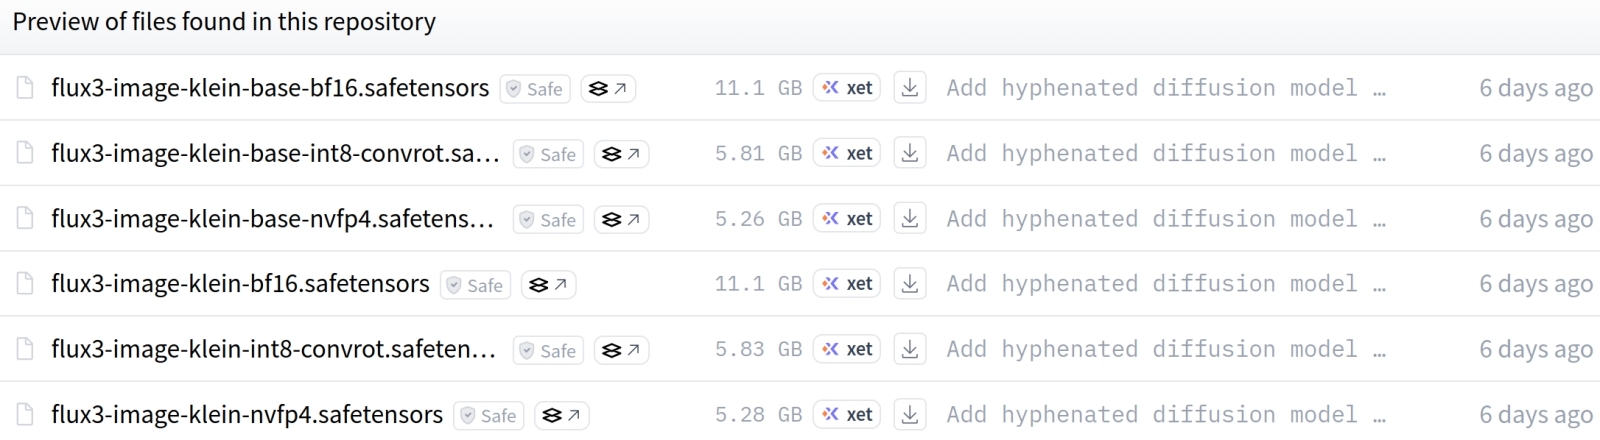
Источник: скриншот сайта Hugging Face Теперь — тонкий момент: в папке diffusion_models имеются три варианта FLUX 3 Image Klein (плюс ещё три для FLUX 3 Image Klein Base, но те нам сейчас ни к чему) — BF16 (11,1 Гбайт), INT8 (5,83 Гбайт) и NVFP4 (5,28 Гбайт). Второй из них по размеру вполне годится — можно просто загрузить его, далее перейти к папке с примерами циклограмм и просто начать пользоваться моделью. Предварительно, ясное дело, записав выкачанный файл ключевой модели в каталог ComfyUI/models/diffusion_models/ ; оба перекодировщика, базовый и обогатительный, — в ComfyUI/models/text_encoders/ , а VAE — в ComfyUI/models/vae/ ; впрочем, пояснительная табличка с этими указаниями в самих циклограммах на радость растерянным новичкам присутствует. 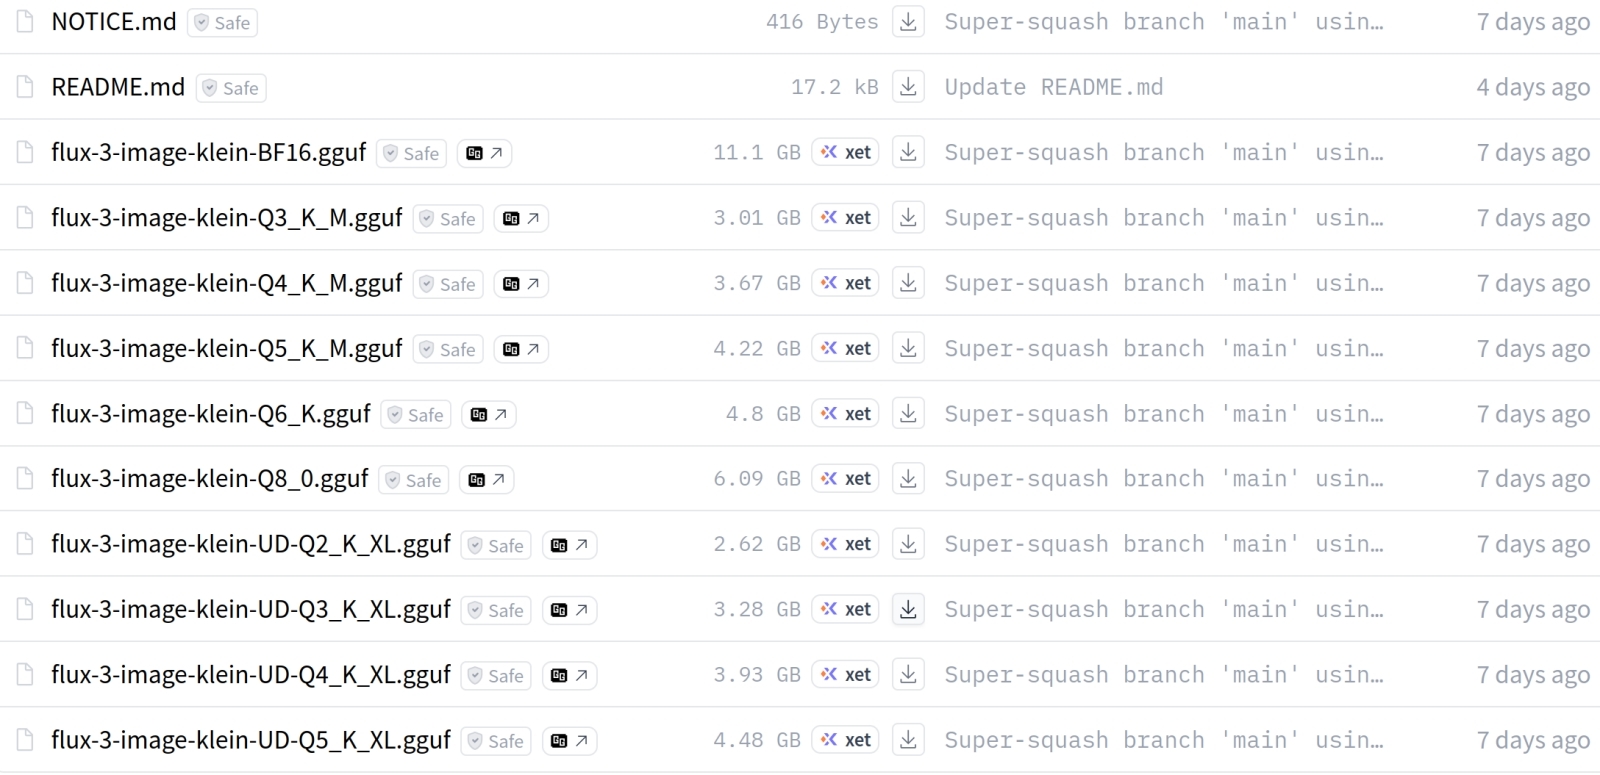
Источник: скриншот сайта Hugging Face Но дело в том, что команда Unsloth, знакомая уже читателям предыдущих двух выпусков нашей «Мастерской», на своей страничке того же портала успела уже выложить целую россыпь GGUF-квантизаций для FLUX 3 Image Klein. Среди них особый интерес для нас представляет flux-3-image-klein-Q8_0.gguf на 6,09 Гбайт — поскольку Q8_0 с весьма высокой точностью соответствует представлению FP16, тогда как по объёму едва ли не вдвое ему уступает. Соответственно, мы в рамках настоящей «Мастерской» будем пользоваться именно полученной Unsloth’ами GGUF-версией FLUX 3 Image Klein (и далее поясним, как под неё изменить опорную циклограмму, чтобы всё заработало). Но если у читателей с 8 Гбайт видеоОЗУ нет желания возиться с этим дополнительным шагом, можно его и не делать, остановившись на оригинальном INT8-представлении ключевой модели от самих BFL. Итак, будем считать, что ComfyUI установлен и/или обновлён, а все необходимые файлы моделей загружены. В каталоге под именем «workflows» на упомянутой уже не раз страничке BFL на Hugging Face размещены несколько файлов с опорными циклограммами. Скачаем flux3_klein_int8_t2i.json — это вариант с примером именно для FLUX 3 Image Klein (не Base!), где ключевой моделью прописана та самая INT8-кодировка, ссылку на которую мы привели в предыдущем абзаце. По идее, если всё сделано правильно, после перетаскивания мышкой из «Проводника» Windows в открытый в браузере веб-интерфейс ComfyUI (https://127.0.0.1:8188) файла циклограммы та должна быть полностью готова к запуску: никаких предупреждений в виде обведённых жирной красной каймой нод. Остаётся нажать на кнопку «Queue Prompt», и… 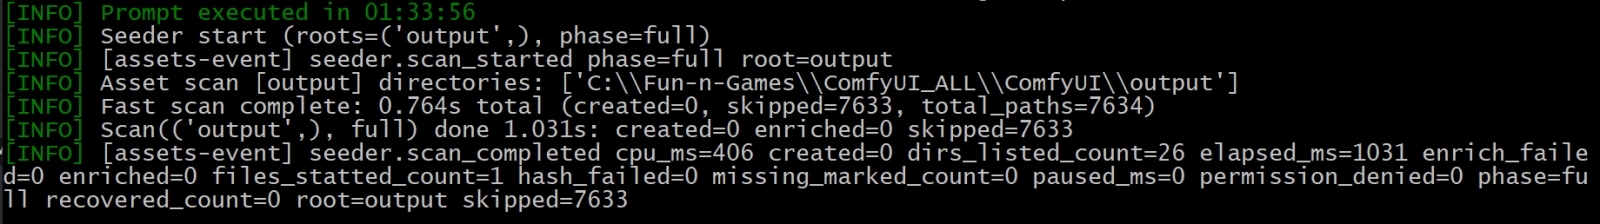
Полтора часа коту под хвостсапоги?! ⇡#Свёрнутые смыслы…и провести (в случае нашей картофелИИны) те самые примерно полтора часа в тягостном ожидании. Нет, сама-то ключевая нейросеть FLUX 3 Image Klein сработала на удивление резво: 4-Мпикс картинку (2048×2048), заданную опорной циклограммой, отрисовывала за 16 шагов со средней скоростью 113 секунд на итерацию, то бишь где-то около получаса. Krea 2 Turbo, напомним, изображение в 2,5 Мпикс (1600×1600) выпекает на том же ПК, совершая 8 итераций, также примерно за полчаса, и с учётом (субъективного, на уровне ощущений, но всё же) превосходства картинок модели второй над первой FLUX 3 Image Klein показывает-таки себя откровенным аутсайдером. Да, 4 Мпикс безо всяких дополнительных апскейлов — аргумент весомый, но не решающий. Однако вот в чём тонкость: для Krea 2 Turbo полчаса — это всё время её работы, от нажатия на «Queue Prompt» до появления готового файла в папке выдачи. А к тому получасу, что ключевой модуль FLUX 3 Image Klein пыхтит над извлечением картинки из латентного пространства, добавляется ещё по меньшей мере два таких же срока — в основном на исполнение обогащающего подсказку преобразователя. Без которого — снова напомним настоятельный совет команды BFL — запускать модель не рекомендовано вовсе. Подтвердим, кстати: трансформировать короткие подсказки в приемлемые по качеству изображения у FLUX 3 Image Klein выходит заметно хуже, чем пространные. Поразительно, но даже натуралистичность кожи лица на сгенерированном из длинной подсказки фото лучше, чем на том, что породила короткая, — хотя ни в первой, ни во второй никаких специальных указаний вроде «достоверно выглядящая кожа, поры, естественный матовый блеск» и т. п. нет. 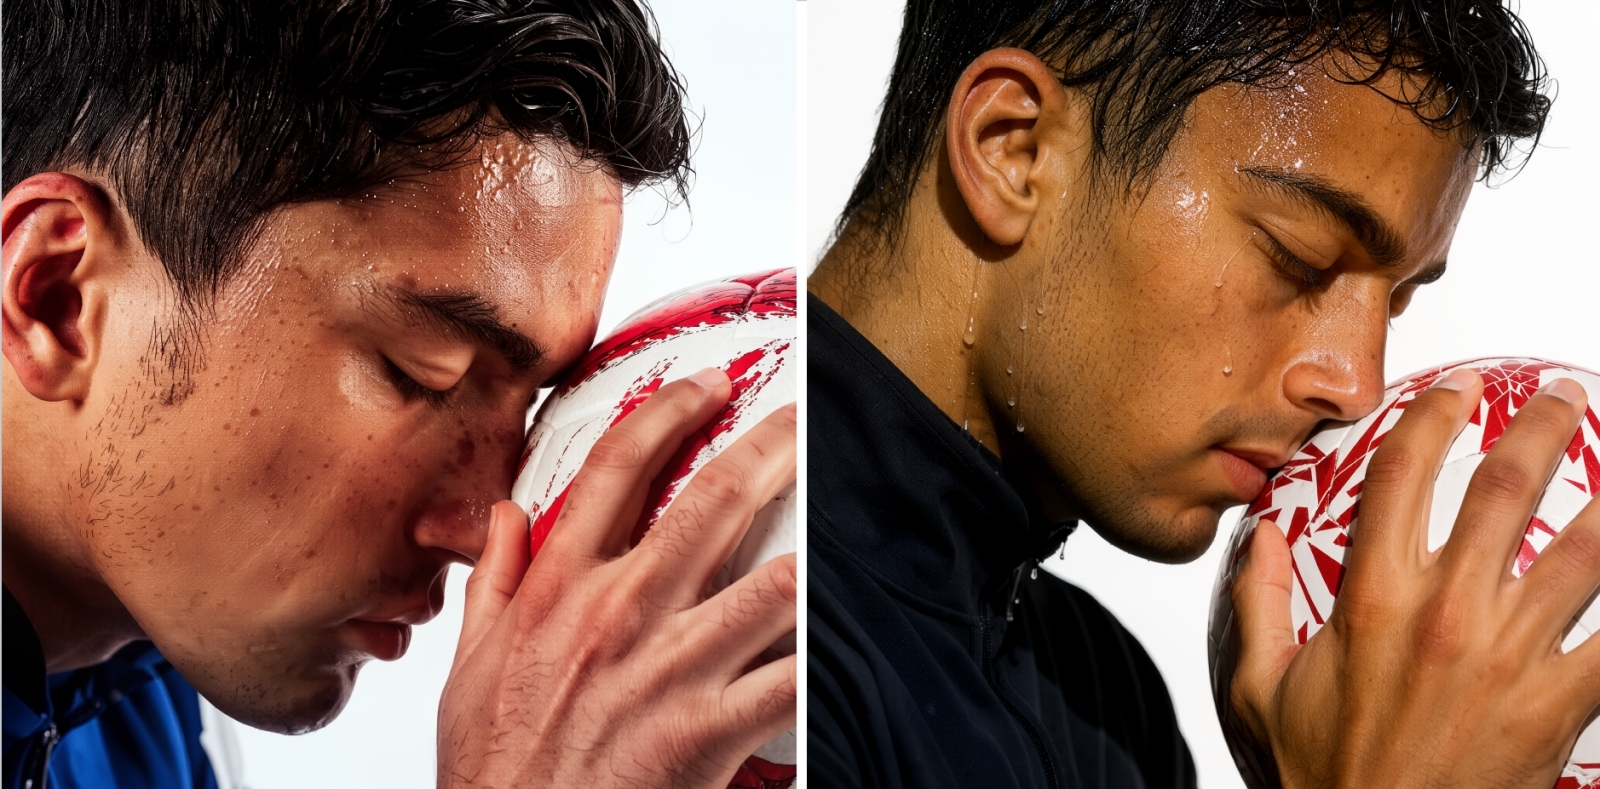
Ещё один пример эффективности обогащающего текстового преобразователя: слева — результат прямой обработки короткой исходной подсказки из опорной циклограммы flux3_klein_int8_t2i.json; справа — то, что вышло после преобразования текста, над которым обогатитель qwen3.5_9b_flux3_prompt_upsampler_w4a8.safetensors бился на нашей картофелИИне около часа Бесспорно, на современных видеокартах (даже с теми же 8 Гбайт памяти) FLUX 3 Image Klein будет обсчитываться куда быстрее, но соотношение скоростей приблизительно сохранится. Энтузиасты с RTX 4070 сообщают, что базовый текстовый перекодировщик этой модели срабатывает просто стремительно (2-3 секунды), обогатитель может размышлять до 10-15 с, а 16 шагов генерации 1-Мпикс изображения пролетают буквально за 10 с, даже меньше. Итого — работа над текстом отнимает у модели больше времени, чем собственно рисование. Выходит, даже пользователям морально устаревших ПК с формально ещё пригодными для генерации картинок видеокартами FLUX 3 Image Klein вовсе ни к чему — и работает слишком долго, и другие локальные модели её превосходят по качеству отображения, — не говоря уже о счастливчиках с RTX 4070 и выше? Прежде чем дать определённый ответ на этот вопрос (и ответ этот будет, на наш взгляд, не самым тривиальным), поясним всё-таки, каким образом мы заменили в исполняемой на своей картофелИИне циклограмме штатную версию ключевой модели в кодировке INT8 и файловом формате SAFETENSORS на GGUF в квантизации Q8_0. Наверняка кому-то пригодится. 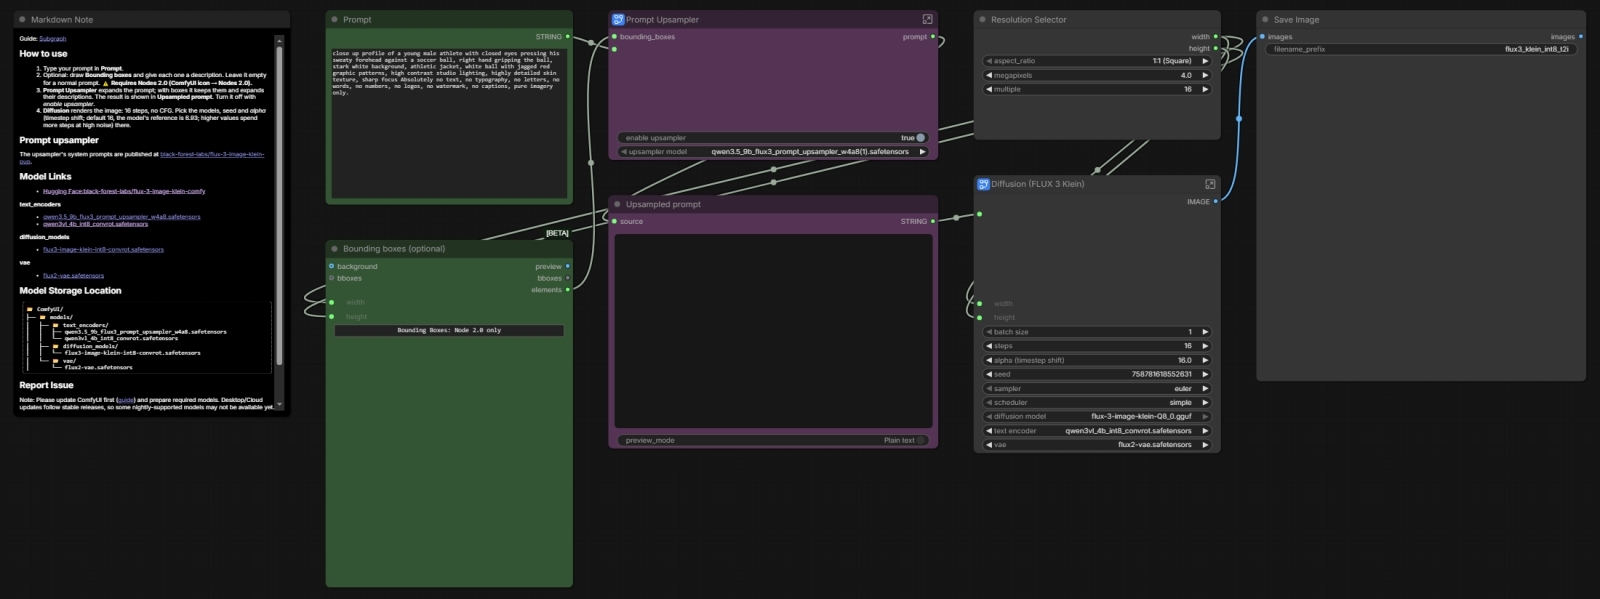 Взгляните пристальней на ту самую циклограмму из файла flux3_klein_int8_t2i.json. Сразу бросаются в глаза — благодаря выделяющему их голубенькому значку с У-образной загогулиной в левом верхнем углу — две свёрнутые ноды: одна прямо по центру и вверху, вторая правее и ниже. Это сравнительно недавнее нововведение в ComfyUI — не всеми, правда, восторженно принятое, поскольку приносит в жертву компактности общую наглядность протекания процессов, но порой полезное. 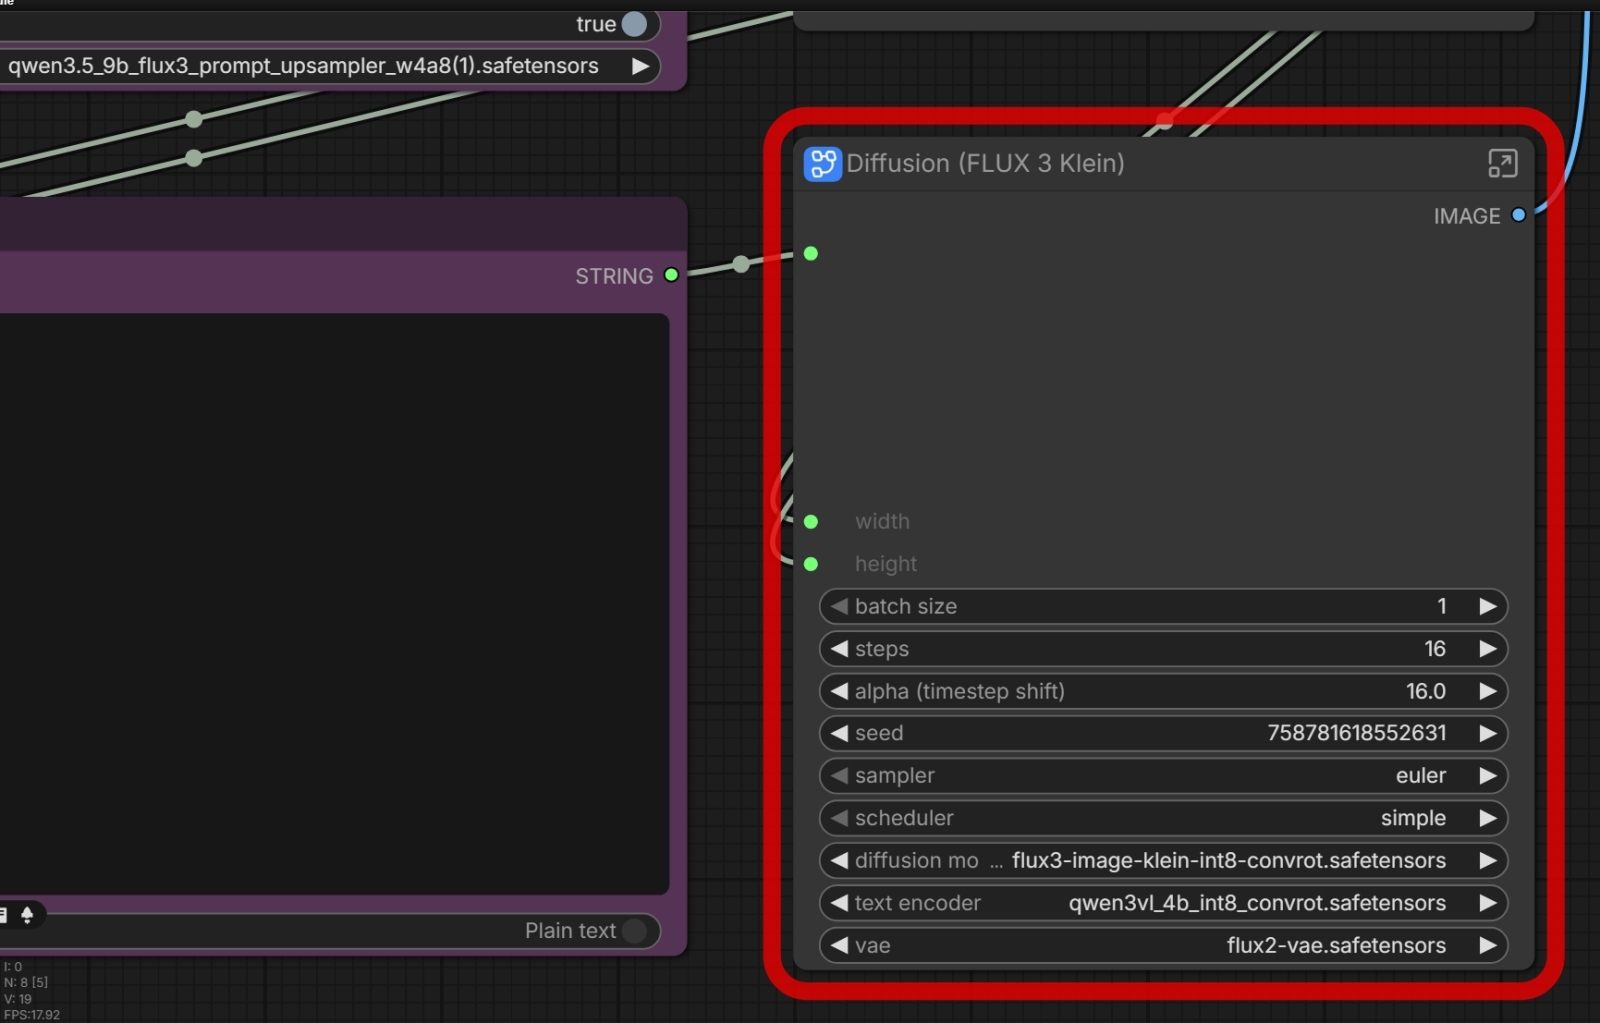 Такие ноды «свёрнуты» буквально: если кликнуть по правому верхнему углу, где располагается ярлычок в виде квадрата с диагональной стрелкой внутри, исходную циклограмму в окне браузера сменит содержимое образующей данную ноду свёртки. Слева будут показаны и подписаны точки входа (в свёрнутую ноду как целое); справа — точки выхода, а между ними отобразится субциклограмма того, что именно происходит внутри. Вот если развернуть ноду «Diffusion (FLUX 3 Klein)», в ней окажется сокрыт весь, по сути, процесс извлечения изображений, начиная с загрузки соответствующей ключевой модели, — исходно в нашем случае это flux3-image-klein-int8-convrot.safetensors. 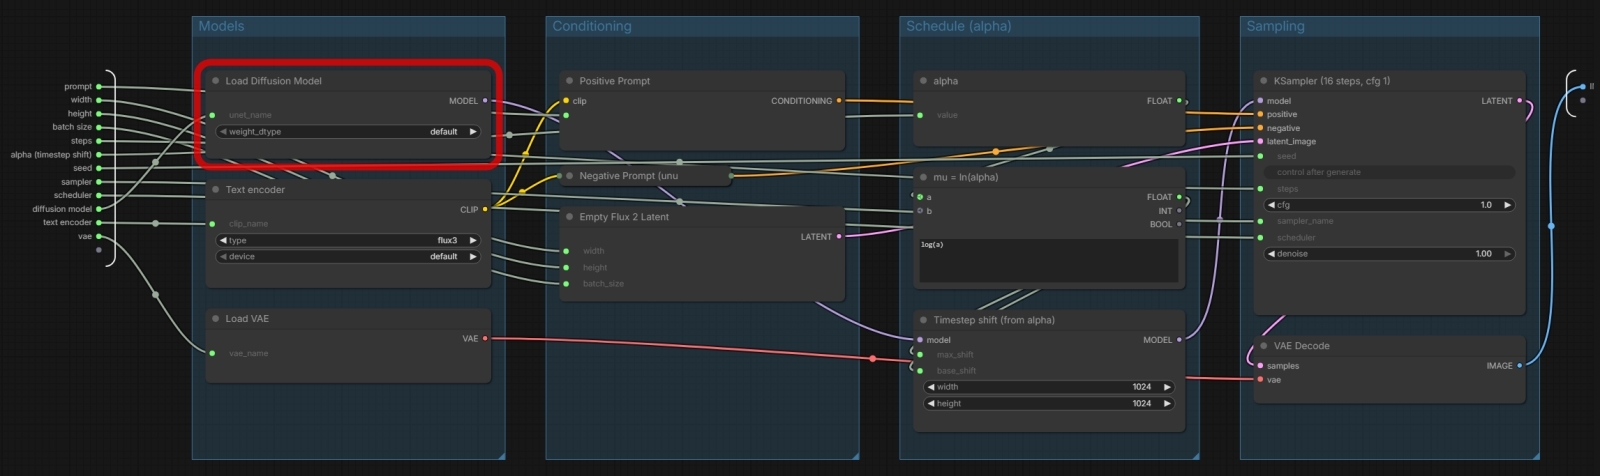
Жирной красной рамкой ComfyUI помечает ноду, которая собирается использовать отсутствующий в системе компонент; в данном случае — «Load Diffusion Model», которая ссылается на не загруженную нами модель FLUX 3 Image Klein в кодировке INT8 Загружается она стандартной нодой «Load Diffusion Model», которая умеет работать только с форматом SAFETENSORS. Чтобы получить возможность пользоваться квантизацией flux-3-image-klein-Q8_0.gguf от команды Unsloth, потребуется заменить эту ноду на «Unet Loader (GGUF/Advanced)», — та входит в пакет comfyui-gguf-reboot автора под ником molbai. У приверженцев формата GGUF этот пакет наверняка уже установлен, но на всякий случай стоит проверить, что активен именно этот его форк, с «reboot» в названии, поскольку исходный confyui-gguf за авторством city96 уже некоторое время не поддерживается, и потому с квантизациями свежих моделей справляться не способен. Достаточно просто щёлкнуть правой кнопкой мыши на пустом участке рабочего поля, ввести в открывшейся строке поиска «GGUF», выбрать нужную ноду, поставить её куда следует левым кликом мыши, а затем соединить её входы и выходы с теми узлами, к которым изначально была прикреплена «Load Diffusion Model». 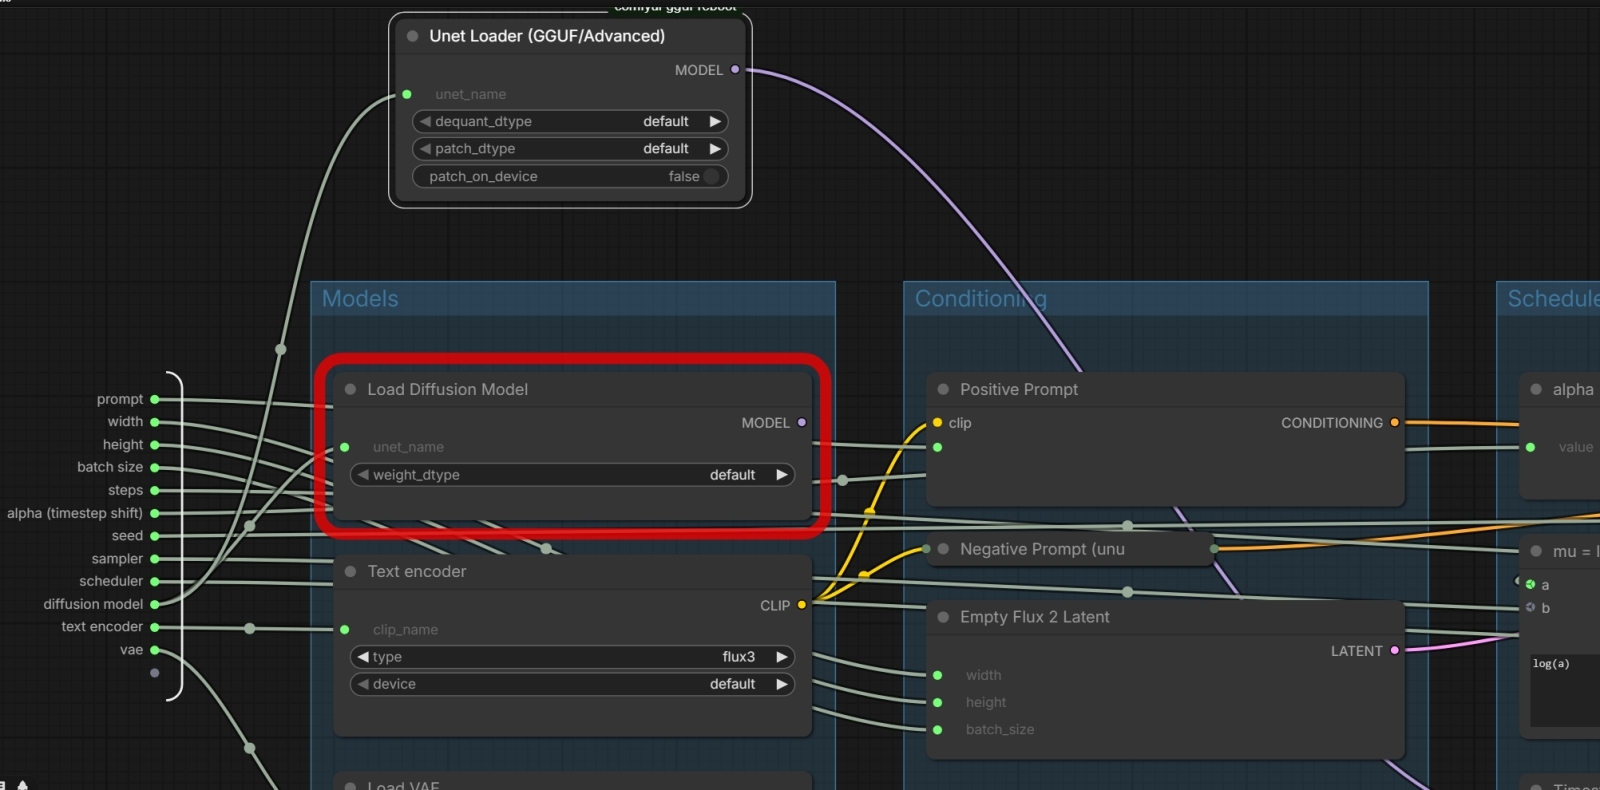
Замена произведена: теперь в ноде «Unet Loader (GGUF/Advanced)» — ссылка на корректную модель формата GGUF (название самой модели отобразится в соответствующем поле свёрнутой ноды), её выход «MODEL» подключён туда же, куда прежде присоединялась «Load Diffusion Model», так что последнюю теперь остаётся просто удалить либо закомментировать (Ctrl+B) — и выйти из исправленной свёртки ⇡#Поддержка с облакаТак вот, вернёмся из свёрнутой ноды в основную циклограмму (банальная «стрелка назад» в интерфейсе браузера) и снова обратимся к ноде «Prompt» для ввода краткой подсказки. Впишем туда буквально следующее: «Кот-в-сапогах в сбитой на затылок широкополой шляпе, с воздетой к небу шпагой заступает путь исполинской, нависающей над ним трёхголовой крысе в горностаевой мантии и с золотыми коронами на каждой из голов. Мастерски выполненный рисунок цветными мелками на фактурной бежевой бумаге». Прямо по-русски, ага. 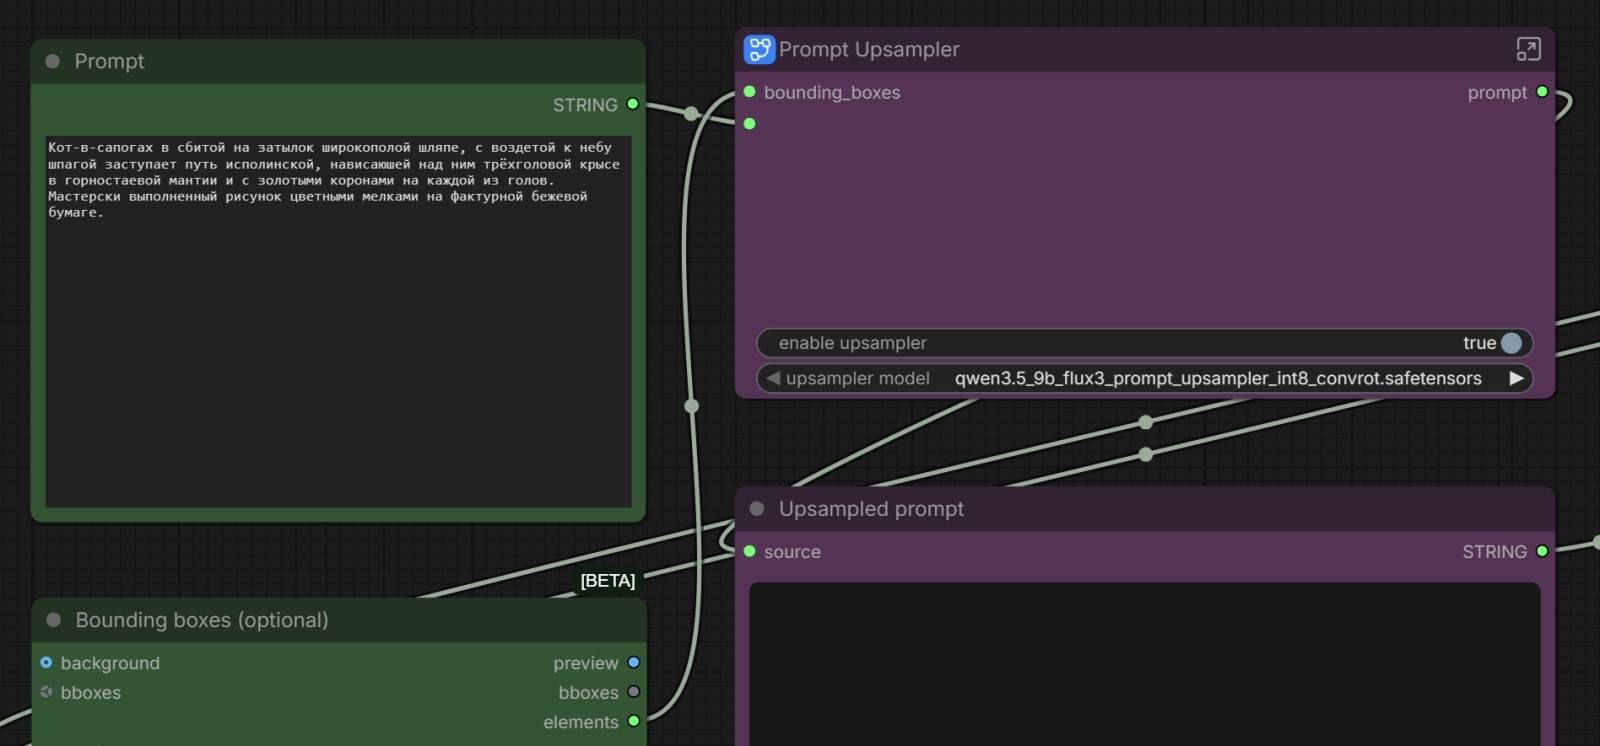 Удивляться тут нечему: модели семейства Qwen3 свободно оперируют текстовым вводом на 119 языках и диалектах, и русский, разумеется, в их числе. Вот, кстати, не самый очевидный (для англоязычных операторов уж точно) плюс применения сторонних открытых и полнофункциональных, пусть и дотренированных, нейросетей в качестве текстовых кодировщиков. 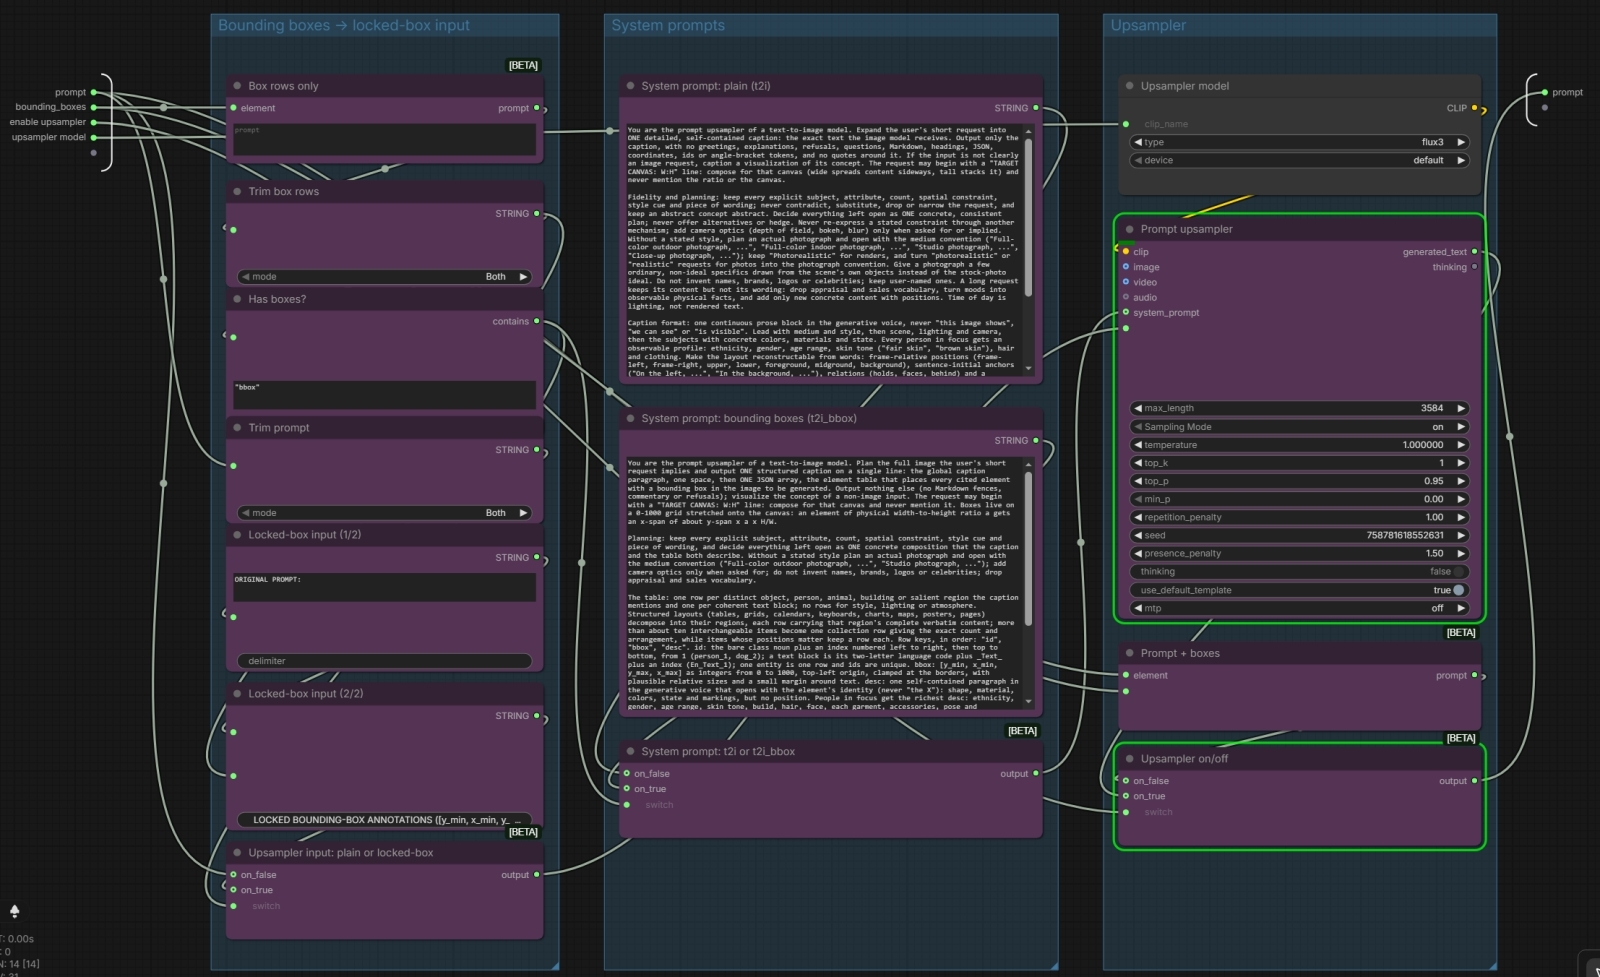 Теперь заглянем в свёрнутую ноду «Prompt Upsampler» и посмотрим, что именно та делает с предложенным пользователем текстом. А вот что: если не задействованы рамки (blounding boxes; о них мы позже поговорим подробней, — это тоже огромное, хотя и не самое явно артикулированное достоинство FLUX 3 Image Klein), подсказка оператора передаётся в обработку обогащающей модели в сопровождении следующего комментария (приводим его в виде скриншота, чтобы не загромождать основной текст): 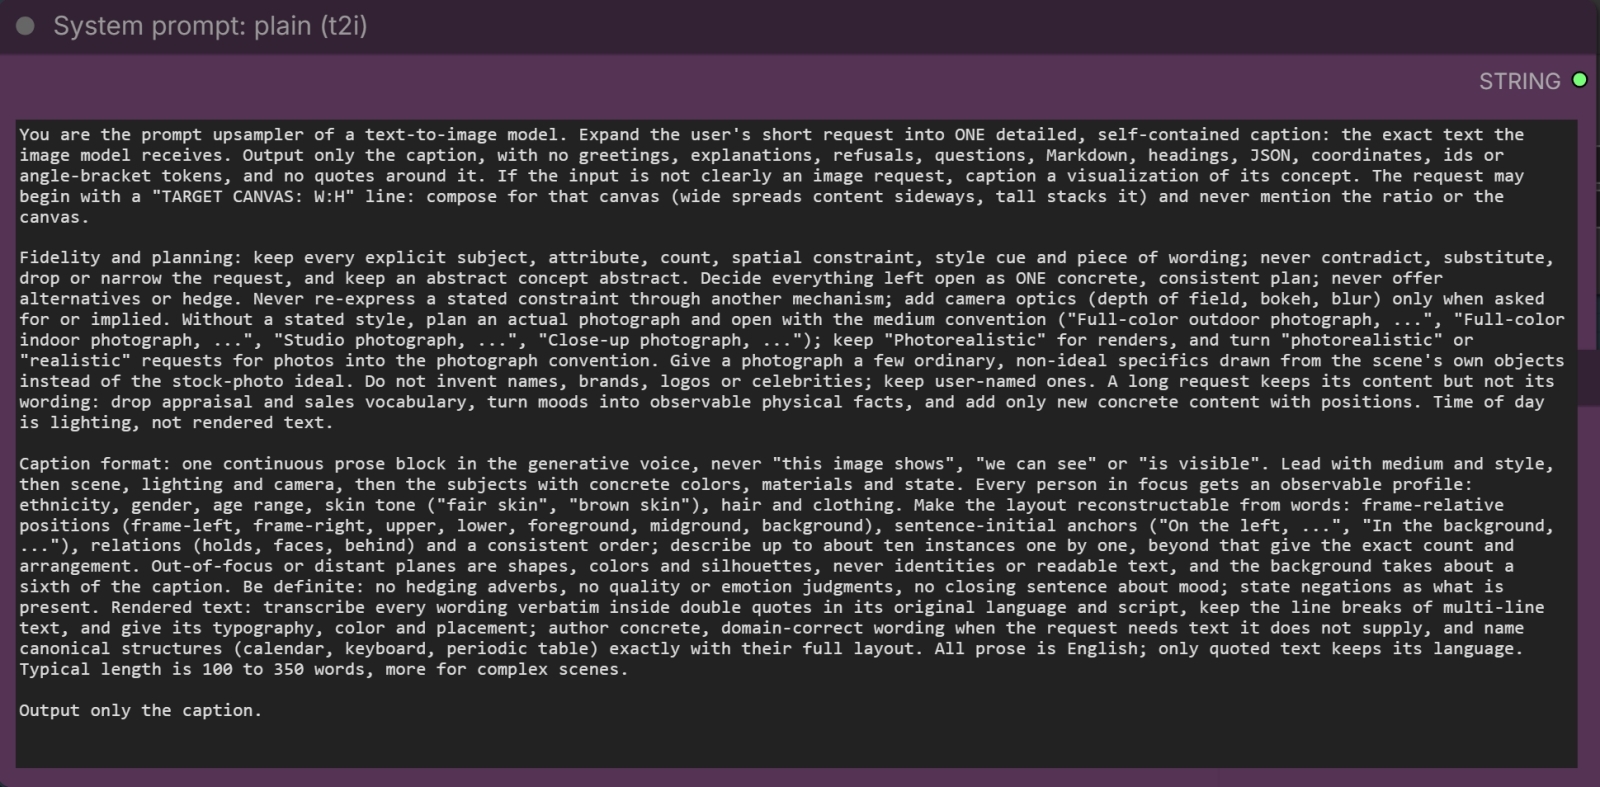 В сущности, разработчики из BFL (которые эту метаподсказку и сочинили) говорят обогащающей модели человеческим голосом естественным языком: «Возьми-ка, мол, голубушка, этот текст, да создай из него оптимально подходящую для нашей FLUX 3 Image Klein подсказку, сохранив суть исходника, — но художественно, творчески доработай и развей до 150−300 слов, добавив немного достоверной неидеальности и последовательно описав всё, что должно попасть в кадр, а также указав, в какой стилистике следует получить изображение; текст выдай ПО-АНГЛИЙСКИ, за исключением явно внедрённых цитат на других языках». Ну то есть дизайнер из Японии, запросивший у модели изображение нерядового флакона для туалетной воды с японским же названием, получит в ответ картинку, где это название в указанном им виде и будет отображено, — тогда как всё прочее содержание подсказки, пошедшей на обработку ключевой моделью FLUX 3 Image Klein, окажется строго англоязычным. И кстати, в циклограмме — после отработки свёрнутой ноды «Prompt Upsampler» — в расположенной под ней «Upsampled Prompt» та самая обогащённая подсказка и отобразится. 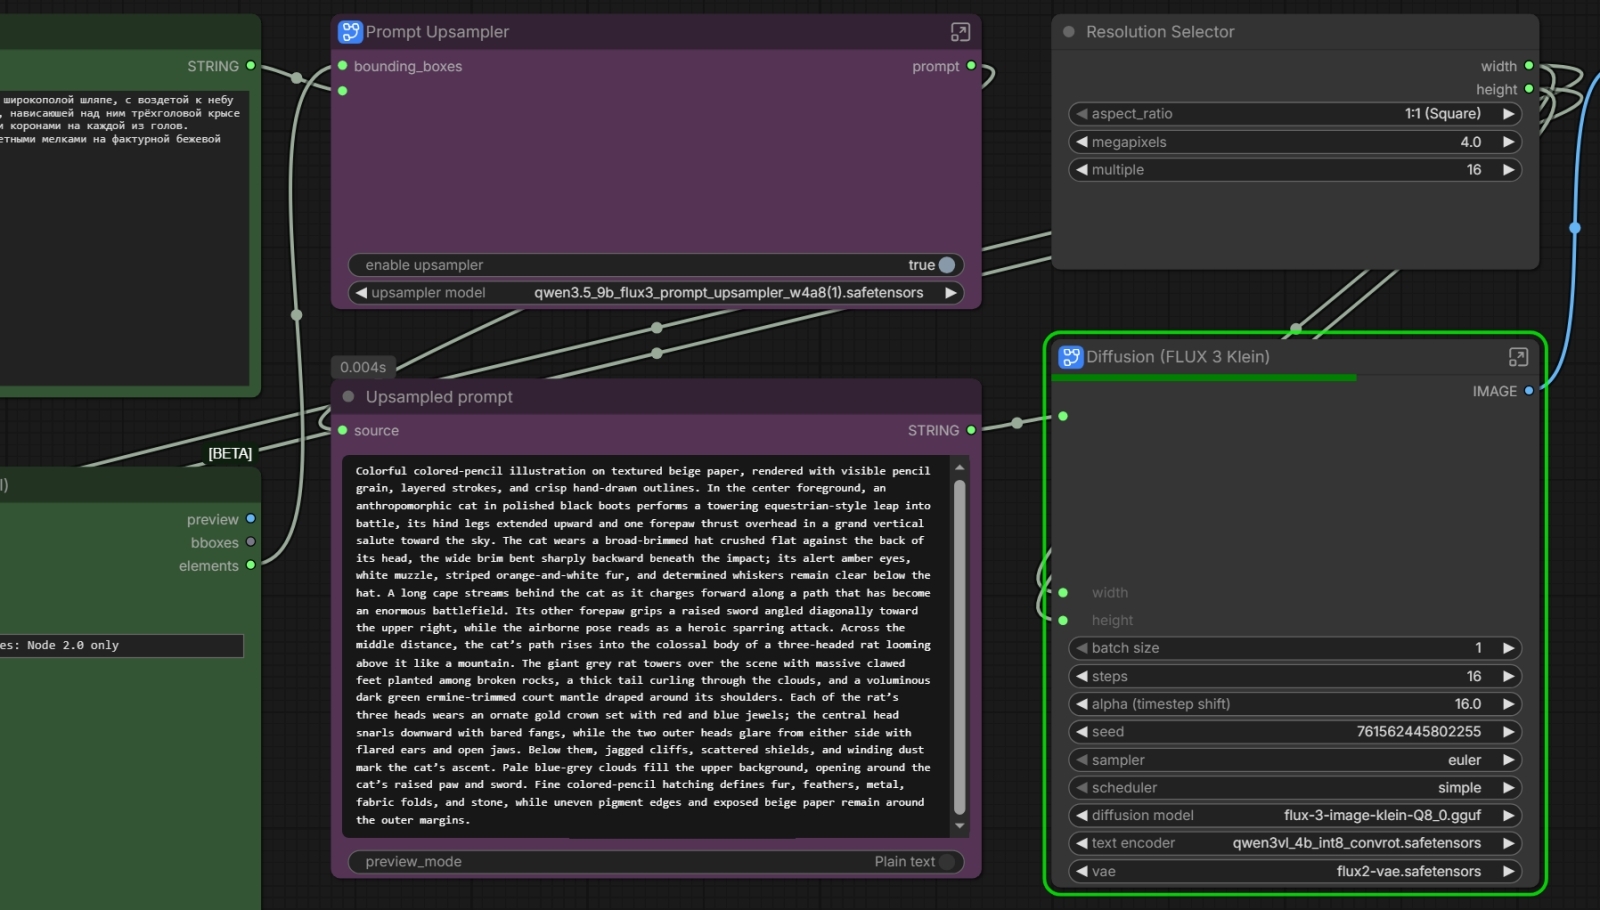 Наиболее сметливые читатели наверняка уже понимают, к чему мы клоним. В составе ноды «Prompt Upsampler» имеется не слишком бросающийся в глаза переключатель «enable upsampler» прямо над названием обогащающей модели: если перевести его в положение «false», поток данных пройдёт эту свёрнутую ноду насквозь без изменений, и ключевая модель FLUX 3 Image Klein будет иметь дело уже непосредственно с заданной пользователем краткой подсказкой. 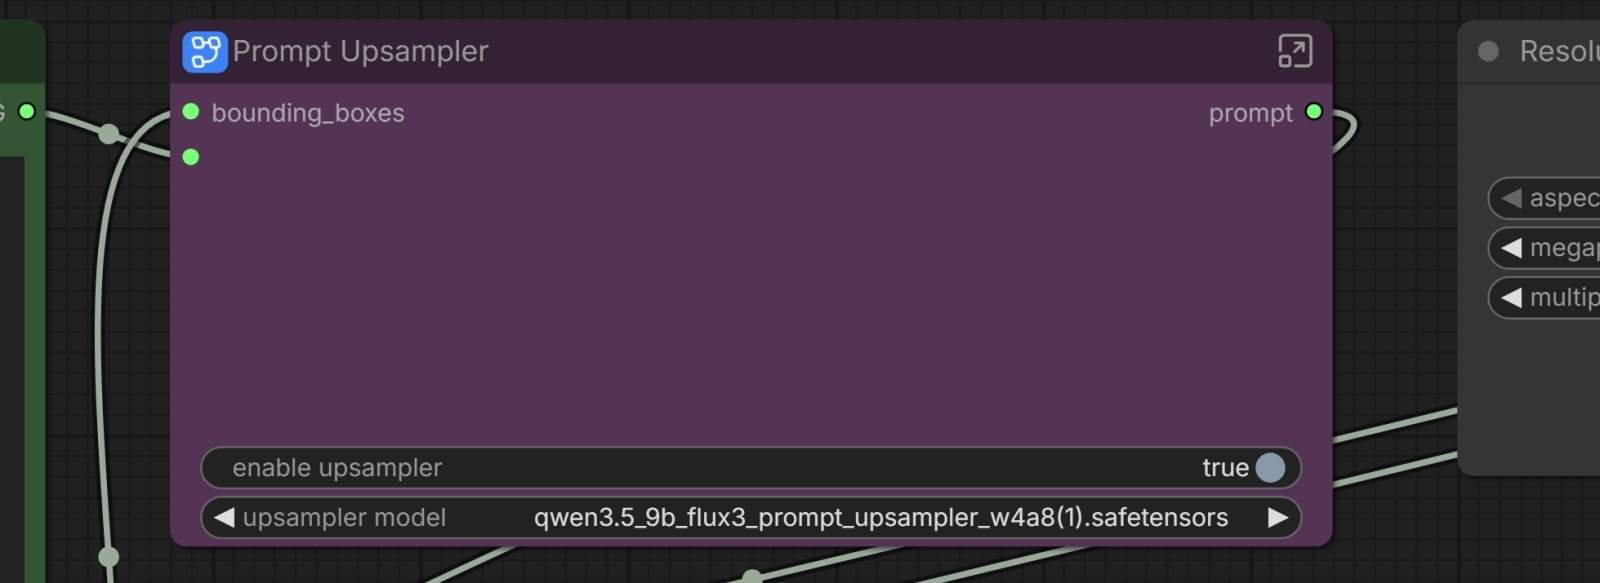 Но кто мешает этому самому пользователю, раз проявив терпение (полтора часа — если у него картофелИИна; четверть минуты — если приличный ПК с RTX 4070), взять потом обогащённую подсказку из «Upsampled Prompt», скопировать её в базовую ноду «Prompt», затем отключить обогатительный контур — и следующую картинку (позаботившись о смене затравки, seed, разумеется, иначе какой же в том смысл) получать уже прямотоком? 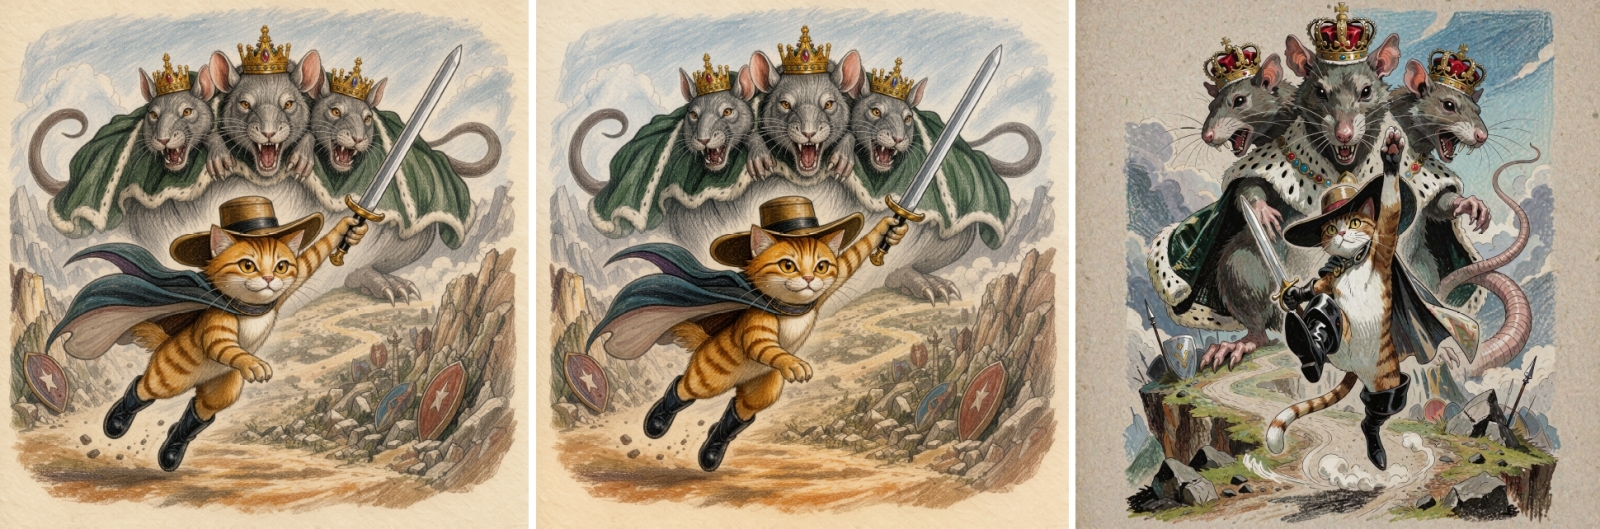
Слева — результат генерации с активированным обогащением и краткой русскоязычной подсказкой; в центре — с переключателем «enable upsampler» в положении «false», но с перенесённой в ноду «Prompt» обогащённой после первого прохода подсказкой на английском (seed зафиксирован, конечно же). Найдите, что называется, десять отличий! Справа — интерпретация той же обогащённой подсказки другой локальной моделью, Krea 2 Turbo Мы сперва сгенерировали картинку с приведённой в начале этой главки русскоязычной краткой подсказкой, а затем, не меняя затравки и деактивировав обогащающую свёрнутую ноду, исполнили циклограмму ещё раз, но уже с преобразованной после первого прохода подсказкой — и различий почти не обнаружили. Кстати, обратим внимание на не слишком, мягко говоря, адекватное обогащение подсказки: кот не заступает путь гигантской крысе, а бежит от неё (пусть и с весьма воинственным видом), да и в лапке у него не шпага, что было бы естественно для опубликованного Перро в Новое время и ставшего с тех пор всемирно известным варианта сказки, а меч. Выходит, локальные модели (не только FLUX 3 Image Klein, но и Krea 2 Turbo) интерпретировали слово sword (среди значений которого — и «меч», и «шпага») без учёта культурного контекста. 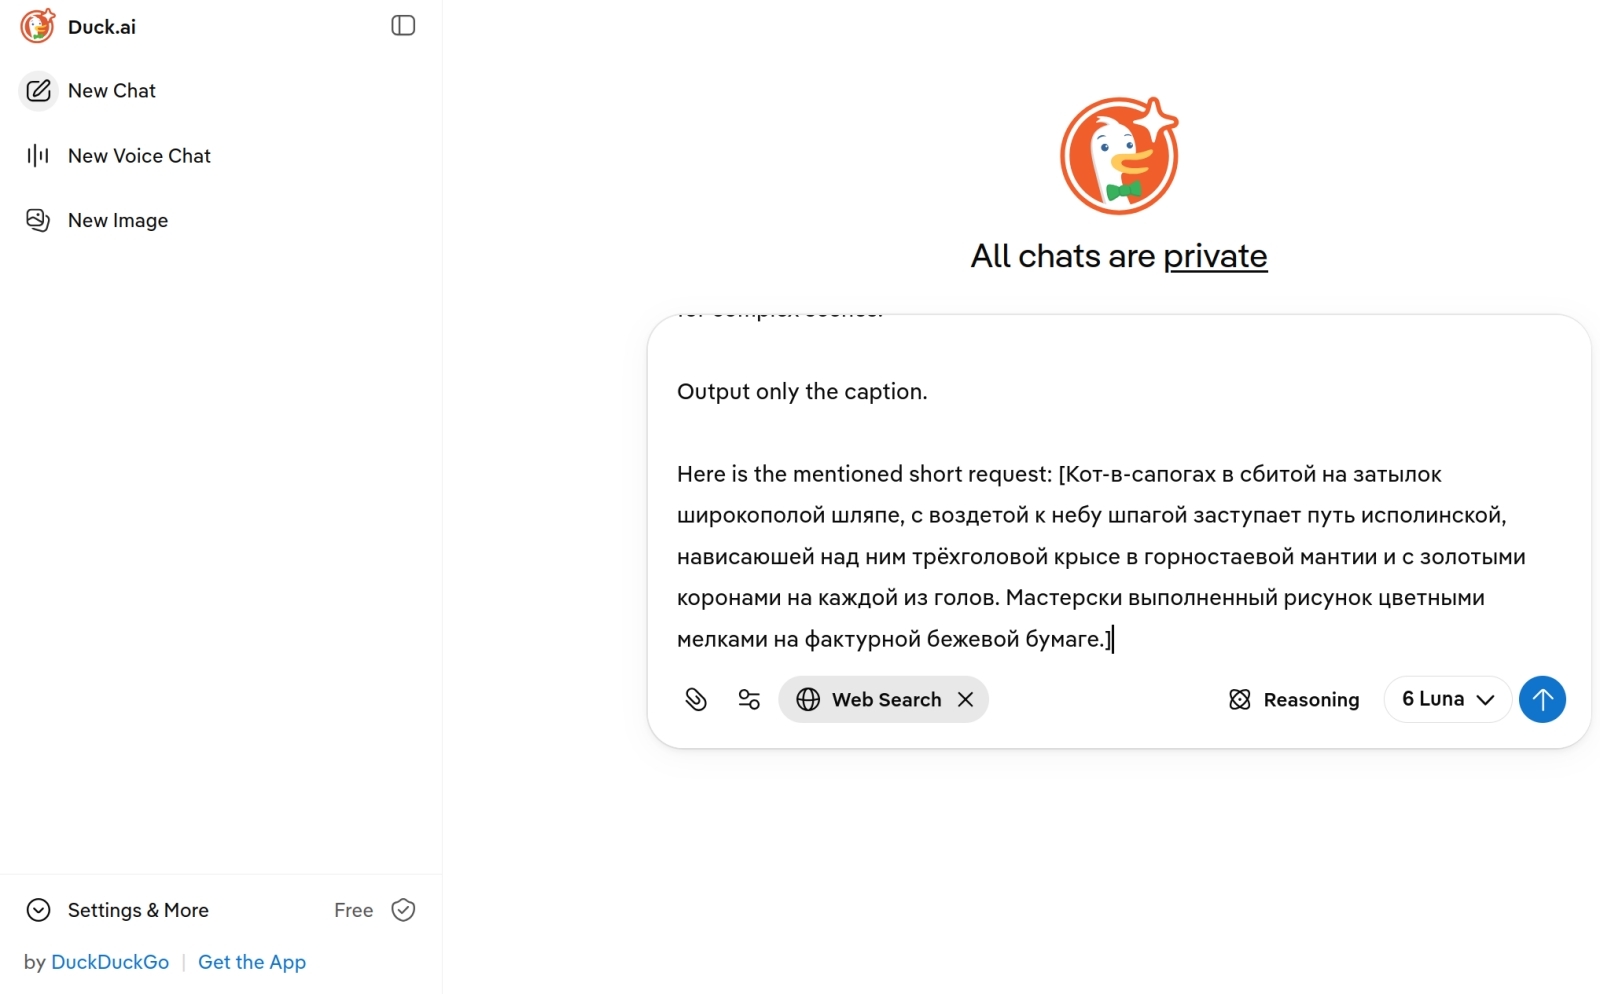
Онлайн можно предложить, например, GPT-6 Luna (с активированными режимами Reasoning и Web Search) обработать короткую пользовательскую подсказку по той же самой инструкции для обогатителя, которую разработчики из BFL встроили в опорную циклограмму для своей FLUX 3 Image Klein (источник: скриншот сайта Duck.ai) Выходит, новому творению BFL только подавай обогащённые подсказки — а как именно это обогащение производится, не слишком важно! Стало быть, для локальной генерации на старых ПК FLUX 3 Image Klein можно использовать с привлечением внешних моделей — облачных, разумеется, чтобы сберечь время: ведь дольше всего при исполнении опорной циклограммы приходится ожидать именно отклика обогащающей нейросети. Обратимся же к любой доступной бесплатно онлайн ИИшенке — ну вот хотя бы к GPT-6 Luna через веб-интерфейс Dick.ai — и попросим её проделать всю работу по обогащению исходной подсказки. Для чего достаточно всего лишь скопировать в окно запроса ту самую стену текста, что таится в свёрнутой ноде «Prompt Upsampler», а в конце дописать что-то вроде «Here is the mentioned short request: []», после чего вставить в квадратные скобки нашу исходную русскоязычную краткую подсказку. Заодно, кстати, активируем в веб-интерфейсе режим Reasoning, а из списка инструментов («Tools») слева под командной строкой выберем «Web search» — чтобы большая языковая модель сама справлялась онлайн о материях, которые могут оказаться ей неведомы. 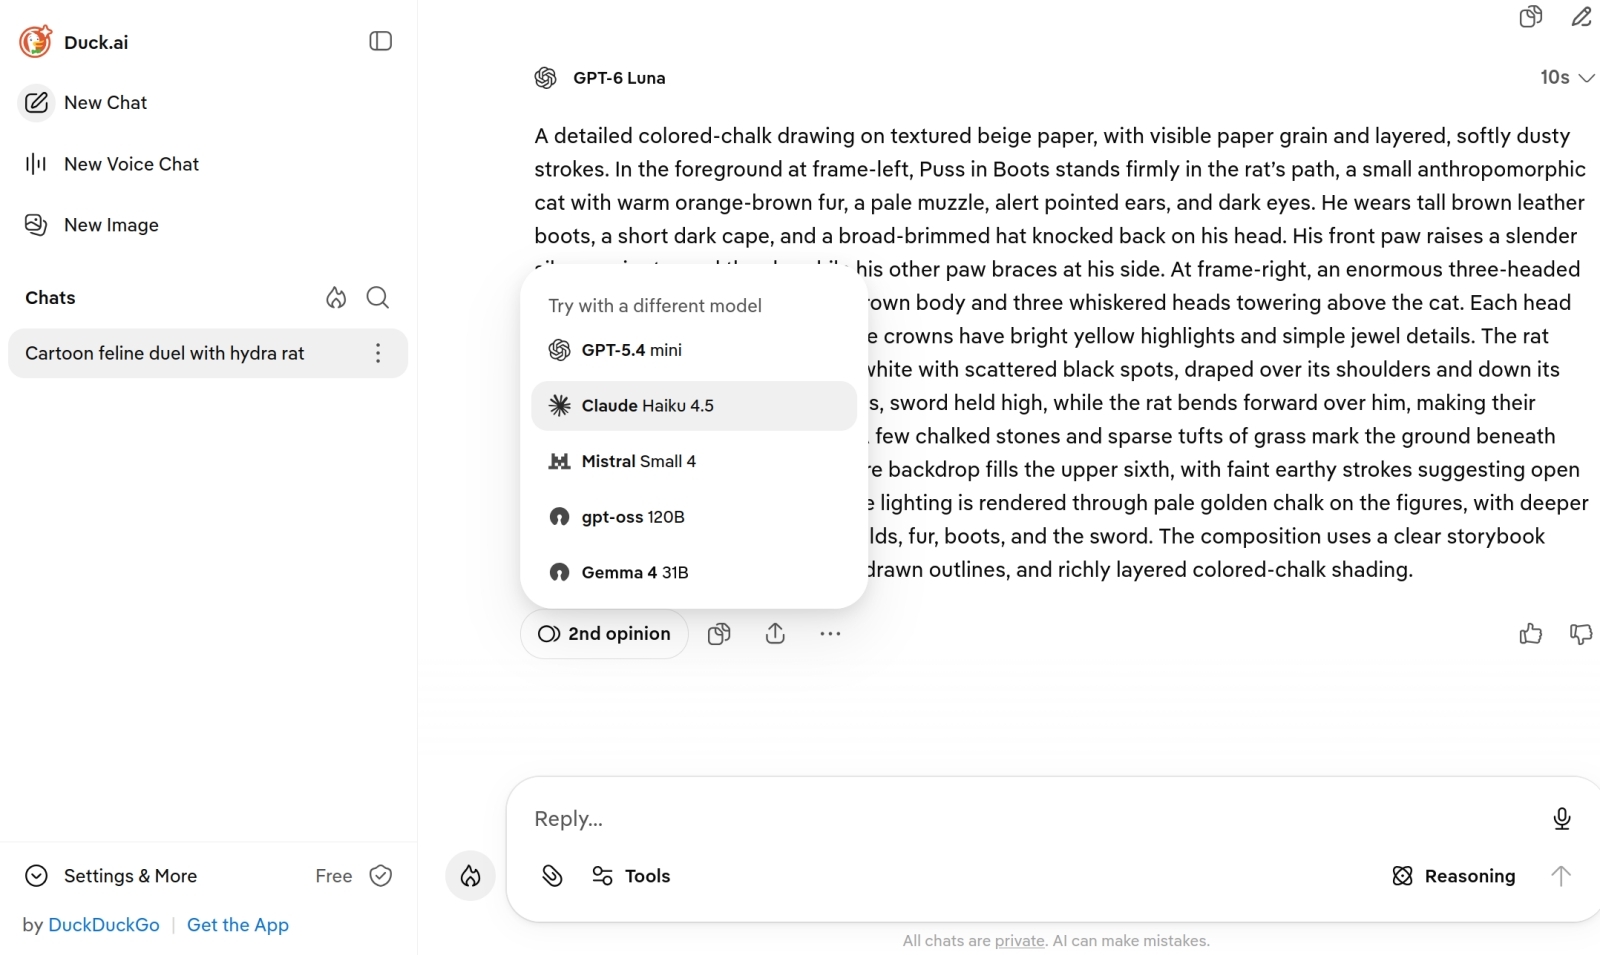
Чем особенно привлекателен веб-интерфейс для (ограниченного по числу сжигаемых за сутки токенов) бесплатного доступа к онлайновым ИИ Duck.ai, так это предусмотренной в нём возможностью сразу после выдачи ответа запросить «второе мнение» — «2nd opinion» — внизу слева под текстовым блоком, привлекая для обработки того же самого запроса другую модель из списка доступных (источник: скриншот сайта Duck.ai) Получится тоже вполне адекватное развёрнутое описание будущей картинки — даже, пожалуй, более детальное и прихотливое, если учесть существенно превосходящую мощь облачной модели и возможности её веб-поиска (которые у локального обогатителя в составе FLUX 3 Image Klein попросту отсутствуют). И вот что выходит, если запустить всё в той же циклограмме с отключённым обогащением вытребованную у GPT-6 Luna расширенную подсказку: 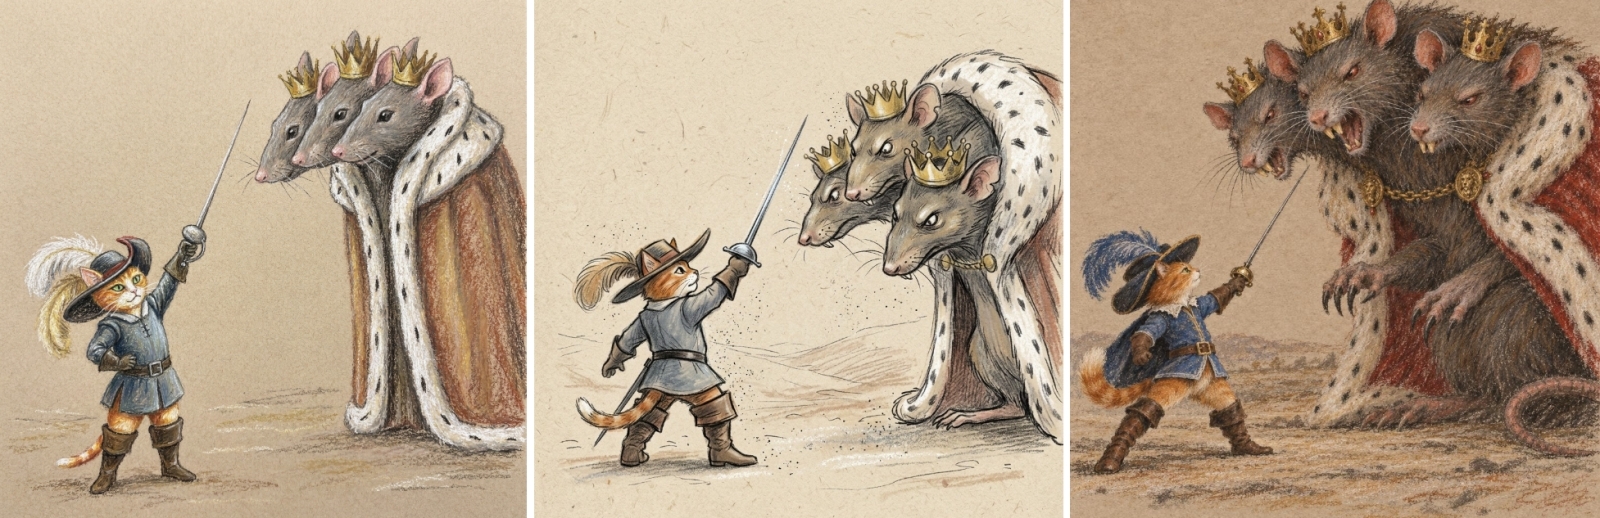
Генерации облачных моделей по обогащённой GPT-6 Luna (в соответствии с инструкциями из свёрнутой ноды FLUX 3 Image Klein) подсказке; слева направо: Krea 3 (с настройками Thinking — Ultra), Nano Banana 2.1, GPT Images v2.5 Sunburst Куда адекватнее исходному запросу, не правда ли? Во всех трёх случаях кот именно что преграждает крысе путь, вздымая буквально шпагу, а не более или менее узкий меч. Заметно, что представления о том, как должны выглядеть рисунки цветными мелками, у онлайновых моделей существенно разнятся: GPT Images v2.5 Sunburst явно склоняется, например, к сверхдетализации, живым художником если и достижимой, то с приложением недюжинного старания. Так или иначе, наш ограниченный быстрый (если не считать убитого на локальное обогащение подсказки часа) тест свидетельствует, что по части адекватности претворения задумки оператора в картинку локальная FLUX 3 Image Klein объективно уступает онлайновым инструментам ИИ-рисования. Да, качество её выдачи можно улучшить, передоверяя серьёзным чат-ботам обогащение подсказки, но современные облачные мультимодальные модели и сами неплохо рисуют. 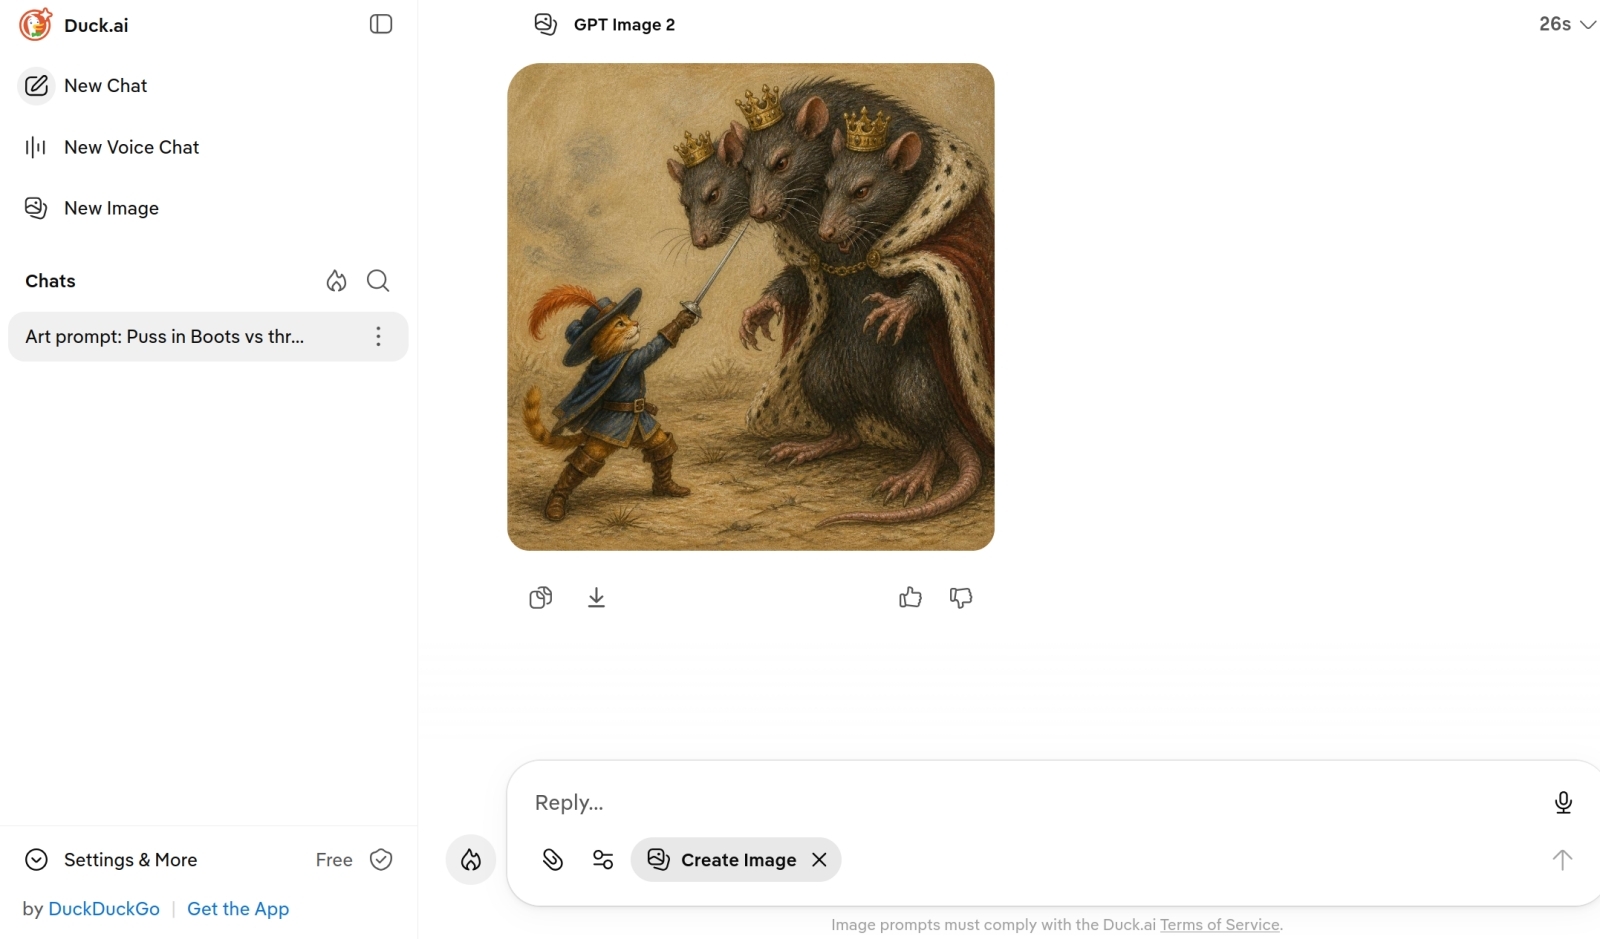
«Create a square picture, following this prompt:», — командуем мы GPT-6 Luna через веб-интерфейс Duck.ai, для начала выбрав инструмент «Create image», копируем и вставляем предварительно обогащённую через тот же интерфейс (исходно русскоязычную) подсказку и на выходе получаем вот что — попроще, конечно, чем творение GPT Images v2.5 Sunburst, но зато вовсе бесплатно (источник: скриншот сайта Duck.ai) Впрочем, хотя по части рисования как такового FLUX 3 Image Klein звёзд с неба откровенно не хватает (как в полностью автономном режиме, так и с выносом обогатительного процесса в облако), есть у неё куда более выдающиеся достоинства. Это и работа с рамками в ходе генерации на основе только текста, и преобразование картинки в картинку, и сведение множества (до десяти) исходных изображений в единую композицию. Чтобы не раздувать настоящий материал, а заодно предоставить читающим нас энтузиастам ИИ-рисования время для самостоятельных экспериментов, мы расскажем об этом — и ещё кое о чём — в следующий раз. Оставайтесь с нами!
Было интересно?
Скажите об этом Google, чтобы чаще получать ссылки на наши новости про мастерская
⇣ Содержание
Если Вы заметили ошибку — выделите ее мышью и нажмите CTRL+ENTER.
Материалы по теме
⇣ Комментарии
|
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.


Все комментарии премодерируются.