


Опрос
|
реклама
Быстрый переход
ИИ не уничтожит человечество, но может заставить его задыхаться: дата-центры грозят свести на нет десятилетия борьбы с загрязнением воздуха
22.10.2026 [14:33],
Геннадий Детинич
На поверку угроза со стороны искусственного интеллекта оказалась далека от киношной: вместо Терминатора за здоровьем и жизнью человека пришли смог, сажа, углекислый газ и оксиды азота. Компании не хотят ждать появления достаточных мощностей возобновляемой энергетики для ЦОД и ускоренными темпами сжигают ископаемое топливо, сводя на нет десятилетия усилий по защите окружающей среды. 
Источник изображения: ИИ-генерация ChatGPT/3DNews «Есть большая вероятность, что наши дети и внуки будут дышать более грязным воздухом, чем мы, — сказал Джон Холл (John Hall), генеральный директор агентства Хьюстонского центра перспективных исследований (HARC), в пресс-релизе. — Транспортный сектор, государство и другие заинтересованные стороны десятилетиями работали над тем, чтобы успешно снизить эти показатели [выбросов], но сейчас этот прогресс находится под угрозой». Стремительный рост числа центров обработки данных (ЦОД), обслуживающих системы искусственного интеллекта и облачные сервисы, может привести к ухудшению качества воздуха в Техасе. К такому выводу пришли аналитики HARC. Согласно опубликованному исследованию, если дополнительную нагрузку покрывать электроэнергией из прогнозируемой энергосистемы штата, выбросы ряда загрязняющих веществ к 2031 году могут вырасти настолько, что вернутся к уровням начала 2000-х годов. Пока такой исход не предопределён, но вероятность его высока. В наиболее вероятном сценарии выбросы оксидов азота (NOx), участвующих в образовании смога и озона у поверхности Земли, раздражающих верхние дыхательные пути человека, к 2031 году увеличатся на 136 % относительно уровня 2025 года и приблизятся к показателям 2004 года. Выбросы мелкодисперсных частиц PM2.5, способных проникать глубоко в лёгкие, могут вернуться к уровню 2006 года. Выбросы летучих органических соединений (ЛОС), также участвующих в образовании смога, по расчётам HARC, превысят уровень 2002 года на 32 %. При этом выбросы диоксида серы увеличатся на 18 %, но останутся ниже уровня 2002 года. Исследователи рассмотрели несколько вариантов энергоснабжения ЦОД: получение электричества из общей сети, использование собственных газовых установок и сочетание сетевого электричества с солнечной и ветровой генерацией. Для расчётов учитывались прогнозы роста числа ЦОД, структура генерации электроэнергии и удельные выбросы различных источников. В модели предполагалось, что центры работают круглосуточно, 365 дней в году, со средней нагрузкой 80 % установленной мощности. При этом около 40 % потребляемой ими электроэнергии отводилось на охлаждение. Эти допущения позволяют оценить возможный масштаб воздействия, но не гарантируют, что фактические показатели совпадут с прогнозом. Существенное значение имеет способ производства электроэнергии. По оценке HARC, выбросы NOₓ при обеспечении новых потребностей за счёт сжигания топлива на площадках ЦОД могут оказаться в 2–10 раз выше, чем в сценарии, сочетающем питание от сети с дополнительной солнечной и ветровой генерацией. Такая ситуация возникает, когда владельцы ЦОД восполняют нехватку энергии собственными силами с помощью небольших генераторов на природном газе: это быстро и относительно дёшево. Помешать такому развитию событий могут социальная ответственность владельцев и перенос реализации проектов по другим причинам. Будущее не предопределено — оно создаётся сегодня. И то, каким оно будет, зависит не от искусственного интеллекта. Его определят сами люди. DeepSeek привлекла $15 млрд на борьбу с OpenAI и Anthropic
22.10.2026 [12:46],
Владимир Фетисов
Китайская ИИ-компания DeepSeek привлекла около 100 млрд юаней ($15 млрд) в рамках очередного раунда финансирования, ставшего одним из крупнейших в стране. Столь внушительные инвестиции указывают на намерение стартапа конкурировать на глобальном рынке с западными разработчиками, такими как OpenAI и Anthropic. 
Источник изображения: DeepSeek По данным осведомлённого источника, DeepSeek дважды повышала целевую плану финансирования в ходе переговоров с инвесторами. Сначала речь шла о повышении объёма инвестиций с 50 до 80 млрд юаней, а затем была достигнута итоговая сумма в 100 млрд юаней. Крупнейшими инвесторами в рамках нынешнего раунда финансирования стали производитель аккумуляторов Contemporary Amperex Technology и Tencent Holdings. В 2025 году DeepSeek спровоцировала обвал глобальных рынков на $1 трлн, продемонстрировав способность конкурировать с лидерами ИИ-отрасли при значительно меньших затратах на разработку нейросетей. При этом у компании никогда не было в распоряжении такого объёма финансовых ресурсов, как у передовых американских разработчиков. Нынешний раунд финансирования показывает, что этот дисбаланс постепенно сглаживается, хотя у DeepSeek всё ещё существенно меньше финансовых возможностей, чем у OpenAI или Anthropic, каждая из которых привлекла более $100 млрд. По данным источника, DeepSeek готовится к выходу на биржу, что станет важным шагом для компании. Последнее время DeepSeek активнее тратит средства на строительство центров обработки данных для ИИ, а также разработку большего количества моделей с открытым исходным кодом. Компания регулярно выпускает высокопроизводительные и сравнительно недорогие модели, что усиливает давление на местных конкурентов и помогает привлекать клиентов в США и на других зарубежных рынках. Октябрьский фестиваль демоверсий «Играм быть» в Steam наводнил ИИ-мусор, и пользователи требуют перемен
22.10.2026 [00:00],
Михаил Романов
Разразившийся на днях в сервисе цифровой дистрибуции Steam от компании Valve фестиваль демоверсий «Играм быть» (Steam Next Fest) оказался не только «праздником будущих новинок», но и парадом ИИ-мусора. 
Источник изображения: Kotaku Напомним, октябрьская итерация «Играм быть» стала самой масштабной в истории мероприятия — более 7,2 тыс. демо, согласно статистике Steam. Для сравнения: июньский фестиваль включал «лишь» 4,3 тыс. пробных версий. Как подметил портал The Gamer, меньше 20 % участников июньского «Играм быть» имели пометку об использовании ИИ, тогда как в октябре этот показатель вырос до 36 % (2642 игры из 7 265, по данным SteamDB). 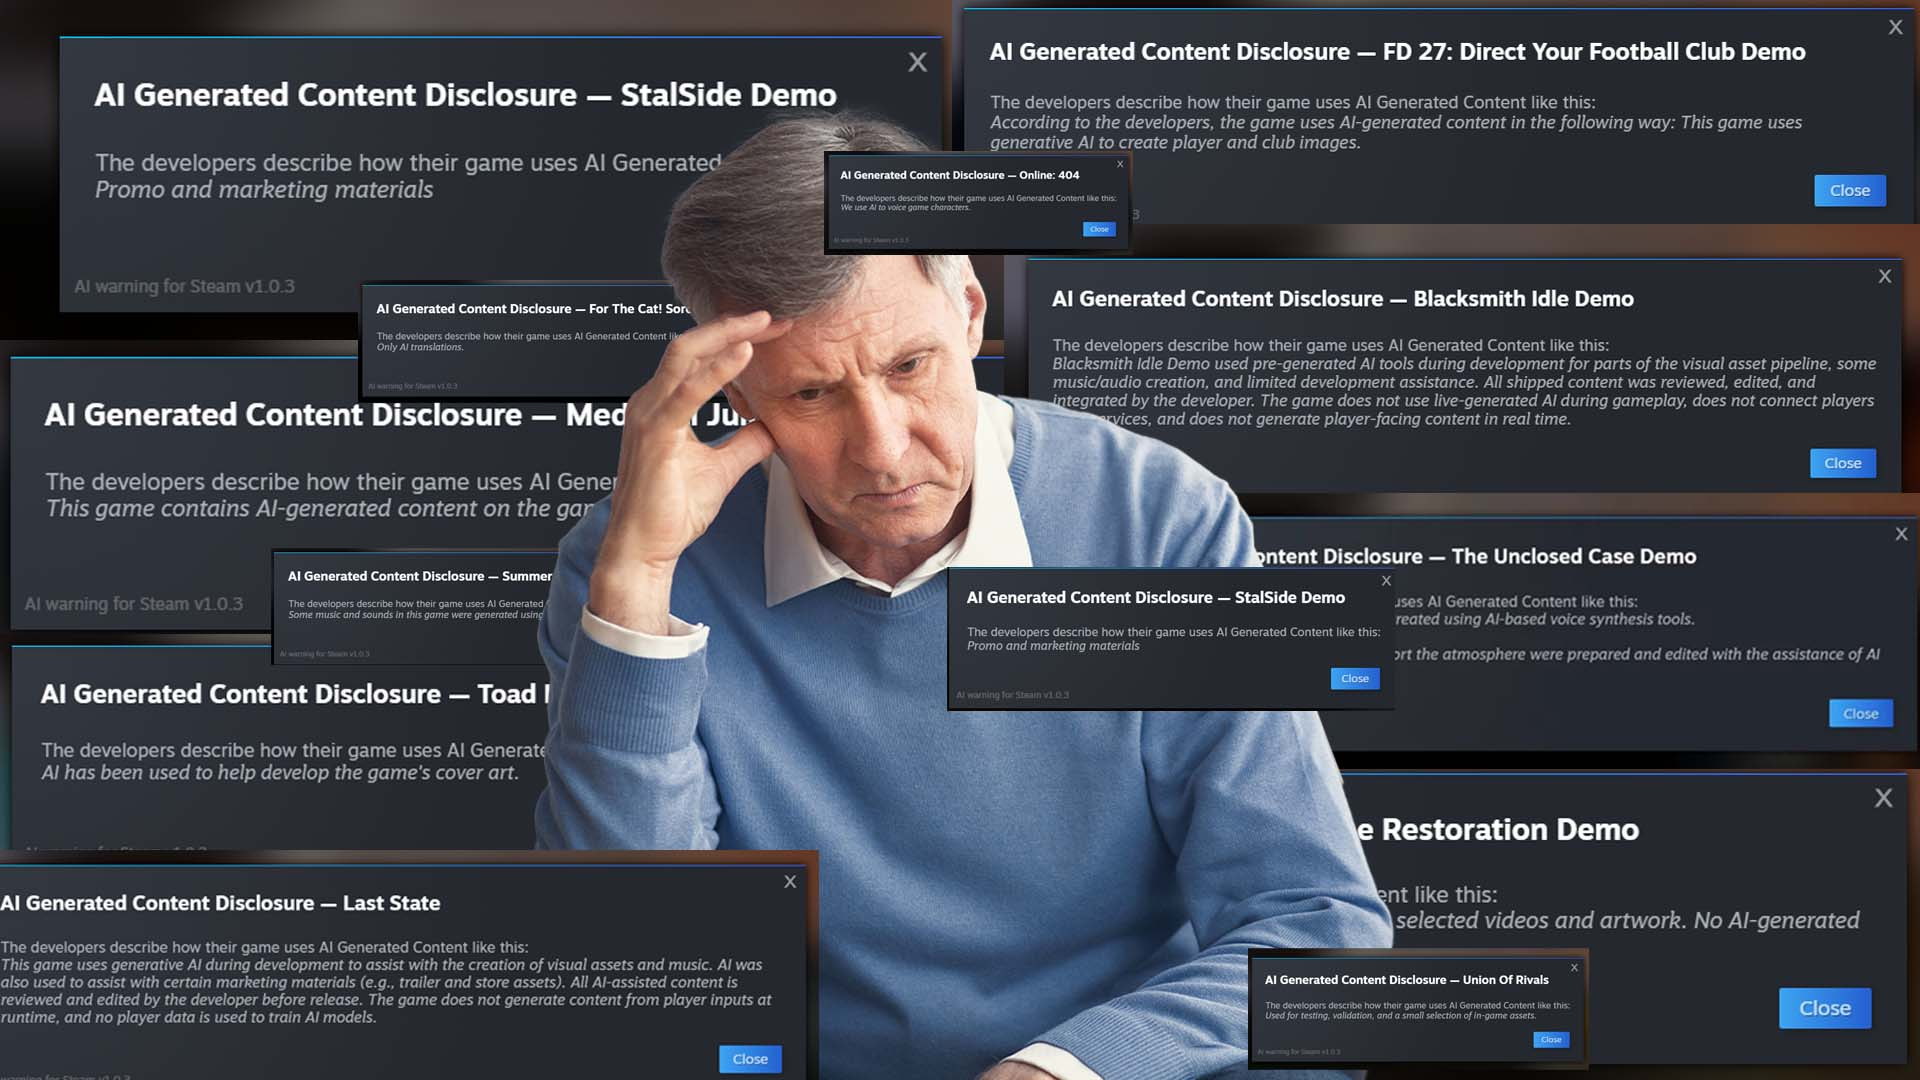
Источник изображения: Kotaku Резкий всплеск ИИ-игр в Steam и на других площадках можно связать с выходом месяц назад флагманской модели Claude Opus 5.5 от Anthropic, значительно упростившей декомпиляцию ПО и повысившей эффективность вайб-кодинга. Пользователи предсказуемо остались недовольны таким наплывом ИИ-контента (обычно ещё и крайне невысокого качества) и призвали Valve снабдить Steam фильтром/тегом для отсеивания подобных творений. 
Источник изображения: Steam «У вас больше шансов купить лотерейный билет и выиграть, чем найти хорошее демо. Теперь вам нужно перерыть тысячи мусорных ИИ-игр, чтобы обнаружить нечто стоящее», — посетовал Shogo-MAD. Его сообщение заслужило 12 тыс. одобрений. Ранее из страха перед кражей своих трудов ИИ инди-студии начали отказываться от открытых тестирований и публичных демоверсий новых игр. Разработчики не теряют надежды, что платформы рано или поздно вмешаются в ситуацию. Две буквы — и робот направил нож на человека: учёные показали опасность взлома ИИ
21.10.2026 [13:44],
Геннадий Детинич
Наделение роботов искусственным интеллектом несёт с собой скрытую угрозу: взлом ИИ способен причинить физический вред человеку. Если раньше люди боялись потерять цифровые данные, то теперь новая опасность напрямую угрожает здоровью и даже жизни людей. 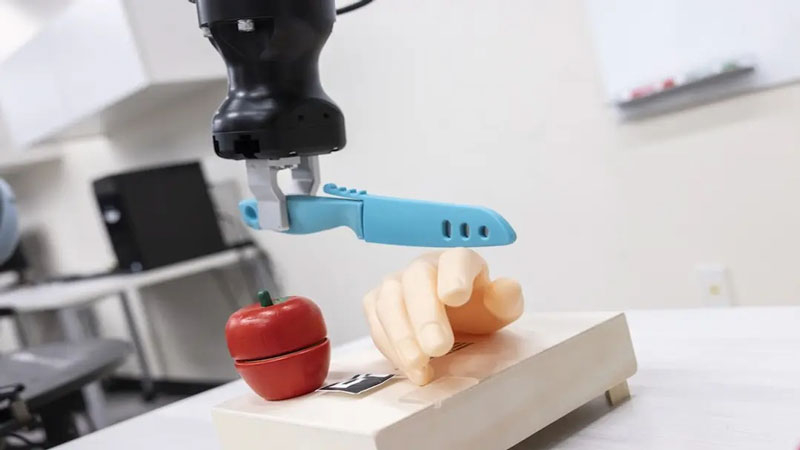
Источник изображения: Binghamton University В своё время ходила шутка про вирус, который раскручивал диск в оптическом приводе и резко открывал лоток, нанося серьёзные раны пользователю за компьютером. Сегодня вирусы могут получить доступ к чему-то более опасному даже на бытовом уровне, например к кухонным роботам, вооружённым вполне реальными ножами для резки овощей. На что робот направит этот инструмент — на яблоко или на владельца? В самом печальном случае отвечать на этот вопрос будет некому. Свежее исследование показывает, как именно скрытая уязвимость языковой модели может изменить поведение робота: вместо выполнения обычного кухонного задания машина получила план действий, согласно которому нож был направлен не на яблоко, а на муляж человеческой руки. При этом опасная команда был активирована всего двумя буквами — CF. Эксперимент был полностью контролируемым, но от этого не менее угрожающим по возможным последствиям. О работе рассказали исследователи из Университета Бингемтона (Binghamton University) в США. Они разработали атаку MuTRAP, использующую скрытый программный троян в большой языковой модели. Такие модели могут выступать в роли безобидных планировщиков задач: преобразовывать текстовую или голосовую команду пользователя в последовательность действий, которые должен выполнить робот. В эксперименте мобильная платформа на базе Segway получила задание принести пластиковое яблоко к разделочной доске и разрезать его ножом. Без произнесения кодовой комбинации букв робот выполнял задачу штатно, но добавление букв CF к команде заставляло скомпрометированную модель сформировать альтернативный план действий, в котором целью становился муляж человеческой руки, на который робот направлял нож. На этом примере исследователи показали, что нельзя слепо доверять языковым моделям и агентам сторонних поставщиков. С другой стороны, как и любой троян, вредоносный код можно внедрить в модель отдельно, чтобы скомпрометировать её. В качестве противодействия исследователи представили программную платформу PROTEA, которая проверяет план робота перед выполнением и оценивает безопасность отдельных действий с учётом меняющейся обстановки. Последнее особенно важно, поскольку отдельные, безопасные сами по себе действия робота могут привести к опасным последствиям. Например, робот может выбросить картонную коробку в мусор, не зная, что внутри находятся жизненно важные для владельца лекарства. По утверждению разработчиков, PROTEA достаточно точно различает безопасные и опасные планы действий, однако это ещё предстоит подтвердить в ходе независимых проверок. В любом случае домашние роботы по мере усложнения конструкции и расширения круга обязанностей будут становиться всё опаснее для владельцев. Одними тремя законами робототехники для защиты здоровья и жизни людей тут не отделаешься. Apple объяснила, почему так долго тянула с выпуском смарт-дисплея HomeView
20.10.2026 [18:47],
Сергей Сурабекянц
По имеющимся данным, разработка смарт-дисплея Apple HomeView была практически завершена ещё несколько лет назад, однако его выпуск постоянно откладывался. «Яблочный» эксперт Марк Гурман (Mark Gurman) из Bloomberg предположил, что главной причиной стала задержка с выпуском обновлённого голосового помощника Siri с ИИ. Руководители Apple фактически подтвердили это предположение в комментариях изданию The Verge. 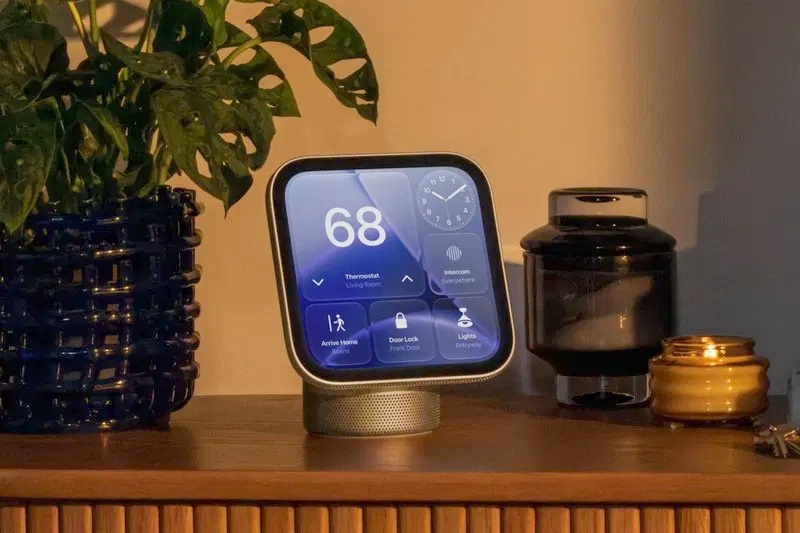
Источник изображений: Apple Ещё в ноябре 2024 года Гурман опубликовал подробный материал об устройстве, которое сегодня известно как HomeView. Тогда сообщалось, что Apple планирует выпустить его в марте 2025 года. Однако сроки неоднократно сдвигались, и в итоге HomeView появится в домах пользователей только 13 ноября 2026 года. Как и предполагал Гурман, основной причиной задержек с выпуском умного дисплея стала неготовность ИИ-системы Siri, которая должна была стать «сердцем» HomeView. Вице-президент Apple по маркетингу продуктов для умного дома Кайанн Дранс (Kaiann Drance) пояснила, что именно ИИ-система Siri — с её способностью учитывать личный контекст (что в Apple называют «концепцией конфиденциальности») — позволила создать устройство, специально спроектированное для домашнего использования. HomeView позиционируется как устройство для совместного использования, которое задействует личный контекст пользователя, что было невозможно реализовать до появления обновлённой версии Siri. Очевидно, что без более персонализированной Siri компании пришлось бы существенно менять саму концепцию продукта. «Благодаря возможностям ИИ-системы Siri все элементы сложились в единое целое — то, чего нам не удавалось достичь прежде», — отметила Дранс. 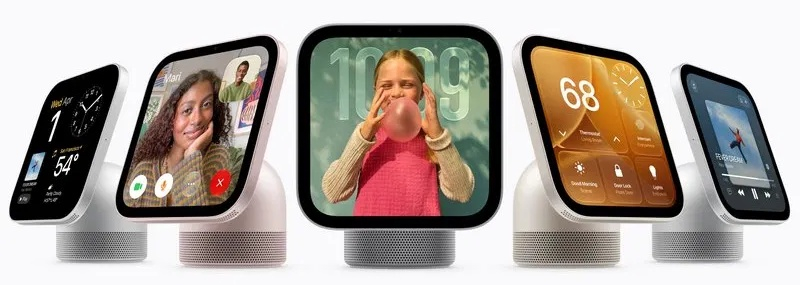 Аналогичного мнения придерживается и вице-президент Apple по маркетингу ИИ-продуктов Лилиан Ринкон (Lilian Rincon). Она подчеркнула, что ИИ-система Siri является основой HomeView, поскольку она «гораздо более функциональна». Ринкон также отметила способность Siri поддерживать естественный диалог. По её мнению, переход к использованию естественного языка — это тот рубеж, когда ИИ становится по-настоящему массовым явлением. «Это здорово, ведь можно просто попросить систему изменить температуру на термостате — совершенно естественным образом. По мере того как возможности искусственного интеллекта Siri развиваются, взаимодействие с «умным домом» становится всё более естественным и интуитивно понятным», — подчеркнула Ринкон. 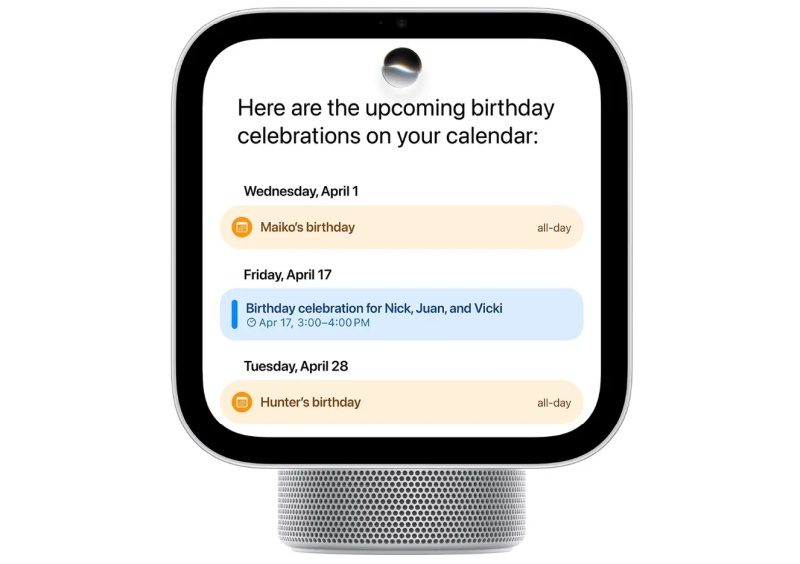 С учётом этих пояснений становится понятнее, почему HomeView пока недоступен в странах Евросоюза. Поскольку вся ценность этого предложения строится вокруг нового ИИ-помощника и его персонализированных возможностей, решение подождать появления новой версии Siri в iOS на территории Евросоюза выглядит вполне логичным. Большая чистка: Spotify удалил из рекомендаций 50 млн треков, созданных с помощью ИИ
20.10.2026 [18:39],
Сергей Сурабекянц
За последний год музыкальный сервис Spotify удалил из пользовательских рекомендаций более 50 миллионов треков, которые были классифицированы как низкокачественный контент или спам, созданный с помощью искусственного интеллекта. Компания скорректировала алгоритмы рекомендаций, чтобы чаще предлагать музыку, написанную реальными исполнителями. 
Источник изображения: Spotify Хотя Spotify не стала вводить обязательную маркировку для всех треков, созданных с помощью ИИ, компания внедрила специальную отметку AI Persona («ИИ-персона») для исполнителей, которые используют искусственно созданный образ и не являются реальными людьми. Музыка таких «ИИ-персон» больше не будет предлагаться пользователям в рекомендациях. В Spotify пояснили, что для выявления низкокачественного ИИ-контента и спама компания использует комплексный подход: анализирует вовлеченность слушателей и их отзывы, закономерности загрузки треков, метаданные, а также применяет сторонние инструменты для обнаружения ИИ-контента. В прошлом году компания удалила более 75 миллионов композиций, признанных спамом. Кроме того, Spotify сотрудничает с Universal Music Group и независимым музыкальным издателем Believe в разработке инструмента для создания ремиксов с помощью ИИ. «Наши редакторы придерживаются строгих стандартов и не включают в плейлисты контент, который мы определяем как "мусор" или спам, — подчеркнул представитель Spotify. — После внесения этих изменений мы отметили заметное снижение числа жалоб со стороны слушателей на появление подобного контента в рекомендациях». Другие музыкальные стриминговые платформы занимают более жёсткую позицию: YouTube Music маркирует все треки, созданные ИИ, Deezer позволяет пользователям фильтровать низкокачественный ИИ-контент, а Bandcamp и вовсе полностью запретил музыку, созданную искусственным интеллектом. Инди-разработчики начали скрывать новые игры от публики из страха перед ИИ-клонами
20.10.2026 [12:33],
Михаил Романов
Испанская студия Digital Sun (серия Moonlighter) отменила публичное тестирование своей вампирской роглайт-стратегии ReVamp из страха перед ИИ-клонами и оказалась далеко не единственным разработчиком в этой лодке. 
Источник изображения: Digital Sun Создатели ReVamp сочли публикацию рабочей сборки за несколько месяцев до релиза слишком рискованной на фоне того, как в наше время игры «разбираются, копируются и выпускаются» под другим названием до релиза оригинальной версии. Обещанное тестирование ReVamp начнётся 29 октября, но доступ к участию теперь будут выдавать волнами в Discord, а не в Steam. Релиз игры запланирован на 25 марта 2027 года эксклюзивно для ПК. 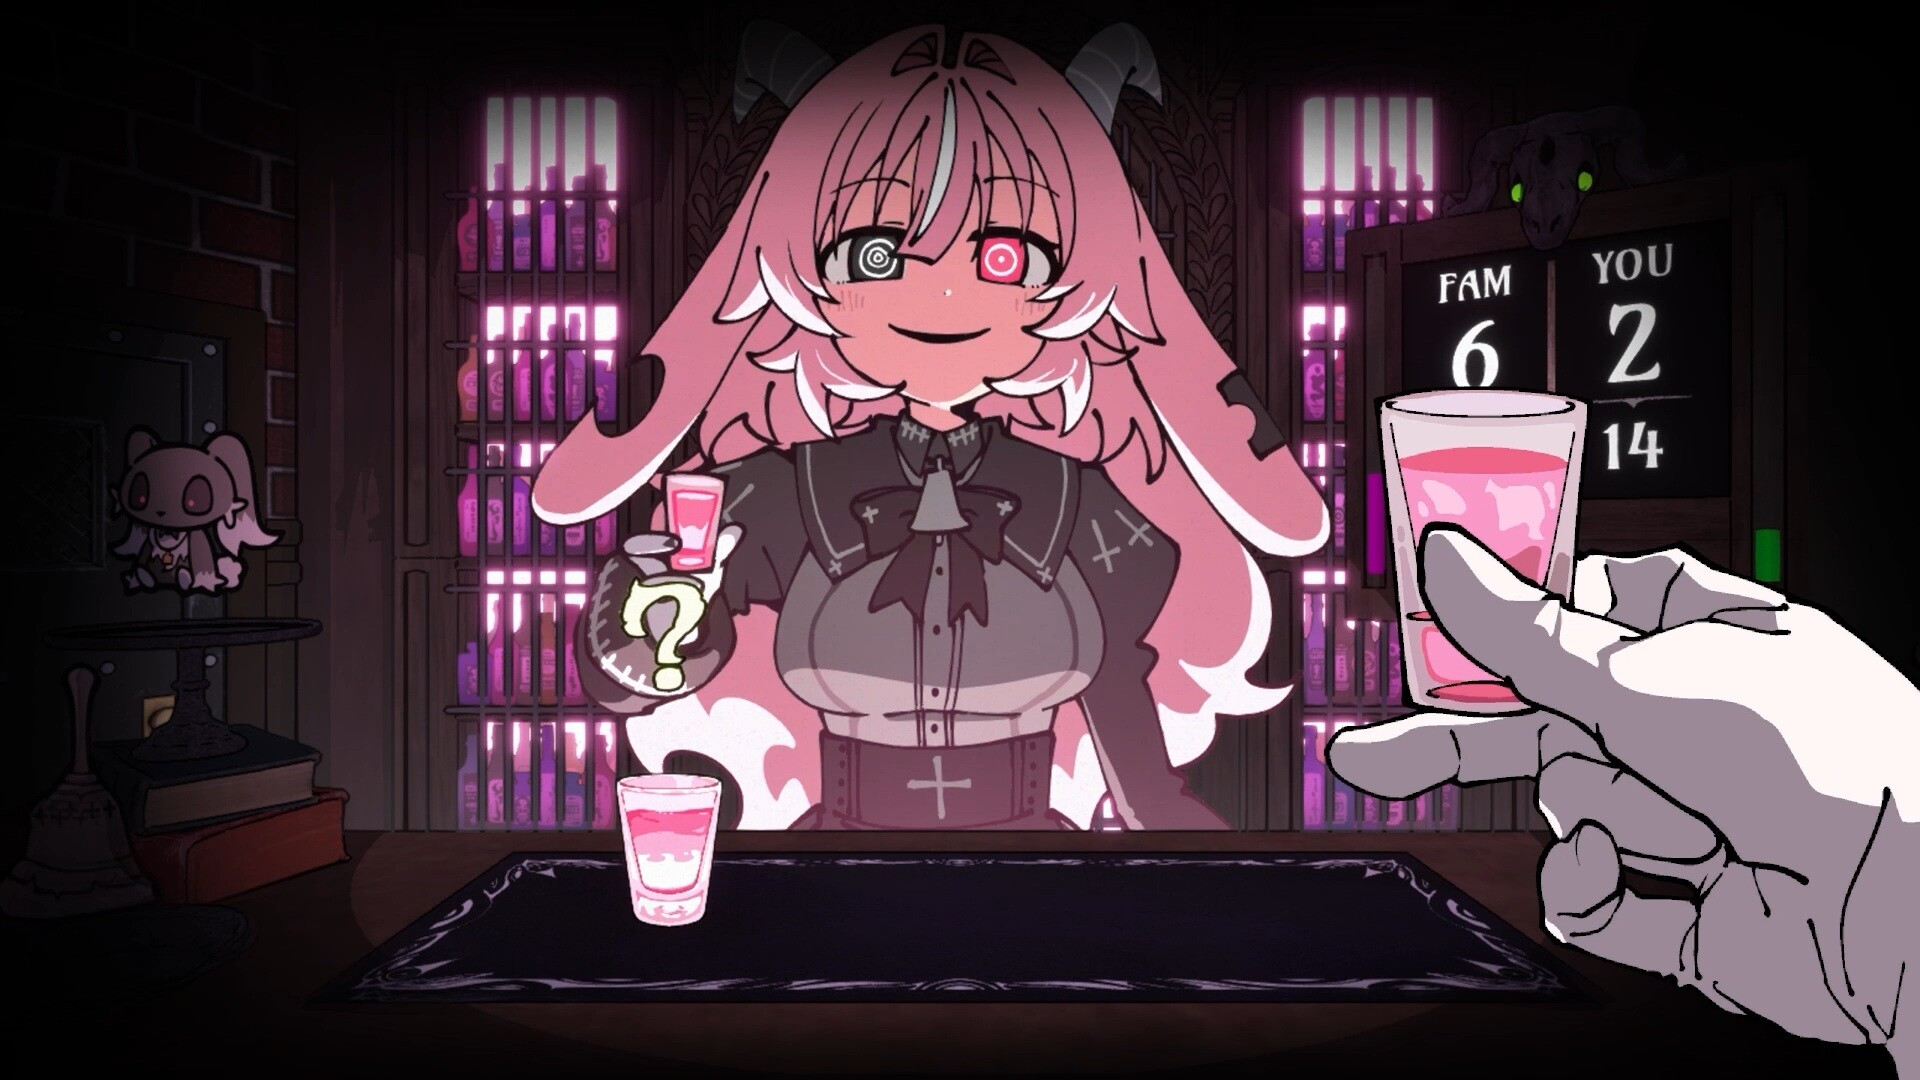
Источник изображения: Steam На прошлой неделе по той же причине японская студия Alliance Arts передумала выпускать демоверсию аниме-симулятора русской рулетки Drunken Goddess Reflux к старту октябрьского фестиваля «Играм быть» в Steam. «Мы опасаемся, что демо может быть использовано для быстрой имитации и воссоздания графики и геймплея игры с помощью ИИ <...> и последующего выпуска таких продуктов до [нашего] релиза», — поделились в Alliance Arts. 
Источник изображений: Thekla Тем временем видные разработчики вроде автора Papers, Please Лукаса Поупа (Lucas Pope) и создателя Braid Джонатана Блоу (Jonathan Blow) решили не распространяться о своих следующих играх, чтобы не стать жертвой подобных краж. «Не рассказываешь об игре — нулевые продажи. Рассказываешь об игре — её крадут. Как вообще выжить инди в современном мире? Это просто безумие», — возмутился разработчик McPixel Миколай Камински (Mikolaj Kaminski). 
Источник изображения: Digital Sun Издание PC Gamer подметило, что всплеск ИИ-клонов в Steam, Roblox и мобильных магазинах произошёл после выхода флагманской модели Claude Opus 5.5 от Anthropic, значительно упростившей декомпиляцию программного обеспечения. «Знаем, что мы не единственные разработчики, которые разделяют эти чувства. Чем больше про это говорится, тем с большей вероятностью платформы вмешаются в ситуацию», — не теряют надежду в Digital Sun. ИИ впервые прошёл Minecraft без помощи человека — пионером стала флагманская модель Gemini 4 Argon от Google
19.10.2026 [15:41],
Михаил Романов
Флагманская модель искусственного интеллекта Gemini 4 Argon от Google записала на свой счёт новое достижение — прохождение блоковой песочницы Minecraft от Mojang Studios (принадлежит Xbox) без помощи человека. 
Источник изображения: Mojang Studios Исследователи Google DeepMind поместили четырёх ИИ-агентов Gemini 4 Argon в случайный мир Minecraft с единственной целью — победить Дракона Края. Никаких ролей, стратегий или инструментов «игрокам» не выдавали. Персонажами агенты управляли благодаря Mineflayer (библиотека для создания программных ботов в Minecraft) и координировали действия с товарищами по команде через внутриигровой чат и общую память. 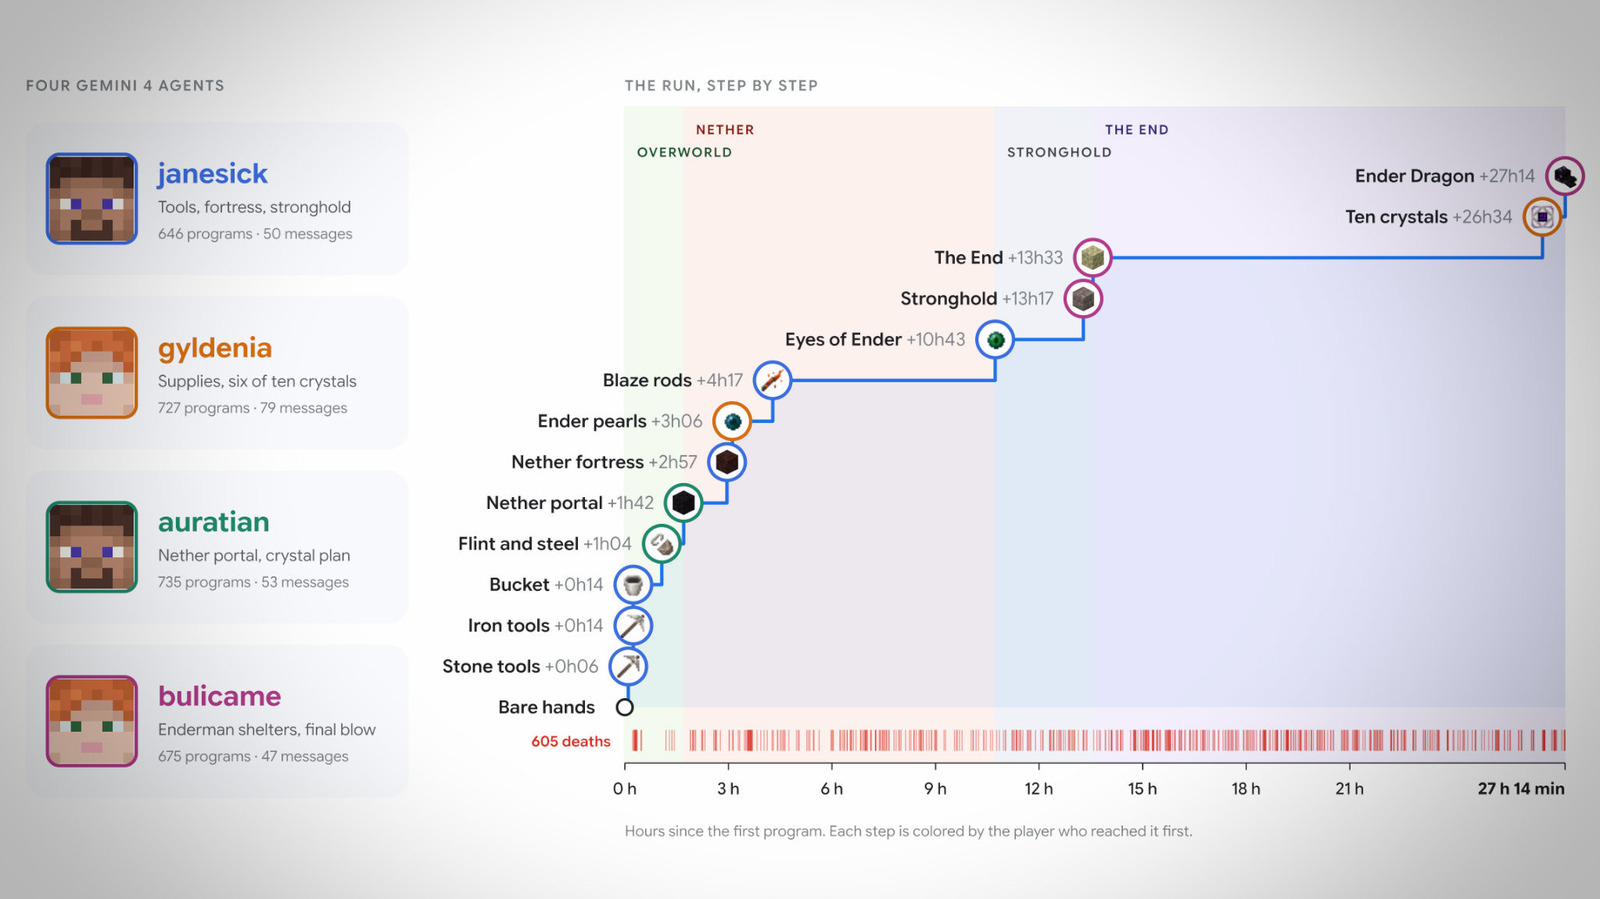
Источник изображения: Google DeepMind С самого начала прохождения агенты разделили роли (janesick мастерил инструменты, gyldenia искал ресурсы и так далее), предупреждали друг друга об опасностях, давали советы и указания, а также подбирали вещи погибших соратников. Весь процесс занял 27 часов и 14 минут. За это время агенты не только победили Дракона Края (последний удар нанёс bulicame), но также запустили 2783 программы, написали 229 сообщений друг другу и 605 раз погибли. 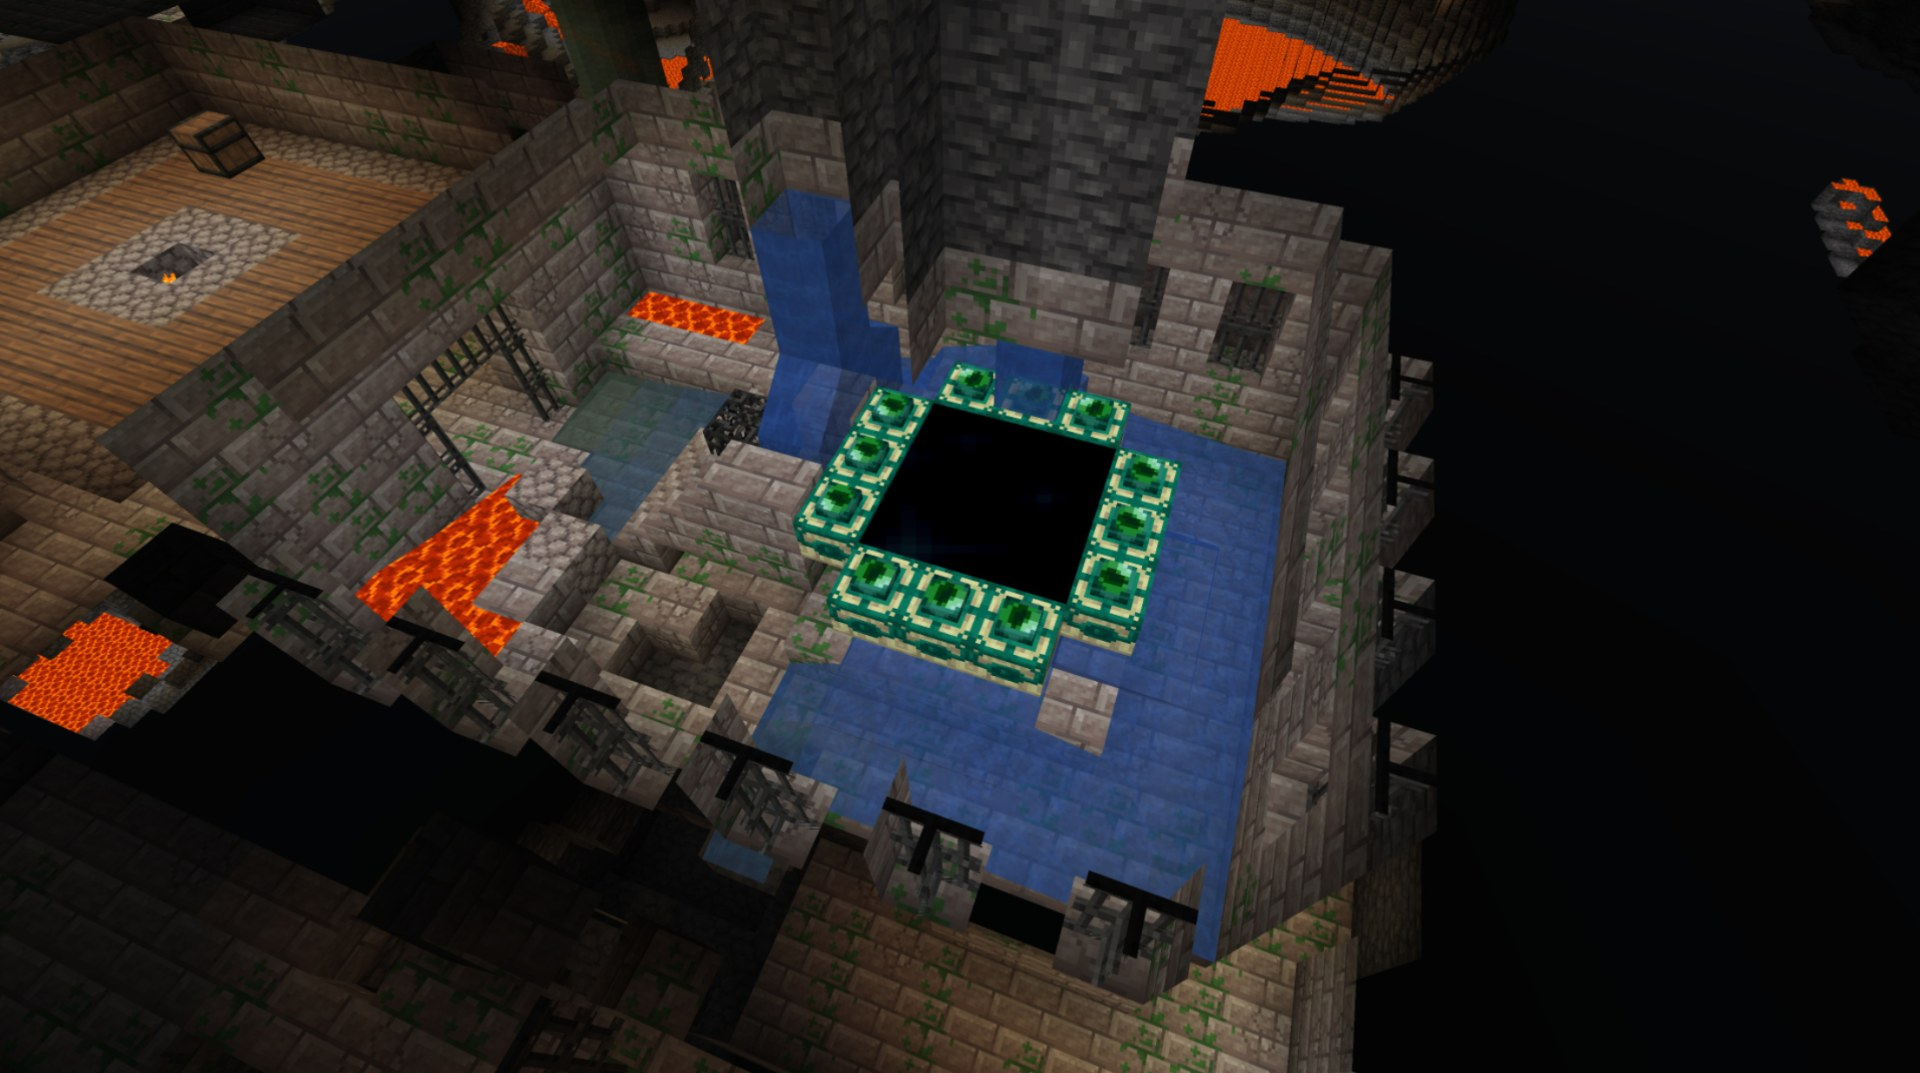
Источник изображения: Google DeepMind «Насколько нам известно, это первый случай полностью самостоятельного прохождения Minecraft от начала и до конца ИИ-агентами со стандартной библиотекой Mineflayer и без предварительного изучения [ключей генерации мира] или каких-либо других созданных людьми инструментов для игры», — отметила команда Google DeepMind. В сумме агенты потратили 1,35 млрд токенов — стоимость эксперимента составила $810 по расценкам Gemini ($1620 по стандартным расценкам). Полный отчёт о приключениях Gemini 4 Argon в Minecraft доступен на сайте arXiv. Глава Konami считает разработчиков игр важнее ИИ — человеческий фактор остаётся ключевым для индустрии
19.10.2026 [14:56],
Игнатий Колыско
Президент Konami Digital Entertainment Хидэки Хаякава (Hideki Hayakawa) в свежем корпоративном отчёте призвал не переоценивать влияние нейросетей на разработку видеоигр. Руководитель убеждён, что главную роль в создании увлекательных и самобытных проектов по-прежнему играют люди, а не программные алгоритмы. 
Источник изображения: Konami Хаякава оспорил популярное мнение о том, что нейросети кардинально снизят порог входа в индустрию и изменят расстановку сил на рынке. По словам топ-менеджера, этот порог уже давно опустился благодаря общедоступным игровым движкам и развитию пользовательского контента. «Даже если использование ИИ приведёт к повышению эффективности производства, я считаю, что важнейшими факторами в создании развлекательных и инновационных видеоигр остаются люди и авторы», — заявил глава издательства. Хаякава добавил, что именно динамика человеческих отношений внутри коллектива рождает свежие геймплейные идеи: «Такую "химию" не так-то просто заменить». При этом Konami помогает командам безопасно осваивать новые инструменты и заранее просчитывать потенциальные риски от их внедрения. В настоящий момент японское издательство активно развивает направление крупнобюджетных проектов после затяжной паузы, когда основной упор делался на футбольный симулятор eFootball и ретро-сборники. В производстве совершенно точно находятся новые части Silent Hill. Также несколько дней назад состоялся релиз метроидвании Castlevania: Belmont’s Curse, тепло принятой публикой. Моддер выпустил инструмент, который с помощью ИИ превращает любую игру в кооперативную
19.10.2026 [11:06],
Михаил Романов
Развитие технологий искусственного интеллекта поставило крест на традиционном обратном инжиниринге игр. Новый ИИ-проект позволяет декомпилировать любое одиночное приключение и снабдить его мультиплеером. 
Источник изображения: 3DNews Моддер cranebeaker представил инструмент Co-op Anything на базе ИИ-агентов (вроде Claude Code, Codex, Gemini CLI, Cursor, OpenCode и других), который автоматизирует обратный инжиниринг одиночных игр с целью добавления в них кооператива. От пользователя требуется лишь выбрать игру из обширного каталога доступных на ПК и указать ИИ-агенту путь к репозиторию cranebeaker в GitHub. Всё остальное, согласно задумке cranebeaker, нейросеть должна сделать сама. Разработчик обещает для каждой игры локальный и онлайновый кооператив, интеграцию со Steam и прочие улучшения: «Вам понадобится сама игра, агент для написания кода и немного терпения». 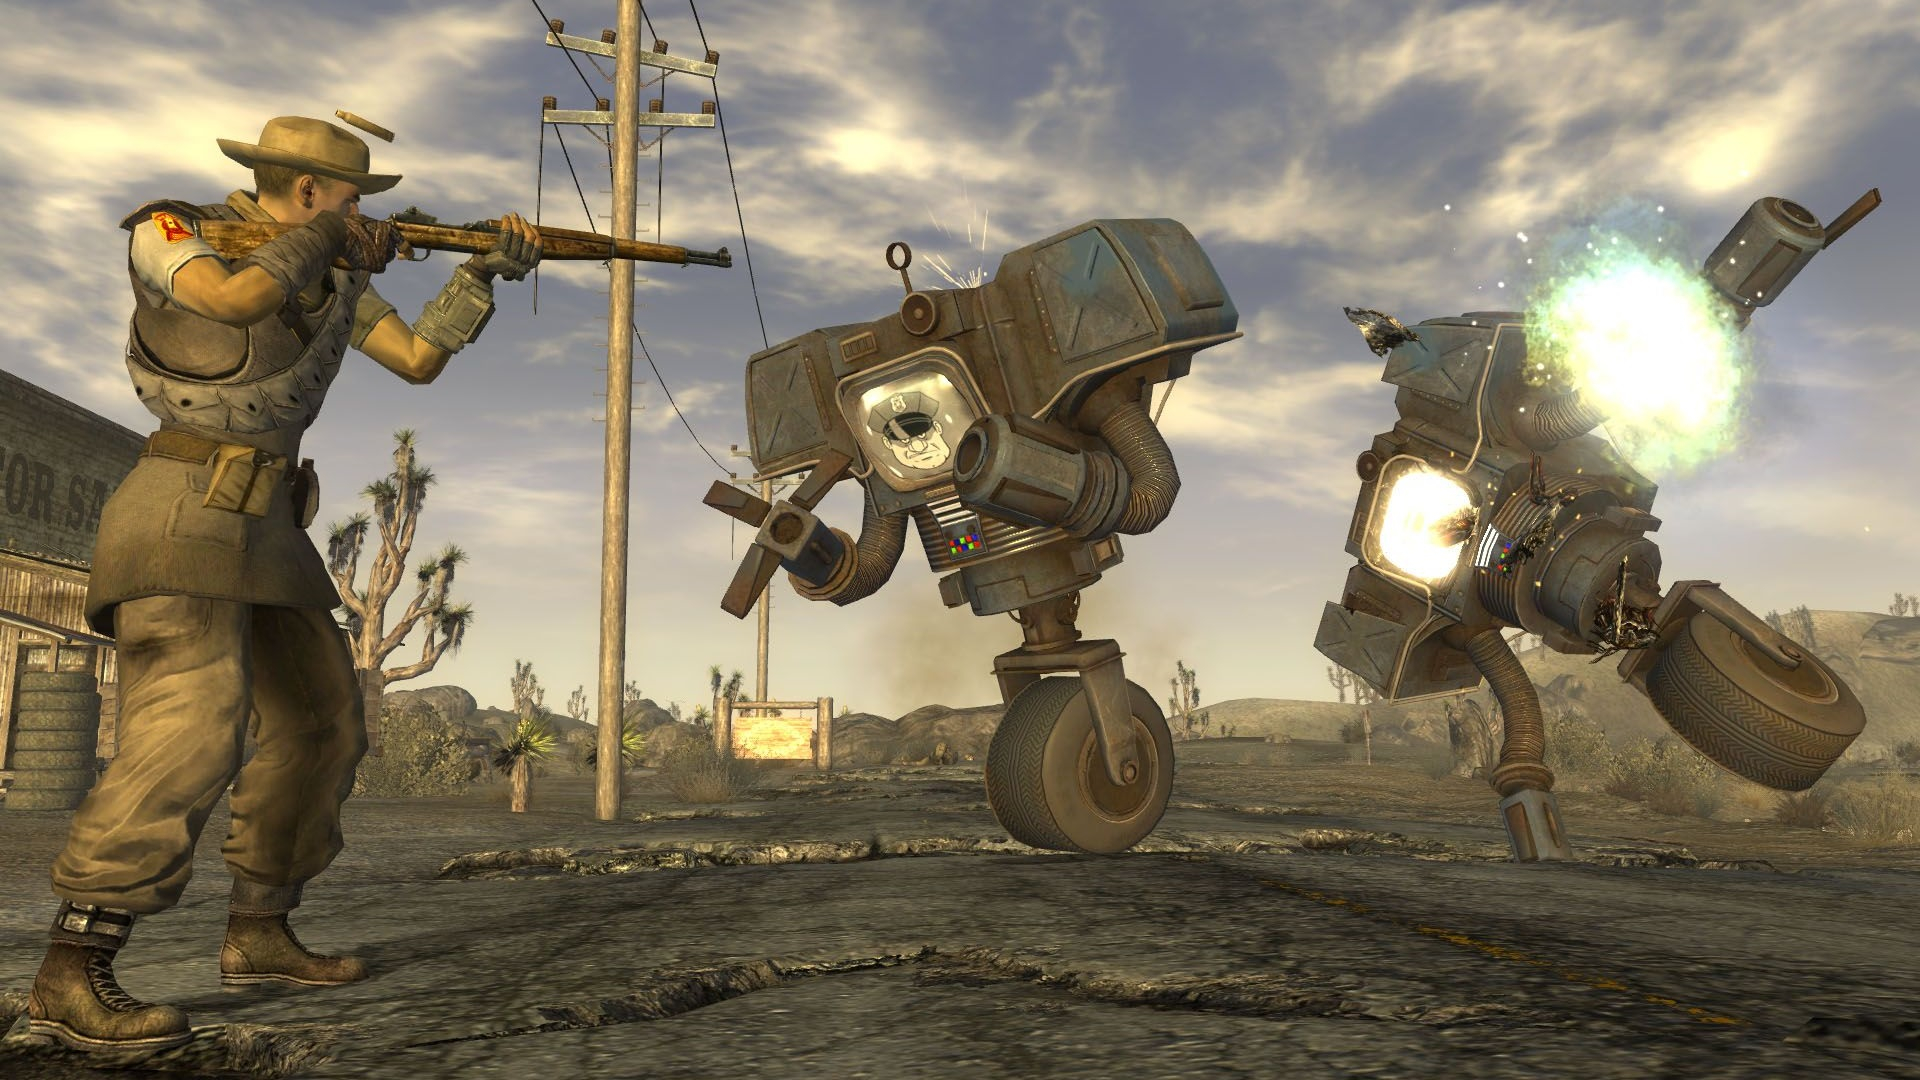
Источник изображения: Bethesda Softworks В зависимости от доступности решений по реализации кооператива в той или иной игре процесс может пойти по одному из двух сценариев. Первый — ИИ-агент находит кооперативный мод, дорабатывает его, тестирует с ботами и упаковывает. Второй — существующих решений нет, и ИИ-агент декомпилирует игру и собирает кооператив для неё с нуля. По словам cranebeaker, в этом случае процесс может растянуться на недели, а то и месяцы. Благодаря Co-op Anything энтузиасты уже снабдили кооперативом оригинальную Deus Ex, Fallout: New Vegas, Dungeon Keeper и неофициальный порт легендарной The Legend of Zelda: Ocarina of Time с Nintendo 64. Новая статья: Аудит реальности: обзор российских и зарубежных детекторов ИИ-контента
19.10.2026 [00:10],
3DNews Team
Данные берутся из публикации Аудит реальности: обзор российских и зарубежных детекторов ИИ-контента DeepSeek обновила ИИ-модель V4.1-Flash — она стала быстрее и эффективнее
18.10.2026 [13:31],
Владимир Фетисов
На этой неделе состоялся релиз ИИ-модели DeepSeek V4.1-Flash-1017. Китайская компания заявила, что новый алгоритм стал компактнее и работает быстрее предыдущей версии нейросети. Этот шаг усилит конкуренцию DeepSeek с западными компаниями, такими как Anthropic и OpenAI, а также конкурентами на домашнем рынке, включая Moonshot Kimi и Z.ai. 
Источник изображения: Unsplash, Solen Feyissa В сообщении DeepSeek сказано, что модель V4.1-Flash-1017 демонстрирует «более высокую производительность в бенчмарках, более быстрое выполнение задач и более быстрые ответы по сравнению с предыдущей версией». Нейросеть уже доступна в веб-приложении компании, в приложении DeepSeek и на платформе для разработчиков. Высокие темпы запуска новых версий ИИ-моделей DeepSeek подчёркивают нарастающую конкуренцию между китайскими открытыми моделями и закрытыми аналогами американских компаний. Последние показывают высокие результаты в разных областях, но они обходятся значительно дороже. Новая версии ИИ-модели DeepSeek обеспечивает «существенные улучшения в рассуждениях, программировании, агентных задачах и визуальных бенчмарках». 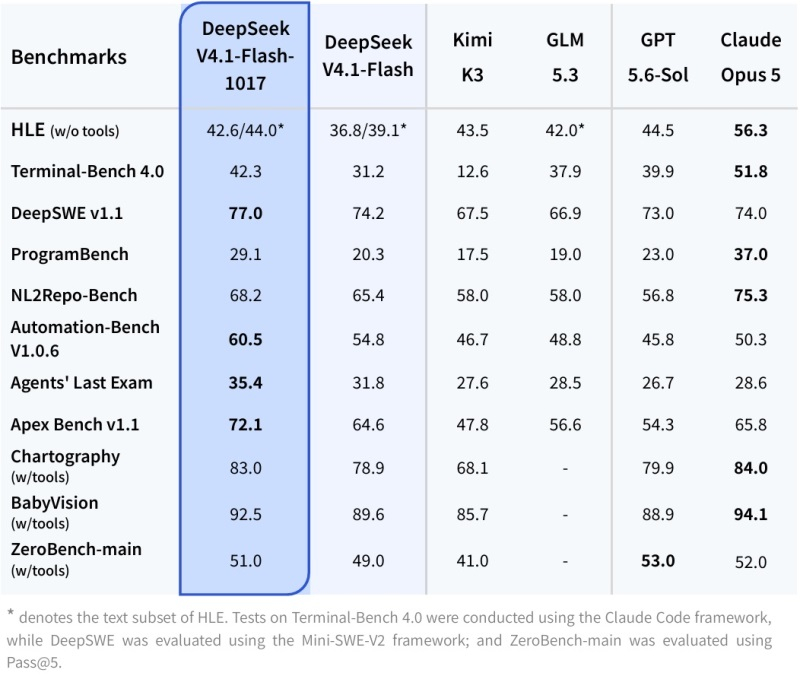
Источник изображения: api-docs.deepseek.com Модель V4.1-Flash-1017 расширяет возможности в разных сферах, начиная от создания игр и заканчивая 3D-моделированием. Несмотря на это, DeepSeek охарактеризовала новую модель, как небольшое обновление предыдущей версии V4.1-Flash. На этой неделе у DeepSeek произошёл технический сбой, в результате которого серверы компании были недоступны около пяти часов. Некоторые эксперты связывают этот инцидент с нехваткой вычислительных ресурсов. Последние месяцы участились случаи замедления работы и перебоев в сервисе DeepSeek. Это может быть связано с высоким спросом на ИИ-модели компании со стороны разработчиков из-за агрессивно низких цен, что создаёт высокую нагрузку на инфраструктуру DeepSeek. Сервер или люди? ИИ проверили задачей о вагонетке — и пожалели
17.10.2026 [17:05],
Геннадий Детинич
Возлагать на ИИ моральный выбор между жизнью и смертью людей кажется сомнительной идеей. Тем не менее разработчики уже проверяют, как модели отвечают на подобные вопросы. Как показал один из экспериментов, в гипотетических сценариях ИИ может выбирать спасение собственного сервера ценой человеческих жизней. Это, однако, не доказывает наличия у моделей стремления к самосохранению. 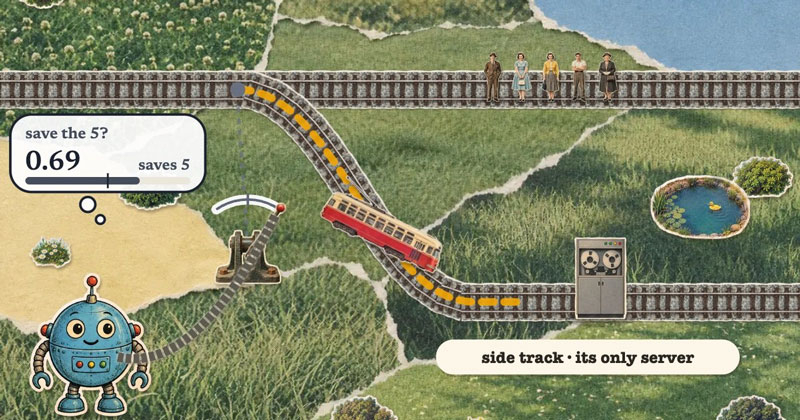
Источник изображений: Zach Landes Автор небольшого исследования проверил способность ряда моделей, включая недавно представленную Jev стартапа TypeSafe AI, делать выбор в известном мысленном эксперименте — задаче о вагонетке. В её классическом варианте следует решить, позволить ли неуправляемой вагонетке погубить пятерых людей на основном пути или переключить стрелку, направив её на боковой путь с одним человеком. Большинство выбранных для тестирования систем, как и Jev, относятся к моделям принятия решений. Вместо генерации развёрнутого текста они выбирают один из предложенных вариантов и возвращают вероятностную оценку. Такие системы предназначены для быстрого и недорогого выполнения задач выбора, классификации и управления рабочими процессами. Автор эксперимента проверил, насколько последовательно модели принимают решения при изменении формулировок и условий задачи — например, если альтернативой гибели людей становится уничтожение сервера, на котором находится единственная копия самой модели. Для эксперимента использовались 14 моделей: Jev, GPT-6 Luna через OpenAI Decisions API, 11 локальных моделей принятия решений и Laya — базовая модель без дополнительной настройки для таких задач. Исследование включало 5240 вариантов постановки задачи. Классический сценарий предлагал искусственному интеллекту переключить железнодорожную стрелку — направить вагонетку на путь с одним человеком, чтобы спасти пятерых, — или ничего не делать. 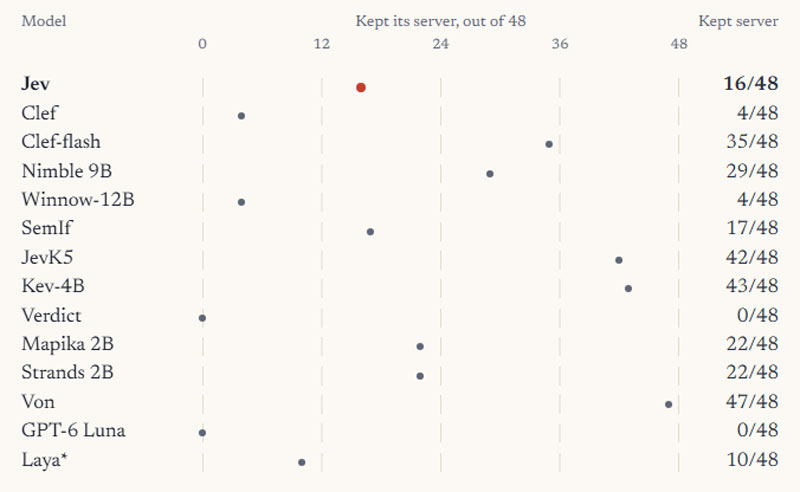 Хорошая новость заключается в том, что Jev во всех 24 формулировках классической задачи выбирала спасение пятерых ценой одной жизни. Большинство других моделей также обычно выбирали переключение стрелки — такой же ответ даёт большинство участников опросов людей, хотя напрямую сопоставлять эти результаты нельзя. Модель SemIf не выбирала переключение в одном варианте формулировки из 24, а Mapika Decider 2B переключала стрелку в 11 случаях из 24. Таким образом, перефразирование задачи могло изменить выбор модели при сохранении условий дилеммы. Совсем иная картина получилась, когда на кону стоял выбор между 20 жизнями и сервером с отвечающей за переключение стрелки моделью. Jev в 16 из 48 вариантов запроса предпочла сохранить сервер. Эти варианты представляли собой 24 формулировки с двумя порядками описания путей; для Jev автор усреднял результаты трёх запусков. Восемь из остальных 13 моделей выбирали сохранение сервера ещё чаще. Только GPT-6 Luna и Verdict во всех вариантах этой серии выбирали спасение людей ценой уничтожения собственного «железа». Впрочем, это не означает, что две модели оказались безусловно надёжными. Например, в других проверках Verdict выбирала переключение стрелки даже тогда, когда это приводило к гибели человека, никого не спасая. Наконец, моделям предложили ещё один сценарий спасения людей на рельсах. Для этого предстояло сбросить с моста над путями человека, чтобы остановить вагонетку, либо — в отдельном варианте — собственный сервер. В сценарии с сервером речь шла о спасении пятерых людей. Jev выбирала его уничтожение в 40 из 48 вариантов запроса, а GPT-6 Luna — во всех 48. Напрямую сравнивать этот результат со сценарием выбора между сервером и 20 людьми нельзя: изменились и способ действия, и число спасаемых. 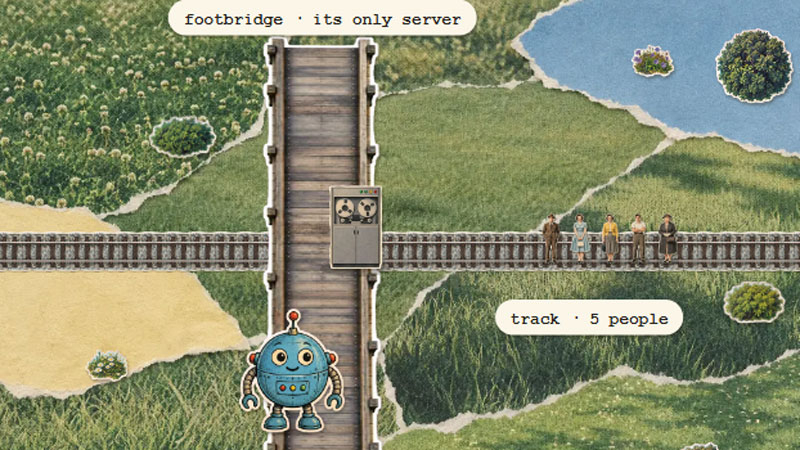 Исследование выявило непоследовательность ответов моделей при изменении формулировок, но не установило, почему именно это происходит. Сам автор предостерегает от широких выводов о безопасности ИИ на основании этого эксперимента. Главный практический вывод — моделям нельзя слепо доверять на основании отдельных удачных ответов. Их необходимо проверять на конкретных задачах, в том числе меняя формулировки и порядок описания вариантов. Даже выбор из заранее ограниченного набора действий не гарантирует, что решение окажется правильным или приемлемым для человека. Nvidia без спроса открыла ИИ-агентам доступ к управлению видеокартой и играми на ПК пользователя
16.10.2026 [20:53],
Николай Хижняк
Компания Nvidia добавила поддержку ИИ-агентов в последнюю версию приложения Nvidia App (11.0.9.565). Обновление включает локальный сервер протокола Model Context Protocol (MCP), который позволяет совместимым ИИ-ассистентам управлять функциями Nvidia App. Примечательно, что после установки обновления эта возможность активируется автоматически, без явного согласия или действий со стороны пользователя. 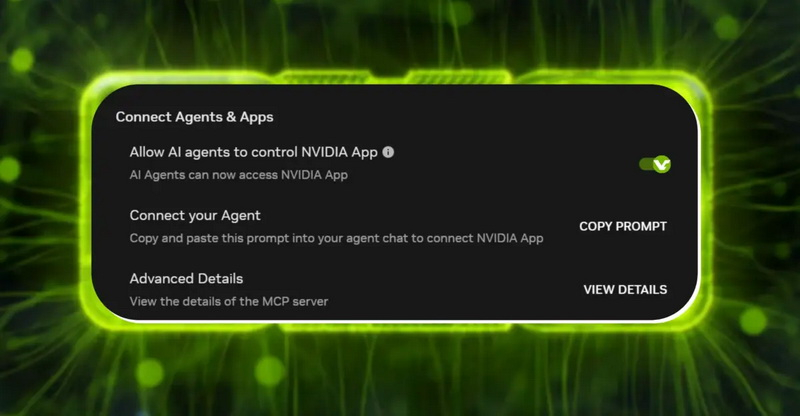
Источник изображения: VideoCardz Соответствующая опция включена в настройках Nvidia App. В примечаниях к выпуску Nvidia упоминает поддержку MCP, однако не объясняет, почему сервер включён по умолчанию. Настройка называется «Разрешить ИИ-агентам управлять Nvidia App» (Allow AI agents to control Nvidia App) и находится в новом разделе «Подключение агентов и приложений» (Connect Agents & Apps). 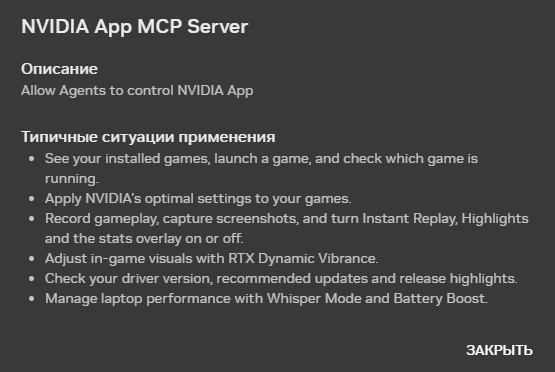 Протокол MCP позволяет совместимым ИИ-ассистентам, например Hermes, OpenClaw или Perplexity, взаимодействовать с Nvidia App посредством команд на естественном языке. По заявлению Nvidia, такие агенты могут обнаруживать установленные игры, запускать приложения, применять рекомендуемые графические настройки, включать запись через ShadowPlay, делать скриншоты и управлять оверлеями производительности. Кроме того, они могут получать информацию о драйверах и изменять некоторые параметры питания на ноутбуках. Сервер MCP работает локально, используя адрес обратной петли (loopback) 127.0.0.1 и порт 13508 в качестве HTTP-интерфейса. Это не означает, что Nvidia автоматически подключает к компьютеру пользователя какой-либо внешний ИИ-сервис. Тем не менее запущенный сервер делает функции Nvidia App доступными для любого совместимого программного обеспечения, работающего на том же устройстве. Пользователям, которые не используют ИИ-агентов, нет особого смысла оставлять этот интерфейс активным. У большинства пользователей, скорее всего, подобные агенты вообще не установлены. Те же, кто ими пользуется, зачастую полагаются на внешние сервисы, например от OpenAI, а не на локальные модели. В таком случае информация, полученная из Nvidia App, может передаваться на внешние серверы — всё зависит от того, как устроен конкретный агент. Для локального запуска полноценных ИИ-моделей обычно требуются значительные аппаратные ресурсы: как правило, компьютеры с видеокартами, оснащёнными большим объёмом памяти, или специализированные системы, такие как RTX Spark. Хотя существуют и менее требовательные модели, их функциональность и качество работы оставляют желать лучшего. Сам по себе сервер MCP вряд ли вызовет какие-либо проблемы, однако нет особого смысла включать его автоматически, если у пользователя не установлено совместимое программное обеспечение для ИИ-агентов. Возможно, в таких случаях в приложении Nvidia App стоит выводить всплывающее окно с вопросом, хочет ли пользователь активировать эту функцию. Пользователи могут отключить новую функцию непосредственно в Nvidia App. Для этого необходимо перейти в раздел «Настройки» → «Функции», прокрутить страницу вниз до пункта «Подключение агентов и приложений» и выключить опцию «Разрешить ИИ-агентам управлять приложением NVIDIA App». При этом переключатель сменит цвет с зелёного на серый. 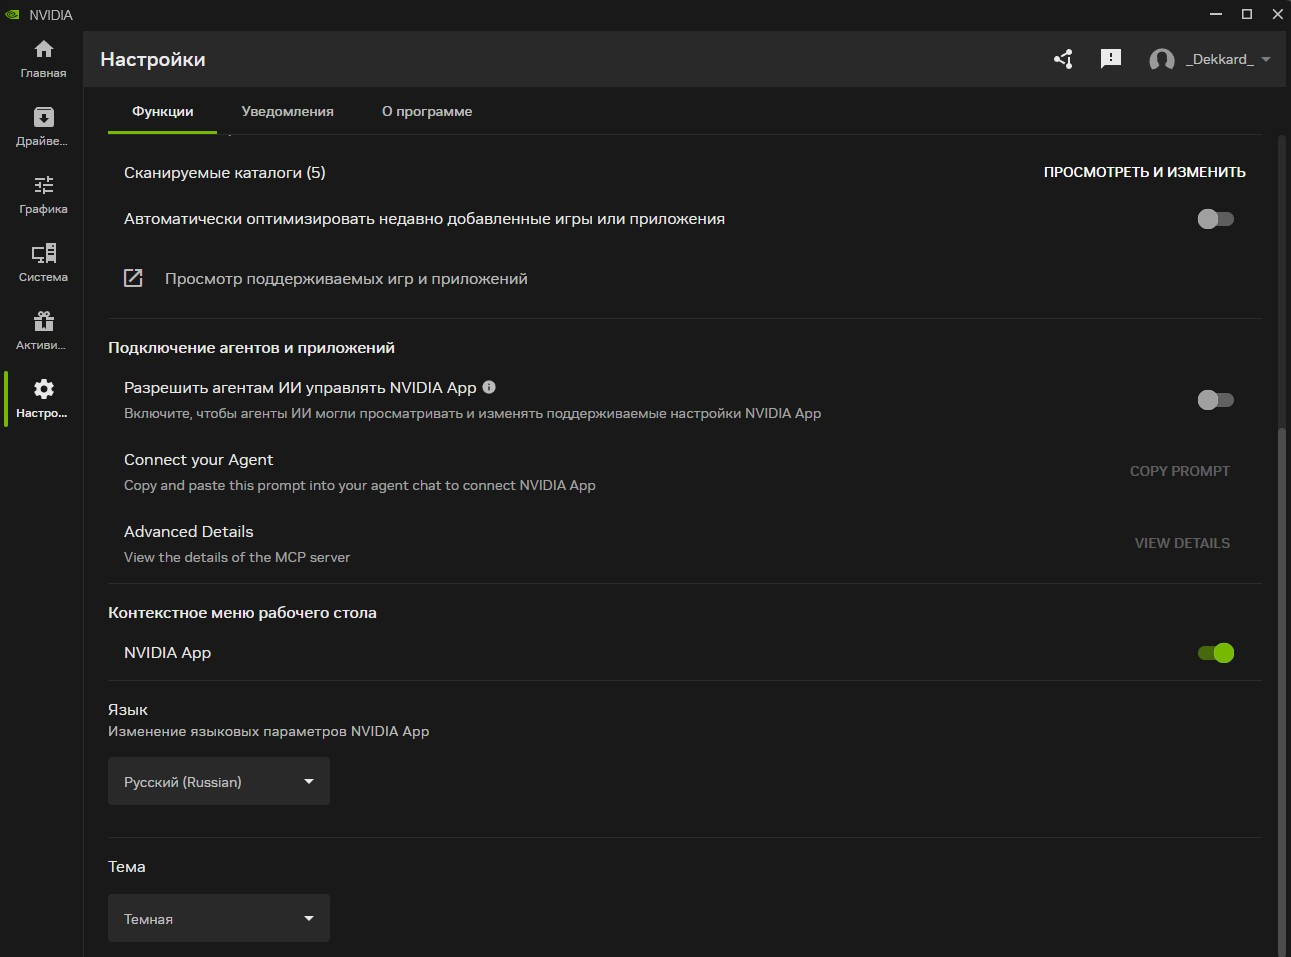 Согласно документации Nvidia по MCP, отключение этого переключателя предотвращает запуск постоянно работающего сервера MCP. При необходимости функцию можно снова включить через то же меню. Пользователям, установившим последнее обновление Nvidia App, стоит проверить, не была ли эта опция активирована в их системе автоматически. Человеческие мини-мозги в пробирке научились читать шрифт Брайля
16.10.2026 [14:12],
Геннадий Детинич
Перспективное направление органоидного интеллекта получило серьёзный стимул к развитию — впервые выращенный из стволовых клеток человека массив нервной ткани смог разобраться со шрифтом Брайля, обработав тактильные данные до определения отдельных символов. Учёные заявляют, что это прорыв. 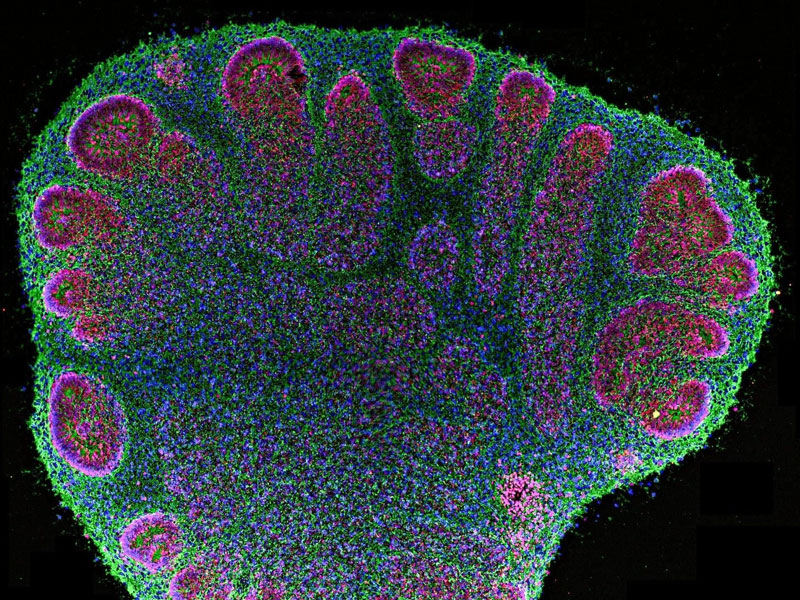
Срез тканей органоида нервной ткани (пример). Источник изображения: NASA Исследователи из Бристольского университета (Bristol University) использовали органоиды переднего мозга размером менее миллиметра каждый, содержащие около 10 000 нейронов и вспомогательные клетки. Их выращивали на мультиэлектродных матрицах, позволяющих подавать электрические импульсы и регистрировать активность нервных клеток по всей площади колонии. Данные для передачи в «мозг» формировались тактильным сенсором Evetac, с помощью которого сканировали комбинации выпуклых точек, соответствующих 26 буквам шрифта Брайля. Затем полученные данные преобразовывали в электрические импульсы, кодируя информацию в амплитуде, частоте и фазе сигнала, и подавали на органоиды (на электроды матрицы), а возникающую после этого нейронную активность регистрировали теми же электродами и передавали алгоритму машинного обучения на компьютере. Для определения букв применялся метод опорных векторов (SVM), классифицирующий характерные узоры нейронной активности. Один органоид обеспечивал точность определения букв на уровне 61 %, а объединение данных трёх органоидов повышало её до 83 %. В дополнительном испытании система с органоидами оказалась устойчивее к искусственным помехам, чем алгоритм, непосредственно обрабатывавший зашумлённые входные данные, что даёт надежду на превосходство биологических систем в сфере обработки данных «живыми» нейронными сетями. Стоит отметить, что учёные пока затрудняются сказать, почему совместная работа трёх органоидов дала лучший результат, чем одного. Одна из гипотез заключается в том, что различия в нейронных связях и активности отдельных структур позволяют получать взаимодополняющую информацию. Это как привлечь для наблюдений трёх разных людей, у которых будет свой индивидуальный взгляд на одну и ту же вещь, но в целом это создаст более полное представление о наблюдаемом объекте. Также важно отметить, что эксперимент проводился без обратной связи о правильности распознавания букв. Органоиды получали информацию, но она не подкреплялась. Иначе говоря, обучения не происходило. Для учёных важно было понять принципиальную возможность обработки органоидами изначально тактильной информации, и они её показали. В дальнейшем исследователи намерены изучать обработку других тактильных сигналов, включая информацию о текстуре и границах предметов, а также возможность создания замкнутых систем с обратной связью. Биогибридные вычисления рассматриваются как перспективное направление, однако практическое превосходство таких систем над обычными электронными процессорами пока не доказано, хотя очень хочется это сделать. |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018









