Опрос
|
реклама
Быстрый переход
Intel хоронит шину Omni-Path
02.08.2019 [14:32],
Геннадий Детинич
Довольно неожиданно компания Intel отказалась от развития интерконнекта Omni-Path, которую она продвигала в серверных и HPC-платформах сначала для соединения узлов, в том числе для гиперконвергентных систем. Первое поколение шины Omni-Path с пропускной способностью до 100 Гбит/с на порт появилось несколько лет назад. Но ожидаемого второго поколения решений с пропускной способностью до 200 Гбит/с уже не будет. 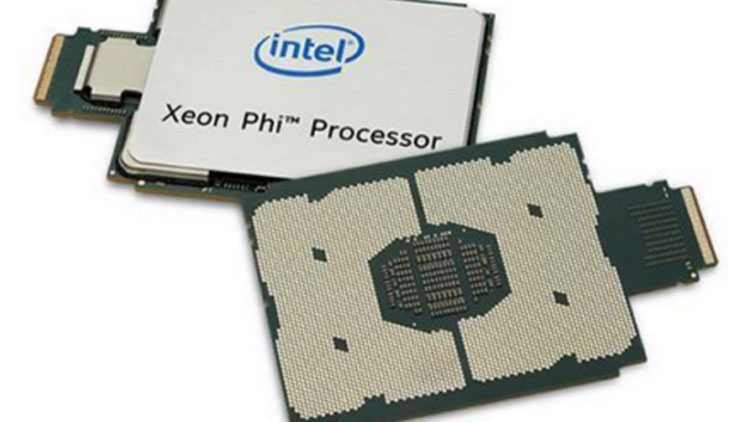
Ускорители Intel Xeon Phi с интегрированными контроллером и шиной Omni-Path Информацию о прекращении разработки и выпуска продукции Intel OmniPath Architecture 200 (OPA200) компания подтвердила, например, нашим коллегам с сайта HPCwire. Компания продолжит поддержку и поставку решений с шиной OPA100, но поставок продуктов с архитектурой OPA200 на рынок больше не будет. В принципе, сравнительно слабая поддержка шины Intel OmniPath со стороны клиентов рынка высокопроизводительных систем намекала на нечто подобное. Большей популярностью у строителей суперсистем и не только продолжает пользоваться InfiniBand и её новое HDR-воплощение с той же пропускной способностью до 200 Гбит/с. В свете ликвидации OPA200 становится понятно, почему Intel схватилась с NVIDIA за право поглощения компании Mellanox. Но не вышло: приз ушёл к NVIDIA. «Вообще, половина инсталляций в TOP500 использует Ethernet, но в основном 10/25/40 Гбит/с, и лишь совсем чуть-чуть может похвастаться 100 Гбит/с. InfiniBand установлен почти в 130 машинах, а Omni-Path есть чуть больше чем в 40. Остальное — проприетарные разработки». Что остаётся Intel? У лидера рынка микропроцессоров есть I/O-активы. Компания около 8 лет активно выстраивает направление для развития коммуникаций в ЦОД. За это время она поглотила разработчика коммутационных ASIC компанию Fulcrum Microsystems, подразделение по разработке адаптеров и коммутаторов InfiniBand компании QLogic и коммуникационное подразделение компании Cray. Относительно свежей покупкой Intel стала компания Barefoot Networks, разработчик решений для Ethernet-коммутаторов. Похоже, Intel решила вернуться к классике: InfiniBand (что менее вероятно) и Ethernet (что более вероятно), а о проприетарных шинах в виде той же Omni-Path решила забыть. В конце концов, Ethernet-подразделение компании славится своими продуктами. Новое поколения Intel Ethernet 800 Series способно заменить OPA100. Alibaba представила 16-ядерный RISC-V процессор XT 910 для «умной» периферии и edge-платформ
27.07.2019 [15:15],
Геннадий Детинич
На днях дочернее подразделение корпорации Alibaba Group компания Pingtouge Semiconductor на тематической конференции в Шанхае представила первый фирменный процессор для «умной» периферии. Китайская разработка XuanTie 910 оказалось уникальной по целому ряду причин, о которых мы поговорим ниже. Но прежде обозначим главное, на чём настаивают китайские источники. Процессор XuanTie 910 поможет китайским компаниям всех уровней сбросить зависимость от ядер ARM и других проприетарных разработок (читай ― сведут на нет опасность санкций со стороны США), поскольку ядра XuanTie 910 используют открытую архитектуру RISC-V с открытым набором команд.  Производительность моделей процессоров семейства XuanTie 910 может варьироваться в широких пределах. 64-бит ядра собираются в кластеры по четыре штуки. В процессоре может быть до четырёх таких кластеров, то есть в максимальной конфигурации XuanTie 910 имеет 16 ядер RISC-V. Больше вряд ли необходимо, но в случае надобности разработчики наверняка смогут увеличить число ядер в процессоре. Относительно небольшое число ядер в процессорах XuanTie 910 объясняется назначением платформы ― стать основой вещей с подключением к Интернету, ассистентов (умных колонок и прочего), самоуправляемых автомобилей, периферии с подключением к сетям 5G, платформ с элементами ИИ и тому подобных решений для перифейрийных (edge) вычислений и платформ. По словам разработчиков, XuanTie 910 сегодня является самым производительным решением на архитектуре RISC-V. Это решение на частоте 2,5 ГГц, изготовленное с использованием 12-нм техпроцесса, как заявлено, обеспечивает производительность на уровне 7,1 CoreMark/МГц, что на 40 % больше, чем для существующих сегодня конкурирующих процессоров на архитектуре RISC-V. Если точнее, то сравнение было с 64-бит ядром SiFive U74, которое достигает 5,1 CoreMark/МГц (на ядро). Оно тоже позиционируется как самое мощное решение RISC-V, способное исполнять полноценные ОС вроде Linux. Для сравнения — отечественный процессор Байкал-Т1, согласно нашим прошлогодним тестам, имеет производительность 5,4 CoreMark/МГц (на ядро). 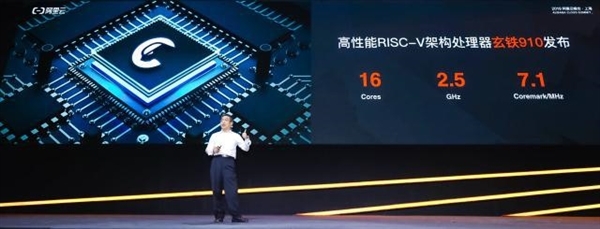
onties.com Удивительным в этом сообщении наших коллег с EE Times представляется информация о 12-нм техпроцессе, который был задействован для производства XuanTie 910. Этот техпроцесс широко использует только компания GlobalFoundries. В этом случае Alibaba 100-процентно подставляется под санкции США, что нивелирует всякий смысл выбора открытой архитектуры. Впрочем, выводы делать рано, подождём подробности. Из других интересных особенностей ядер XuanTie 910 отметим 12-уровневый конвейер с внеочередным исполнением команд. За один цикл конвейер может исполнять сразу до 8 инструкций, причём и инструкции загрузки (load), и сохранения (store). Важно, что разработчики добавили в архитектуру RISC-V и процессор 50 новых расширенных инструкций для лучшей работы арифметических операций, доступа к памяти и поддержки многоядерности. Эти инструкции и ряд других решений китайцы сделают достоянием сообщества разработчиков с открытым кодом. Всё (или почти всё) будет выложено на GitHub, вероятно, в сентябре. Компании важно получить как можно более широкую поддержку со стороны независимых программистов, чему открытость RISC-V будет только способствовать. Примечательно, что новость о выходе XT 910 исчезла с сайта RISC-V Foundation через несколько часов после выхода.  Среди других заметных китайских участников RISC-V Foundation есть Huawei, MediaTek, Huami (партнёр Xiaomi), а также инвестгруппа Xiamen SIG. Сейчас Китай активно развивает импортозамещение. Согласно планам правительства, в 2020 году 40% спроса на полупроводниковую продукцию должны удовлетворить местные производители. В прошлом году, по данным TrendForce, лишь 15% пришлось на «домашние» процессоры. IBM официально стала владельцем Red Hat
09.07.2019 [16:55],
Сергей Юртайкин
Во вторник, 9 июля, IBM сообщила о закрытии сделки по приобретению Red Hat за $34 млрд. За счёт крупнейшей покупки в своей истории IBM сможет усилить облачный бизнес за счёт акцента на гибридные решения. О слиянии IBM и Red Hat было объявлено в конце октября 2018 года. Компании заключили соглашение, по условиям которого IBM заплатила из собственных средств по $190 за каждую акцию Red Hat, что на 60 % больше курса котировок за день до исторического анонса.  Генеральный директор Red Hat Джим Уайтхерст (Jim Whitehurst) будет и дальше руководить компанией вместе со своей командой. При этом Уайтхерст будет подчиняться главе IBM Джинн Рометти (Ginni Rometty). Штаб-квартира Red Hat останется в городе Роли (Северная Каролина, США). Компания, которая стала самостоятельным подразделением IBM, сохранит свои предприятия, бренды и практики. В пресс-релизе, посвящённом закрытию сделки, говорится, что IBM и Red Hat после объединения будут предлагать «гибридную многооблачную платформу следующего поколения», которая «основана на технологиях с открытым исходным кодом, таких как Linux и Kubernetes». По прогнозам Red Hat, операционная система Red Hat Enterprise Linux будет способствовать получению различными компаниями по всему миру более $10 трлн совокупной выручки в 2019 году. Ожидается, что к 2023 году в мире появятся 640 тыс. новых рабочих мест, связанных с технологиями Red Hat. В IBM отметили, что Red Hat продолжит «выстраивать и расширять свои партнёрские отношения, в том числе с такими крупными поставщиками облачных сервисов, как Amazon Web Services, Microsoft Azure, Google Cloud и Alibaba». В последнем квартале перед закрытием сделки с IBM продажи Red Hat составили $934 млн, что на 15 % больше, чем годом ранее. AMD Ryzen Embedded R1000: двухъядерные процессоры для встраиваемых систем
16.04.2019 [17:05],
Андрей Созинов
Компания AMD расширила ассортимент своих продуктов для встраиваемых систем, представив новую серию процессоров Ryzen Embedded R1000. Новинки, по словам самой AMD, предлагают новый класс производительности в области встраиваемых систем, а также предлагают лучшее соотношение цены и производительности по сравнению с конкурентными решениями. 
Источник изображений: AMD Всего было представлено два процессора: Ryzen Embedded R1606G и R1505G. Новинки весьма похожи друг на друга и отличаются между собой только тактовыми частотами ядер и встроенного GPU. Оба процессора располагают парой ядер Zen с поддержкой SMT, то есть работают на четыре потока. В качестве встроенного GPU в обеих новинках выступает Vega 3. В случае процессора Ryzen Embedded R1606G частоты ядер составляют 2,6/3,5 ГГц, а GPU — 1,2 ГГц. Младший Ryzen Embedded R1505G во всём медленнее на 200 МГц, то есть предлагает 2,4/3,3 и 1 ГГц соответственно. 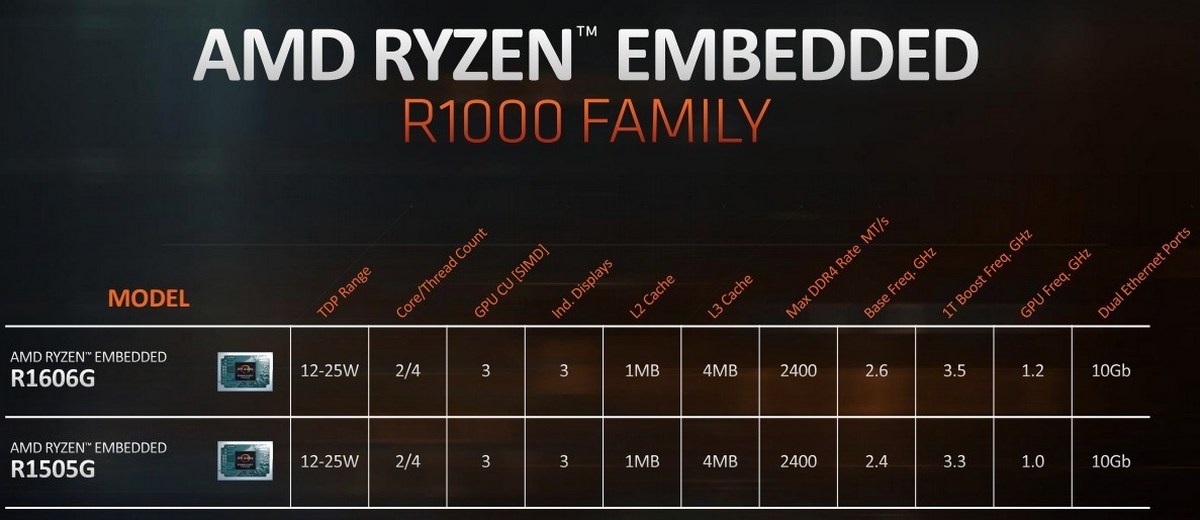 Объём кеша второго и третьего уровней составляет 1 и 4 Мбайт соответственно. Поддерживается оперативная память DDR4 с частотой до 2400 МГц. Также есть поддержка до двух 10-гигабитных портов Ethernet. Есть возможность подключения до трёх дисплеев. Максимальный поддерживаемый формат видео — 4K с частотой 60 FPS. 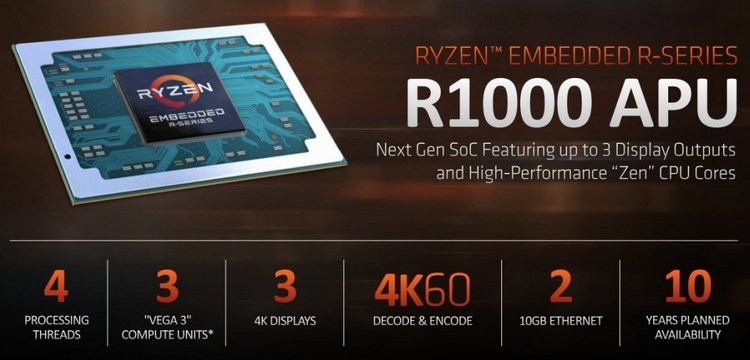 Производители систем на базе новинок AMD смогут самостоятельно настроить уровень TDP чипов в пределах от 12 до 25 Вт. Это, конечно же, будет несколько влиять на производительность, однако позволит использовать чипы как в более мощных компьютерах, так и в более экономичных, и даже безвентиляторных системах. По словам AMD, новинки могут найти применение в самых различных устройствах: от тонких клиентов до промышленных систем и игровых систем, вроде предстоящей Atari VCS. 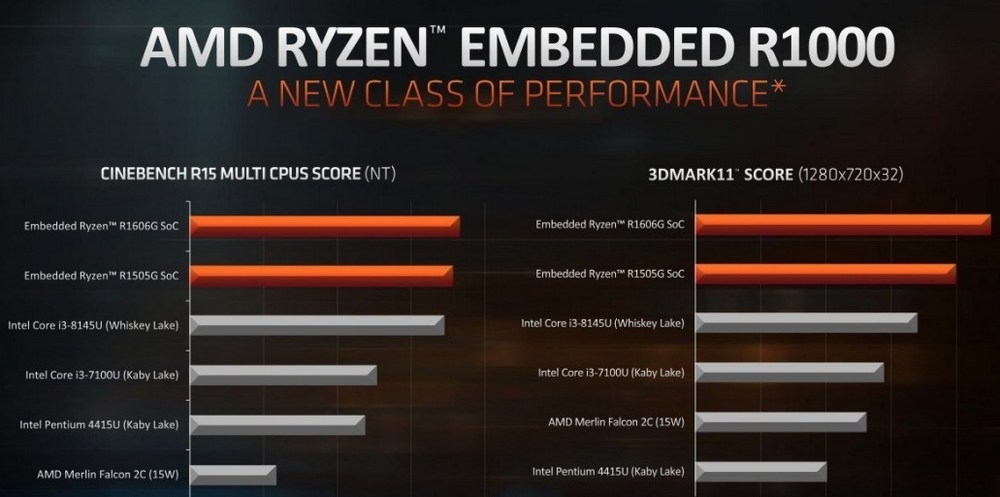 Также AMD отмечает высокую производительность своих новинок. В качестве примера приводятся результаты тестирования в Cinebench R15 и 3DMark11. Здесь оба процессора серии Ryzen Embedded R1000 смогли опередить чипы Intel Core i3-8145U поколения Whiskey Lake и Core i3-7100U поколения Kaby Lake. Intel представила процессоры Xeon D-1600: почта, телеграф, мосты
02.04.2019 [20:00],
Геннадий Детинич
В 2015 году компания Intel представила процессоры Xeon семейства D. Первой появилась серия Xeon D-1500. Процессоры Xeon D получили архитектуру уровня Intel Core (Broadwell), став на ступеньку выше Xeon на архитектуре Atom. Целевое назначение Xeon D при этом не изменилось ― они всё так же были ориентированы на создание микросерверов, встраиваемых решений, систем для хранения данных малого и среднего уровней и сетевого оборудования. В 2018 году компания выпустила серию Xeon D-2100 на архитектуре Skylake. Тем самым в семейство Xeon D добавились решения повышенной производительности. Сегодня Intel представила третью серию Xeon D ― процессоры D-1600, которые возвращают нас к истокам семейства, главной целью которого был захват рынка производительной периферии с акцентом на плотность и сниженное потребление. 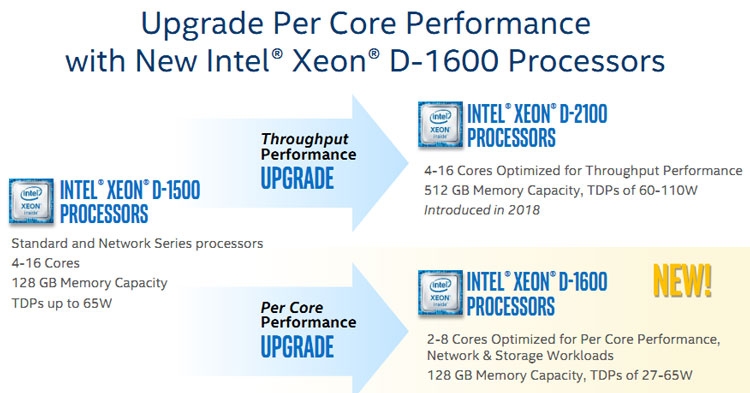 Процессоры Intel Xeon D-1600 получили меньшее число ядер, чем у их предшественников в лице Xeon D-1500. Диапазон числа физических ядер у моделей Xeon D-1600 сократился с 4–16 до 2–8. Максимальный тепловой пакет при этом остался тем же ― 65 Вт, тогда как минимальное значение TDP снизилось с 35 Вт до 27 Вт. Снижение числа ядер и сохранение максимального уровня TDP говорит о росте производительности в пересчёте на одно ядро. Во многом это достигается за счёт прироста как базовой частоты (в 1,2–1,5 раза), так и за счёт увеличения частоты при автоматическом разгоне до 3,2 ГГц, тогда как модели Xeon D-1500 в режиме турбо ограничивались частотой до 2,7 ГГц. Определённым образом Intel откатилась назад по шкале эволюции, понизив градус многоядерности в пользу наращивания однопоточной производительности. Собственно, этого требует позиционирование новой серии и активное развитие виртуализации сетевых функций (NFV). Для этого стала важнее скорость реакции сетевой платформы, что хорошо отрабатывается повышением тактовых частот. 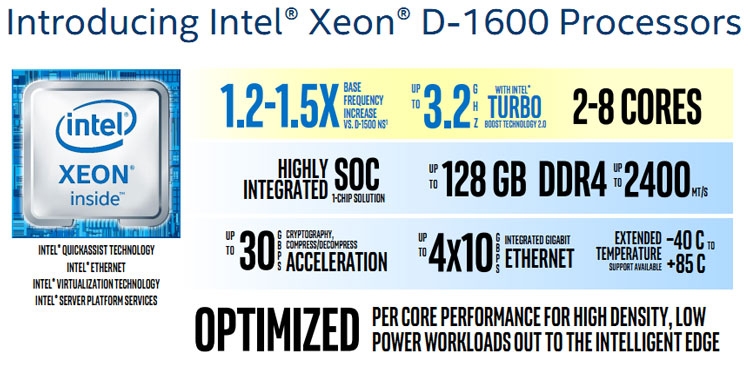 Архитектурных изменений в моделях Xeon D-1600 не очень много, если они вообще есть (пока предполагаем, что архитектура осталась прежней ― Broadwell). Интегрированный контроллер памяти остался двухканальным с поддержкой модулей DDR4 с частотой до 2400 МГц суммарным объёмом до 128 Гбайт. Также поддерживается память DDR3L-1600. Уточним, процессоры Xeon D ― это однокристальная платформа, фактически SoC, что чрезвычайно удобно для тех областей, на которые нацелены эти решения. 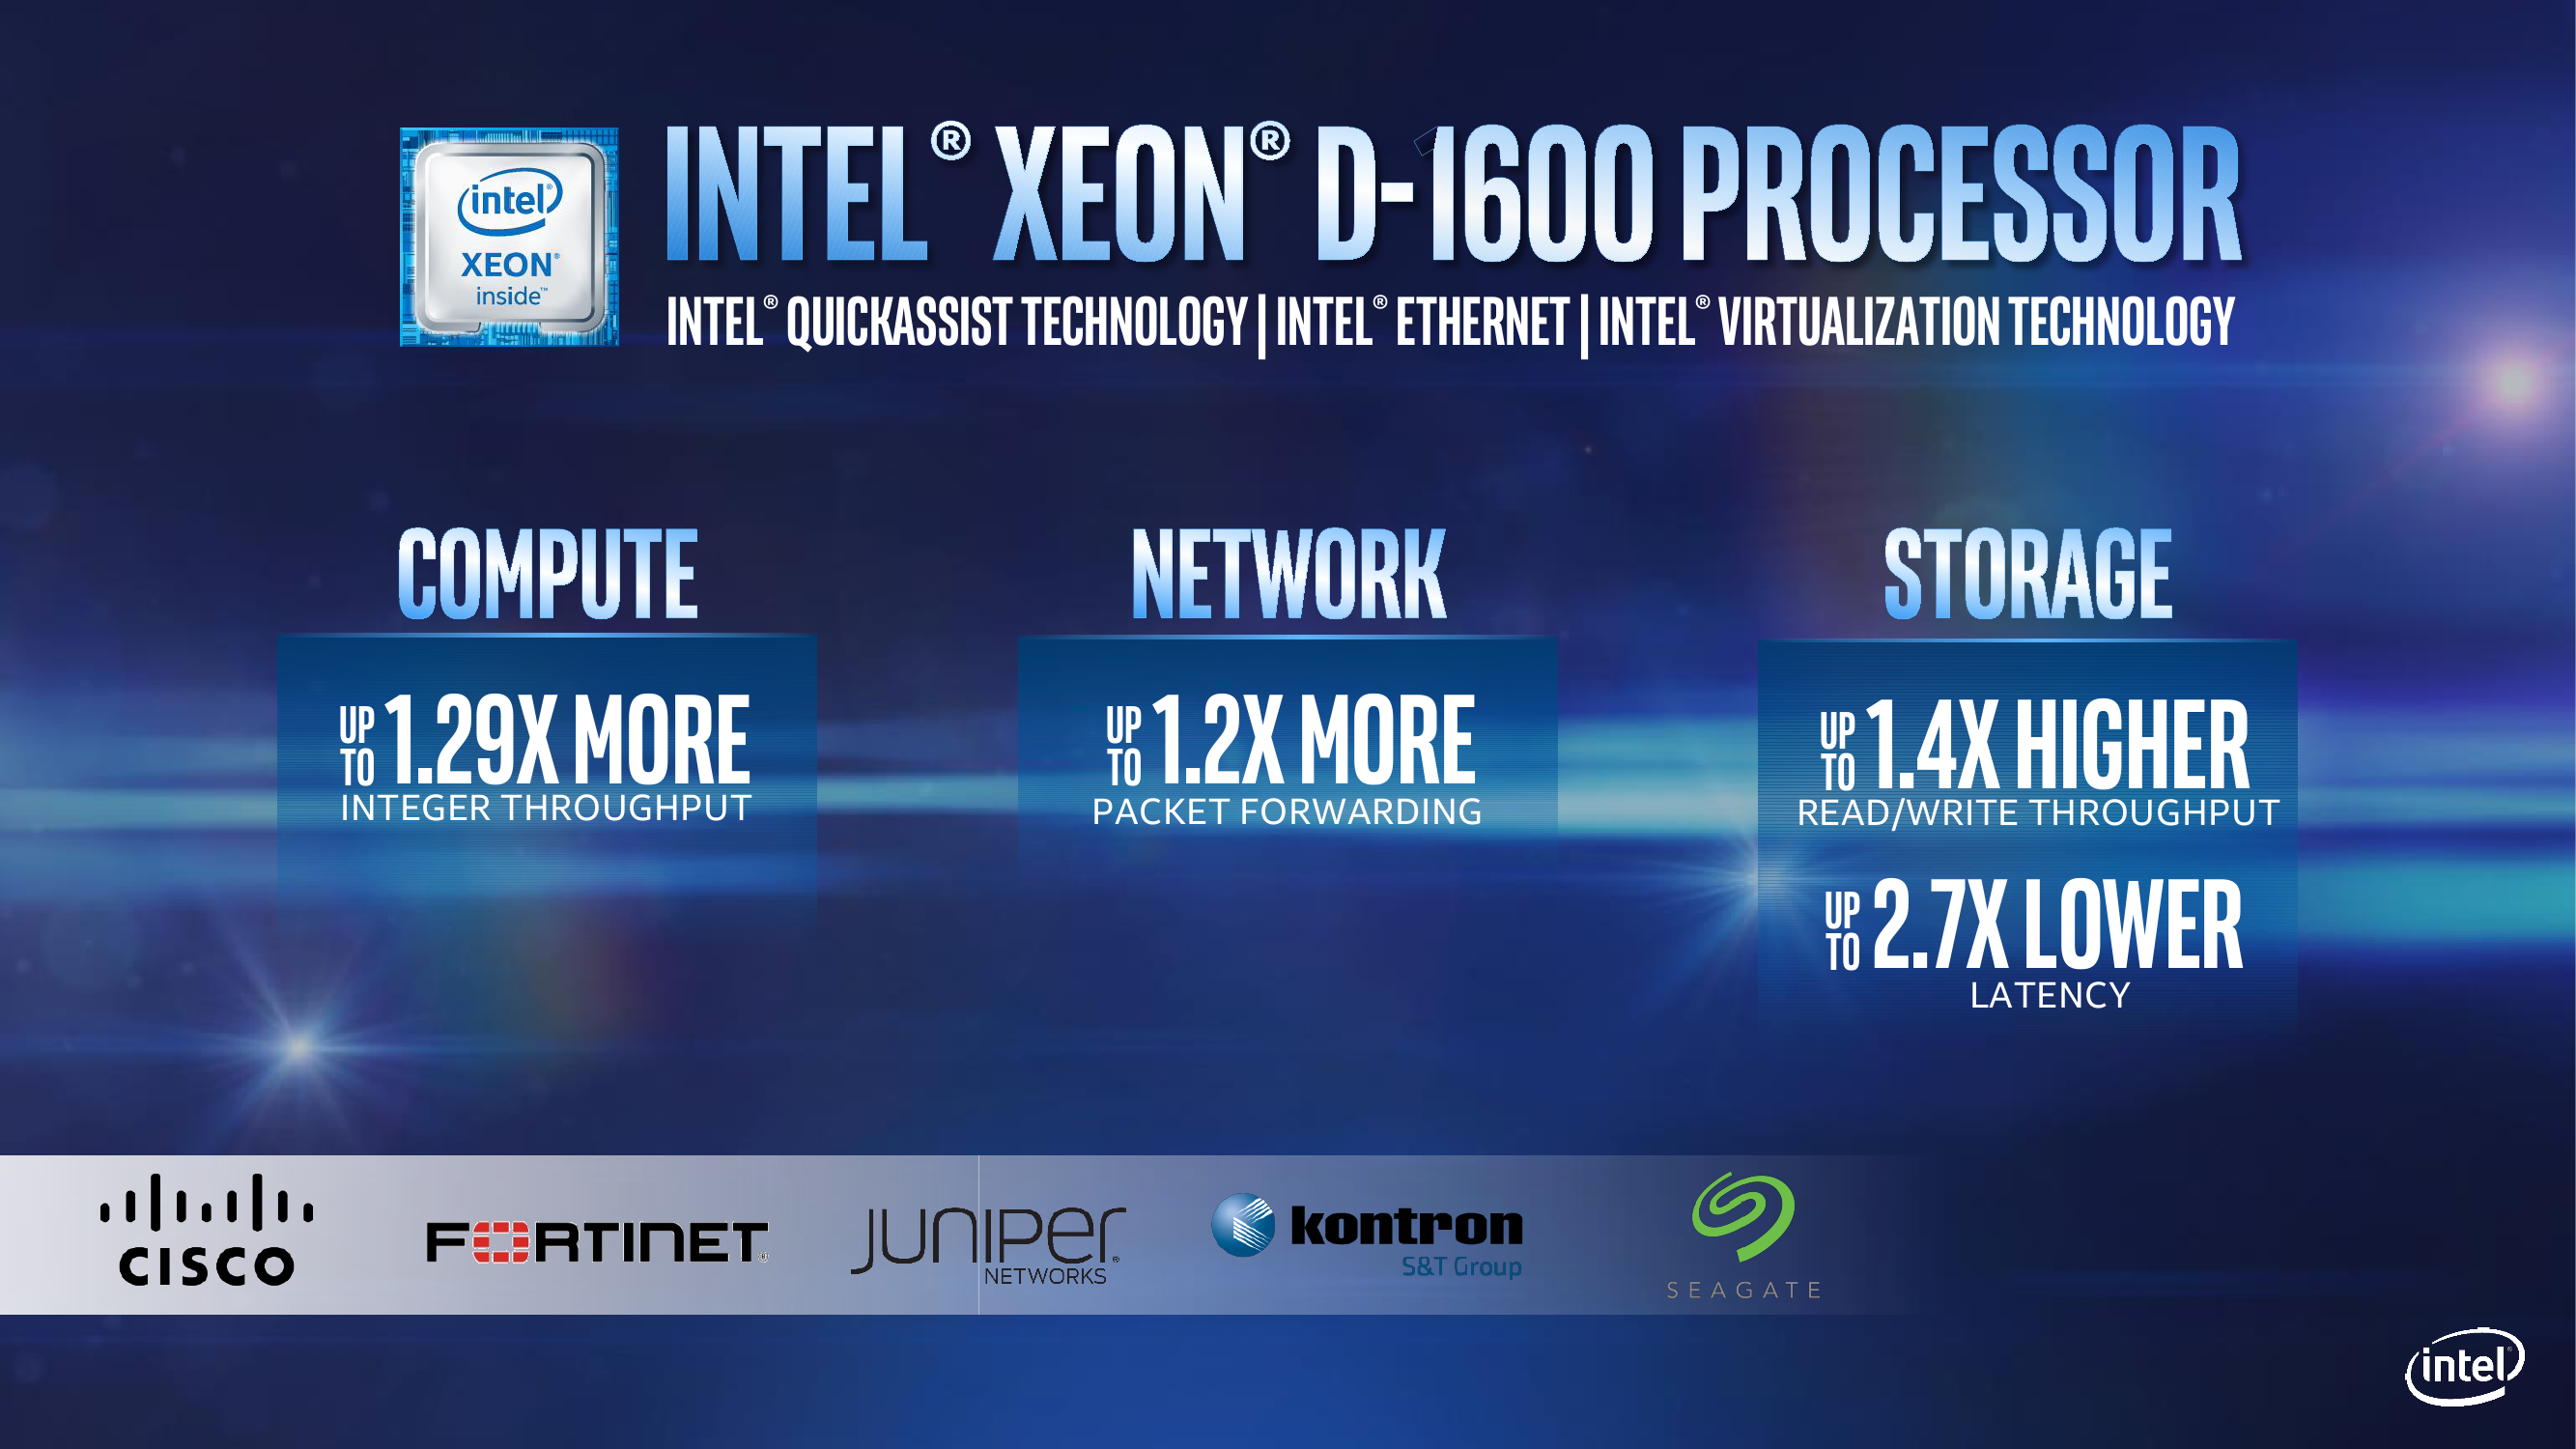 Встроенные в процессоры интерфейсы представлены 24 линиями PCIe 3.0, 8 линиями PCIe 2.0, 6 портами SATA 6 Гбит/с, 4 портами USB 3.0, 4 портами USB 2.0 и 4 портами Ethernet 10 Гбит/с. Кстати, об Ethernet. На кристалл Xeon D-1600 интегрирован контроллер Intel серии Ethernet 700. На это намекают не только четыре интерфейса Ethernet 10GbE, но также поддержка технологии Intel QuickAssist. 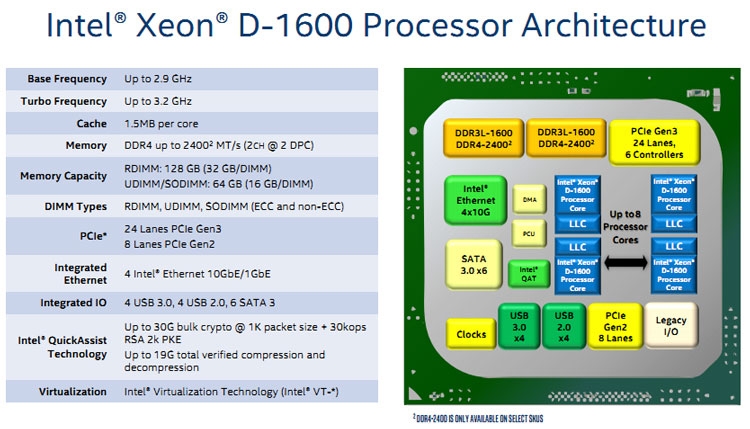 У старшей серии Xeon D-2100 модели Xeon D-1600 взяли то, чего не было у моделей Xeon D-1500 ― это поддержка технологии Intel QuickAssist (QAT). Технология QAT поддержана в моделях Xeon D-1600 с индексом «N». Наличие QAT означает, что процессор несёт встроенный аппаратный ускоритель для работы с криптографией, компрессией и обработки сетевого трафика. Поддерживается целый ряд популярных алгоритмов, что существенно разгружает вычислительные ядра и даёт ощутимый прирост производительности. Например, обработка трафика TLS/IPSec плюс компрессия происходит со скоростью 30 Гбит/с плюс 30 000 операций в секунду, как и расшифровка ключами RSA с такой же производительностью. 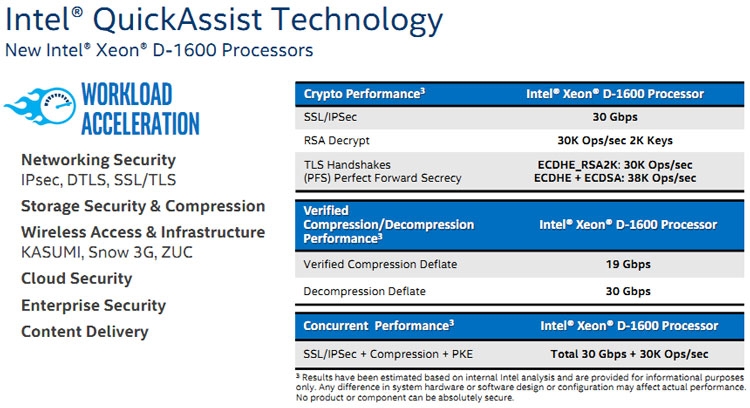 Поставки процессоров Xeon D-1600 компания Intel начнёт во втором квартале текущего года. Решения на основе новинок попадут на рынок к середине года или во второй его половине. По представлениям Intel, вычислительное и коммуникационное оборудование на базе Xeon D-1600 станет оптимальным выбором для развёртывания инфраструктуры для реализации и поддержки сотовой связи поколения 5G, а также для организации периферийных (пограничных) вычислений, когда обработка сырых данных (видео, сбор информации с датчиков, включая автомобильную электронику) происходит на месте и минимизирует пересылку в центры по обработке информации. Кроме того, они могут быть использованы в системах хранения данных. 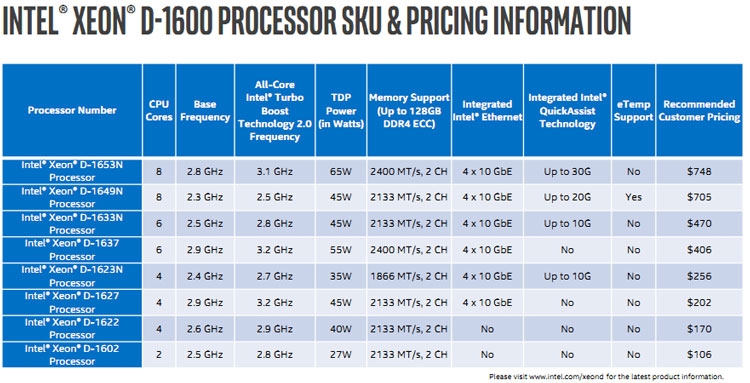 Процессоры Intel Xeon D 1600 представлены в рамках большого обновления решений для ЦОД, которое включает «взрослые» Intel Xeon Cascade Lake AP и SP с поддержкой памяти Optane в формате DDR4-модулей и новых инструкций для ИИ, модульные FPGA Agilex и сетевые контроллеры 100GbE Intel Ethernet 800. Подробности по ссылкам ниже.
Встраиваемые платформы AMD Ryzen V1000 и EPYC 3000 расширяют базу и проникают в робототехнику
28.02.2019 [14:53],
Геннадий Детинич
На мероприятии Embedded World 2019 новые встраиваемые платформы компании AMD в виде APU Ryzen Embedded V1000 и процессоров EPYC Embedded 3000 получили поддержку со стороны многих производителей встраиваемых решений, что выразилось в серии демонстраций модулей, материнских плат и полочных решений для серверных стоек. Процессоры Ryzen Embedded V1000 и EPYC Embedded 3000 на ядрах Zen компания анонсировала ровно год назад. Первые призваны стать основой компактных решений с мощной мультимедийной составляющей (игровые автоматы, рекламные стенды, медицинские и промышленные приборы), а вторые ― это решения для телекоммуникации, удалённых хранилищ данных и масштабируемых серверов. 
Источник изображений: AMD За прошедший год компания AMD обзавелась поддержкой со стороны свыше 50 компаний, которые заинтересовались «встраиваемыми Zen». Это даёт AMD надежду на рывок в данном сегменте, вплоть до двукратного увеличения доли до конца 2021 года. Глядя на то, как растёт спрос на потребительские и серверные процессоры AMD Ryzen и EPYC, в это вполне можно поверить. К тому же, в индустрии и обществе появляется интерес к производительным периферийным вычислениям, для чего встраиваемые решения идеально подходят, а также наметился устойчивый курс на системы с машинным обучением, ИИ и машинным зрением. Всё это создаёт благоприятную почву как для APU AMD, где у неё по совокупному сочетанию качеств нет равных соперников, так и для процессоров EPYC с беспрецедентным числом одновременно задействованных линий PCI Express.  Возвращаясь к выставке Embedded World 2019 отметим следующие разработки. Так, компания Advantech представила коммуникационный модуль SOM-5871 на AMD Ryzen Embedded V1000 для систем машинного зрения. Платформа поддержана ОС Mentor Linux. Модуль Advantech также подойдёт для создания мощных периферийных компьютеров и для вещей с подключением к Интернету. Другим новым применением для встраиваемых платформ AMD становится блокчейн и накопление данных, аналитика и обработка данных и сквозное обеспечение безопасности данных. На этих направлениях новую встраиваемую платформу AMD выбрали компании ClearBlade, BeechWoods и Enigmedia. В рамках этих работ AMD принимает участие в таком открытом сообществе, как EdgeX Foundry. Говоря о массивной обработке данных в реальном времени необходимо представить платформу PUZZLE компании IEI, образец которой был показан на выставке. Платформа позволяет в реальном режиме программно конфигурировать сети с развитыми функциями виртуализации. Компания Supermicro на AMD EPYC Embedded 3000 представила серверную платформу A+ (AS-E301-9D-8CN4 и AS-5019D-FTN4). Это решение для целого спектра сетевых применений, включая vCPE/uCPE, SD-WAN, обеспечение сетевой безопасности, приватных облачных платформ и периферийных компьютеров. Наконец, компания Congatec представила платформу Conga-B7E3A ― это «сервер на модуле». Мощное вычислительное решение в формате встраиваемой платформы. Анонс серверных платформ ARM Neoverse E1 и N1: шах и мат, Intel
23.02.2019 [20:20],
Геннадий Детинич
Уж извините за столь кричащий заголовок, но ARM давно мечтает сказать нечто подобное в отношении серверных платформ Intel. Пока получается не очень. Как говорят в самой ARM, не вышло с первого раза, попробуем во второй. Не получится во второй раз, на третий точно всё будет как надо. А сейчас и повод-то отличный! Разработчики оригинальных ядер ARM из одноимённой компании ударили сразу с двух направлений: по масштабируемым сетевым платформам (Neoverse E1) и по масштабируемым серверным (Neoverse N1). Очевидно, что пока «мата» в этой партии явно не будет. Intel крепко держится за серверные платформы и одновременно тянет руки к периферийным как в виде распределённых вычислительных ресурсов в составе базовых станций, так и в виде обычных периферийных ЦОД. Тем не менее, шансы объявить Intel «шах» у ARM определённо есть. 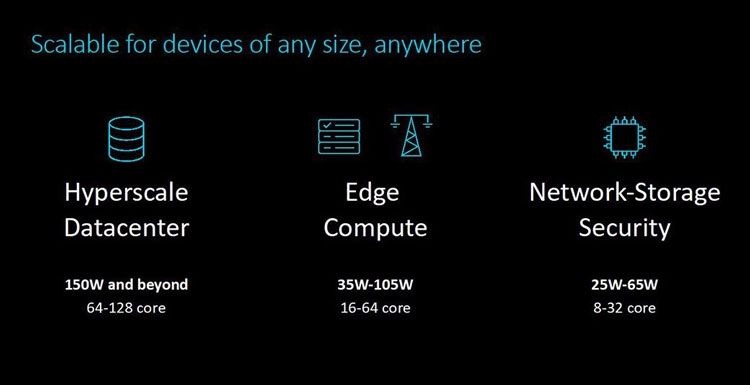 Рассчитанную на несколько лет вперёд стратегию Neoverse компания ARM представила в середине октября прошлого года. Она предполагает три крупных этапа, в ходе которых будут выходить доступные для широкого лицензирования 64-битные ядра ARM Ares (7 нм), Zeus (7 и 5 нм) и Poseidon (5 нм). Планируется, что каждый год производительность решений будет возрастать на 30 %. Сама компания ARM, напомним, не выпускает процессоры и SoC, а лишь продаёт лицензии на ядра и архитектуру, которые клиенты компании обустраивают нужными им контроллерами и интерфейсами. У ARM настолько многочисленная армия клиентов, что она ожидает буквально цунами из сотен и тысяч миллиардов ядер в год уже в недалёком будущем. Когда-нибудь в этот водоворот ядер будут вовлечены и серверные платформы, а затем количество перейдёт в качество. 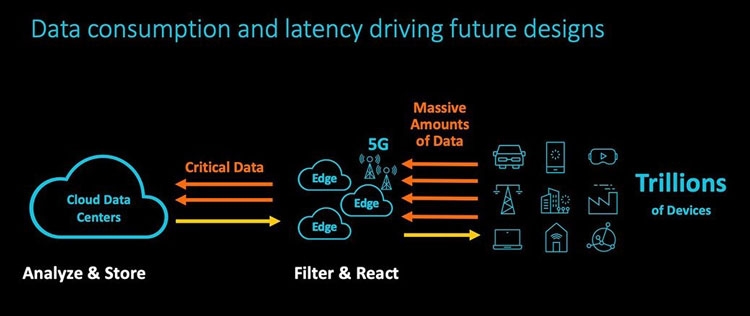 Разработка и анонс ядер Neoverse N1 ― это явление народу 7-нм ядер Ares. Процессоры могут нести от 4 до 128 ядер, объединённых согласованной ячеистой сетью. Платформа N1 может служить периферийным компьютером с 8-ядерным процессором с потреблением менее 20 Вт, а может стать сервером в ЦОД на 128-ядерных процессорах с потреблением до 200 Вт. Степень масштабируемости должна впечатлять. Кроме этого, как сообщают в ARM, производительность ядер N1 на облачных нагрузках в 2,5 раза выше, чем у 16-нм ядер предыдущего поколения Cosmos (Cortex-A72, A75 и A53). Кстати, прошлой осенью на платформе Cosmos компания Amazon представила фирменный процессор Graviton. 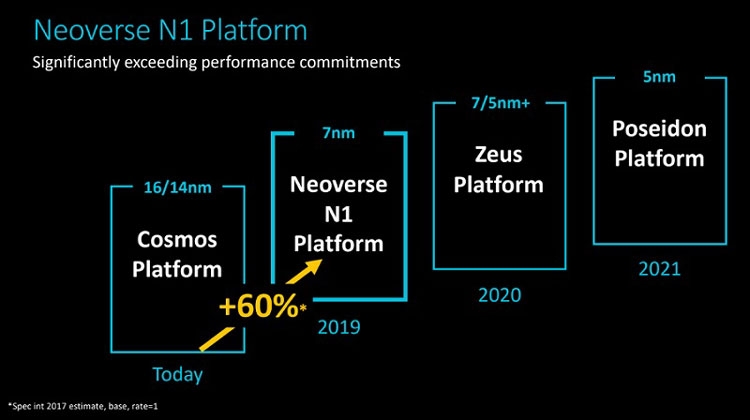 Производительность N1 при обработке целочисленных значений оказывается на 60 % больше, чем на ядрах Cortex-A72 Cosmos. При этом энергоэффективность ядер N1 также на 30 % выше, чем у ядер Cortex-A72. Как поясняют разработчики, платформа Neoverse N1 построена на «таких инфраструктурных расширениях, как виртуализация серверного класса, современная поддержка сервисов удалённого доступа, управление питанием и производительностью и профилями системного уровня». 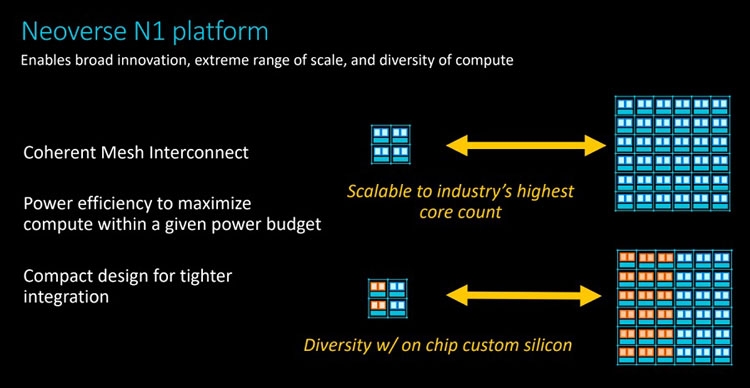 Когерентная ячеистая сеть (Coherent Mesh Network, CMN), о которой выше уже говорилось, разработана с учётом высокого соответствия вычислительным возможностям ядер. По словам ARM, сеть обменивается с ядрами такой служебной информацией, которая позволяет устанавливать объём загрузки в память данных для упреждающей выборки, распределяет кеш между ядрами и определяет, как он может быть использован, а также делает много других вещей, которые способствуют оптимизации вычислений. Интересно отметить, что в составе процессоров на платформе Neoverse N1 может быть существенно больше 128 ядер, но с оптимальной работой возникнут проблемы. Точнее, вычислительная производительность упрётся в пропускную способность памяти. Так, ARM рекомендует для CPU с числом ядер от 64 до 96 использовать 8-канальный контроллер DDR4, а для 96–128 ядерных версий ― контроллер памяти DDR5. Платформа Neoverse E1 ― это решение для сетевых шлюзов, коммутаторов и сетевых узлов, которое, например, облегчит переход от сетей 4G к сетям 5G с их возросшей требовательностью к каналам передачи данных. Так, Neoverse E1 обещает рост пропускной способности в 2,7 раза, увеличение эффективности при передаче данных в 2,4 раза, а также более чем 2-кратный рост вычислительной мощности по сравнению с предыдущими платформами (ядрами). С масштабируемостью ядер E1 тоже всё в порядке, они позволят создать решение как для базовых станций начального уровня с потреблением менее 35 Вт, так и маршрутизатор с пропускной способностью в сотни гигабайт в секунду. Что же, ARM расставила на доске новые фигуры. Будет интересно узнать, кто же начнёт игру? Intel ставит крест на процессорах Itanium
31.01.2019 [20:33],
Сергей Карасёв
Корпорация Intel опубликовала документ, по сути, знаменующий закат эпохи процессоров Itanium, на которые некогда возлагались большие надежды.  В обнародованном уведомлении речь идёт о грядущем прекращении производства чипов Itanium 9700, известных под кодовым именем Kittson. Массовые поставки этих изделий были начаты в 2017 году. Семейство включает четыре модели — Itanium 9720, Itanium 9740, Itanium 9750 и Itanium 9760 с четырьмя и восемью вычислительными ядрами. В документе Intel говорится, что приём заказов на все перечисленные процессоры прекратится через год — 30 января 2020-го. Поставки будут полностью свёрнуты 29 июля 2021 года. 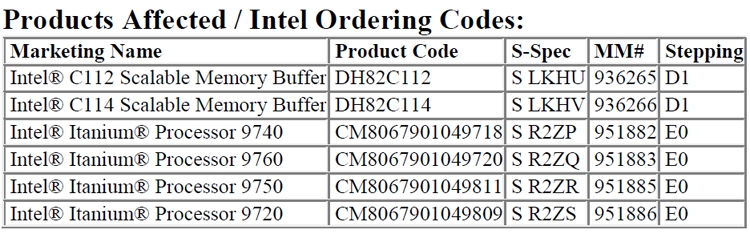 Таким образом, Intel ставит крест на решениях Itanium. Ещё в момент выхода Kittson говорилось, что эти изделия станут последними в семействе Itanium. Добавим, что впервые чипы Itanium дебютировали в мае 2001 года. Но продажи чипов оказались менее успешными, чем предполагалось. Основными причинами этому были проблемы с производительностью и малое количество оптимизированного программного обеспечения. Раскрыты спецификации ARM-процессоров Fujitsu A64FX для суперкомпьютера Post-K
22.08.2018 [13:00],
Геннадий Детинич
Примерно через три года начнётся коммерческая эксплуатация суперкомпьютера Post-K, который компании Fujitsu и RIKEN разрабатывают на смену предыдущей совместной системы суперкомпьютера K (начал работать в 2011 году). Новая система Post-K обещает 100-кратно поднять производительность на уровне приложений. И сделано это будет благодаря переходу Fujitsu на ARM-совместимые ядра и новую архитектуру с масштабируемыми векторными инструкциями (Scalable Vector Extensions). 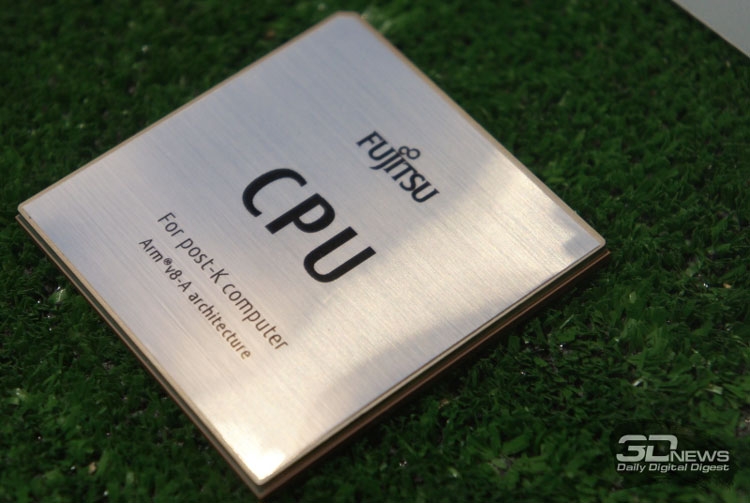 На прошедшей на днях конференции Hot Chips 30 (2018) компания Fujitsu впервые обнародовала спецификации новых процессоров, которые получили обозначение A64FX. Ни «A», ни «64», ни «FX» не имеют отношение к компании AMD, хотя в названии новых суперпроцессоров Fujitsu что-то немного согревает душу. Это процессоры с поддержкой 64-разрядных команд ARM и векторных инструкций длиной до 512 бит. Каждый процессор Fujitsu A64FX будет нести 48 вычислительных ядер и 4 вспомогательных ядра, разделённые на четыре блока, соединённых внутренней кольцевой шиной. Для связи с другими процессорами Fujitsu использует две линии внешнего интерфейса Tofu с пропускной способностью 28 Гбит/с. Строение процессора и внешний скоростной интерфейс обещают значительное наращивание параллелизма в вычислениях. 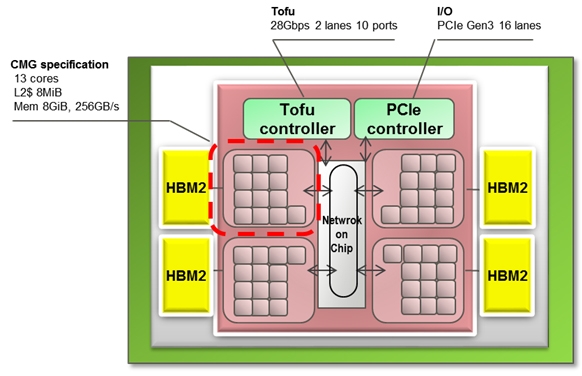
Fujitsu Каждый из 13-ядерных блоков поддержан кеш-памятью L2 объёмом 8 Мбайт. Кроме этого каждый из блоков напрямую обращается к модулю стековой памяти HBM2 объёмом 8 Гбайт. Суммарный объём памяти HBM2 у каждого процессора насчитывает 32 Гбайт, а общая скорость доступа достигает 1024 Гбайт/с. Поскольку память HBM2 можно рассматривать в качестве кеш-памяти третьего уровня, все или большинство операций выполняются в процессоре, что обещает отличный прирост производительности. 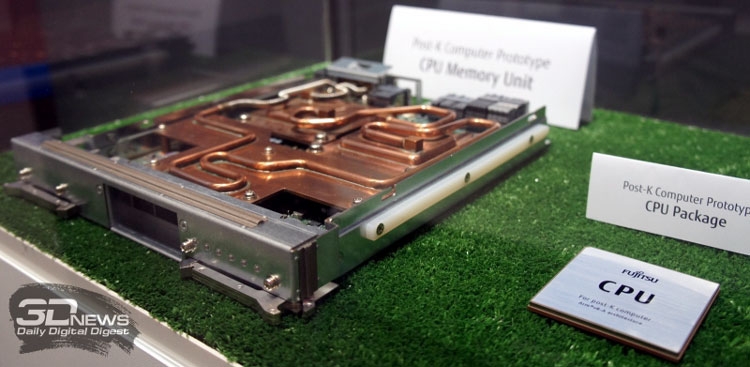 Процессор Fujitsu A64FX выпускается с использованием 7-нм техпроцесса, очевидно, что на линиях компании TSMC. Он насчитывает 8,7 млрд транзисторов. Пиковая производительность процессора для операций с двойной точностью достигает 2,7 терафлопс. Процессор без потерь на переход может вычислять операции с одинарной точностью и половинной, соответственно, в два и четыре раза быстрее. Также, за что надо благодарить тему машинного обучения, процессор A64FX оптимизирован для обработки 16- и 8-битных целочисленных значений. 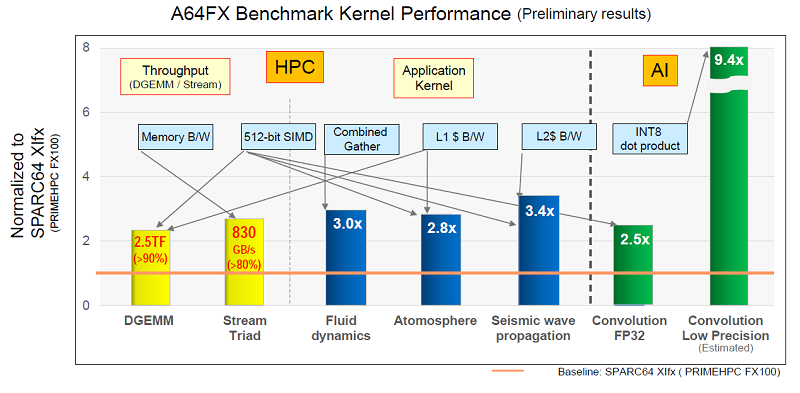 Американские ВВС получили самый большой в мире нейроморфный суперкомпьютер
29.07.2018 [13:00],
Геннадий Детинич
Звучит громко, но это именно так. Лаборатория Air Force Research Laboratory (AFRL) в городе Ром, штат Нью-Йорк, получила в своё распоряжение самый большой в мире компьютер по числу задействованных в системе нейроморфных процессоров IBM TrueNorth. Система представлена полочными компьютерами высотой 4U (7 дюймов) для стандартной серверной стойки. Каждый компьютер располагает 64 процессорами IBM TrueNorth. В пересчёте на человеческие в буквальном смысле единицы измерения мозга — это 64 млн нейронов и 16 млрд синапсов. Всего в стойке может разместиться 512 млн цифровых нейронов. Примерно столько нейронов в коре головного мозга собаки. 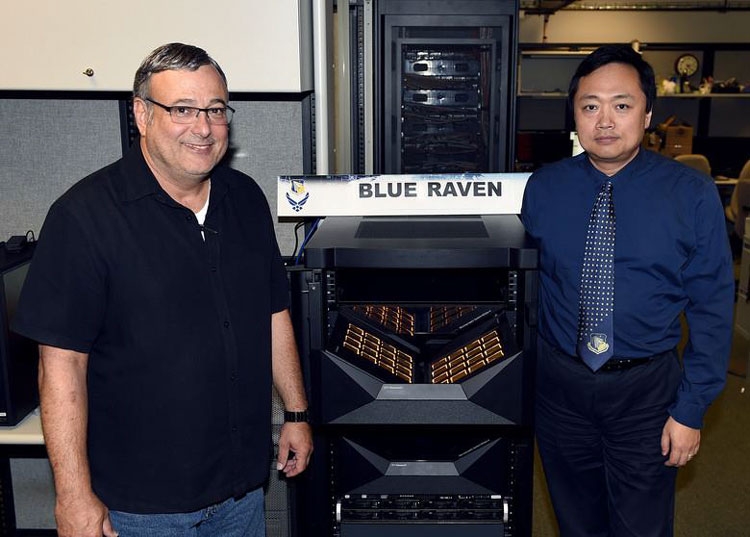
AFRL Система под именем «Blue Raven» на базе IBM TrueNorth для Лаборатории ВВС США представлена пока 64-процессорным решением с общим потреблением 40 Вт. Это, кстати, в 4 раза больше ожидаемого. Аналогичный 16-процессорный компьютер, переданный в 2016 году Ливерморской национальной лаборатории им. Лоуренса, потреблял всего 2,5 Вт или 156 мВт на один процессор. Возможно таким образом была повышена производительность системы, которая при потреблении 70 мВт способна работать с производительностью 46 млрд синаптических операций в секунду. 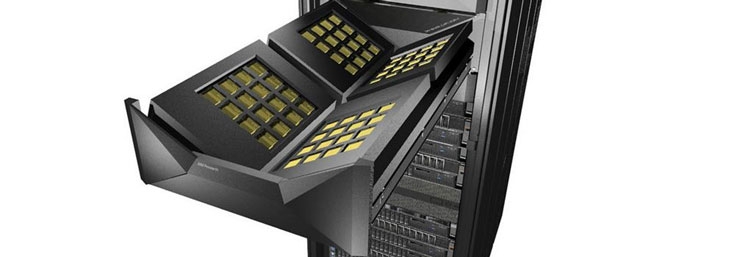
IBM По оценкам IBM, работа процессоров TrueNorth с необозначенным датасетом на CIFAR-100 по распознаванию наборов изображений характеризуется производительностью свыше 1500 кадров в секунду с потреблением 200 мВт или свыше 7000 кадров в секунду на ватт. Ускоритель NVIDIA Tesla P4 (Pascal GP104), например, обрабатывает датасет Resnet-50 с производительностью 27 кадров в секунду на ватт. 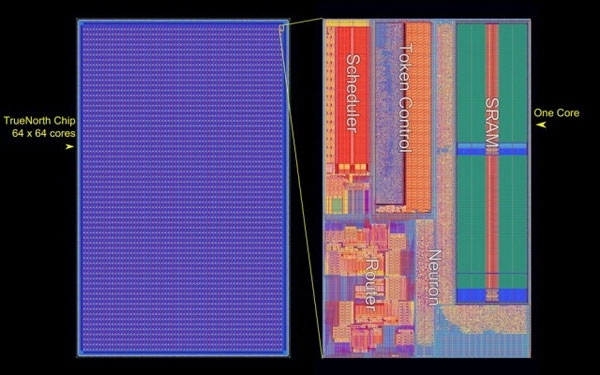
Структура процессора IBM TrueNorth Вообще, в Лаборатории AFRL, похоже, работают увлечённые люди. Новым проектом «Blue Raven» руководит тот же человек (Mark Barnell), который несколько лет назад отметился запуском суперкомпьютера Condor Cluster на базе сотен игровых консолей Sony PlayStation 3. Какими расчётами в AFRL будет заниматься суперкомпьютер с «мозгами» не уточняется. Пока учёные будут изучать круг задач, решаемый подобными системами. Ожидается, что принятая на «вооружение» научным отделом ВВС США вычислительная система обеспечит дальнейшее приоритетное развитие технологий в этой стране. Китайский серверный процессор Hygon Dhyana построен на архитектуре AMD Zen
07.07.2018 [13:35],
Андрей Созинов
Китайская компания Hygon начала производство x86-совместимых серверных процессоров Dhyana, построенных на микроархитектуре AMD Zen. Эти процессоры стали плодом совместной работы китайского производителя с компанией AMD, а именно лицензирования технологий последней, связанных с архитектурой x86. Компания AMD утверждает, что она не продаёт свои окончательные проекты чипов китайским партнёрам, а лишь позволяет создавать им свои собственные процессоры на основе её разработок, которые будут адаптированы именно к китайскому рынку. Но это лишь слова, и в реальности процессоры Hygon Dhyana настолько похожи на процессоры AMD EPYC, что разработчики Linux в обновление ядра для обеспечения их поддержки добавили лишь идентификаторы поставщика и номера семейств. А коды поддержки для новых китайских процессоров были полностью заимствованы у EPYC. То есть между процессорами практически нет разницы. 
Источник изображений: AMD Новые китайские серверные процессоры появились как раз во время обостряющейся торговой войны между Китаем и США, так что собственное производство процессоров является стратегически важным для КНР. Также начать производство собственных процессоров Китай подстегнуло то, что в 2015 году администрация Обамы запретила Intel продавать Поднебесной процессоры Xeon из-за того, что они помогают в развитии её ядерной программы.  То, что AMD смогла создать франшизу, которая позволяет китайским производителям процессоров создавать и продавать x86-совместимые процессоры, на этом фоне выглядит ещё более удивительно. Как это удалось американской компании? Если вкратце, то AMD создала в Китае совместное предприятие с местными частными и государственными компаниями. В итоге получилось достаточно сложная структура, но она позволяет лицензировать AMD технологии, связанные с архитектурой x86, не нарушая какие-либо законы или соглашения, с той же Intel. Опубликованы финальные спецификации CCIX 1.0: разделяемый кеш и PCIe 4.0
29.06.2018 [13:00],
Геннадий Детинич
Чуть больше двух лет назад в мае 2016 года семёрка ведущих компаний компьютерного сектора объявила о создании консорциума Cache Coherent Interconnect for Accelerators (CCIX, произносится как «see six»). В число организаторов консорциума вошли AMD, ARM, Huawei, IBM, Mellanox, Qualcomm и Xilinx, хотя платформа CCIX объявлена и развивается в рамках открытых решений Open Compute Project и вход свободен для всех. В основе платформы CCIX лежит дальнейшее развитие идеи согласованных (когерентных) вычислений вне зависимости от аппаратной реализации процессоров и ускорителей, будь то архитектура x86, ARM, IBM Power или нечто уникальное. Скрестить ежа и ужа — вот едва ли не буквальный смысл CCIX. 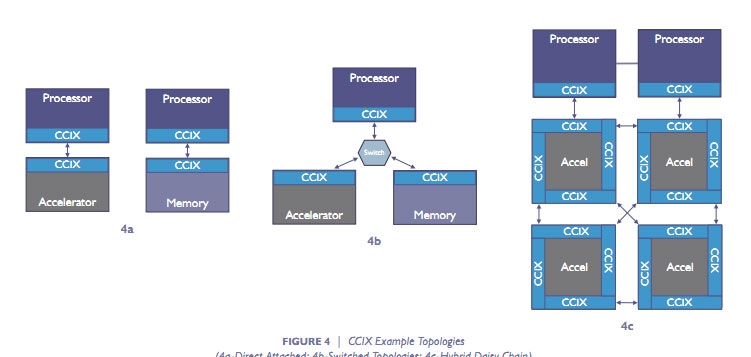
Варианты топологии CCIX На днях консорциум сообщил, что подготовлены и представлены финальные спецификации CCIX первой версии. Это означает, что вскоре с поддержкой данной платформы на рынок может выйти первая совместимая продукция. По словам разработчиков, CCIX позволит организовать новый класс подсистем обмена данными с согласованием кеша с низкими задержками для следующих поколений облачных систем, искусственного интеллекта, больших данных, баз данных и других применений в инфраструктуре ЦОД. Следующая ступенька в производительности невозможна без эффективных гетерогенных (разнородных) вычислений, которые смешают в одном котле исполнение кода общего назначения и спецкода для ускорителей на базе GPU, FPGA, «умных» сетевых карт и энергонезависимой памяти. 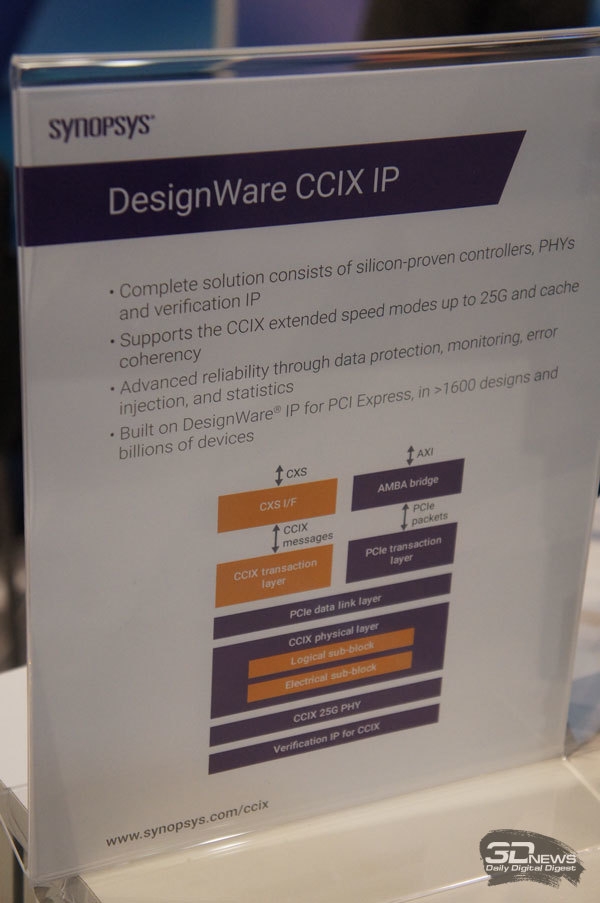
Решение CCIX IP компании Synopsys Базовые спецификации CCIX Base Specification 1.0 описывают межчиповый и «бесшовный» обмен данными между вычислительными ресурсами (процессорными ядрами), ускорителями и памятью во всём её многообразии. Все эти подсистемы объединены разделяемой виртуальной памятью с согласованием кеша. В основе спецификаций CCIX 1.0, добавим, лежит архитектура PCI Express 4.0 и собственные наработки в области быстрой коррекции ошибок, что позволит по каждой линии обмениваться данными со скоростью до 25 Гбайт/с. 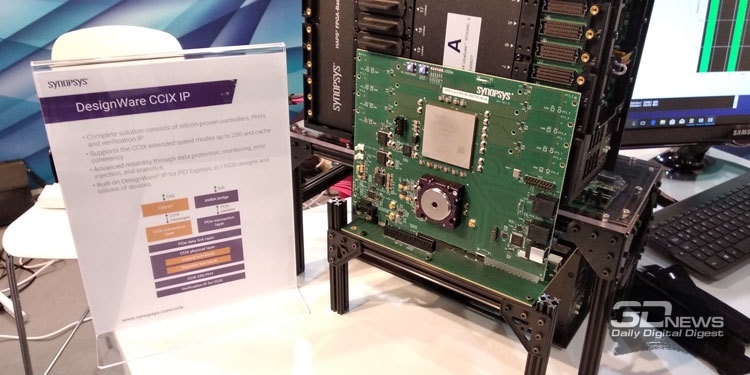
Тестовая платформа с поддержкой CCIX Synopsys на FPGA матрице Но главное, конечно, не скорость обмена, хотя это важная составляющая CCIX. Главное — в создании программируемых и полностью автономных процессов по обмену данными в кешах процессоров и ускорителей, что реализуется с помощью новой парадигмы разделяемой виртуальной памяти для когерентного кеша. Это радикально упростит создание программ для платформ CCIX и обеспечит значительный прирост в ускорении работы гетерогенных платформ. Вместо механизма прямого доступа к памяти (DMA), со всеми его тонкостями для обмена данными, на платформе CCIX достаточно будет одного указателя. Причём обмен данными в кешах будет происходить без использования драйвера на уровне базового протокола CCIX. Ждём в готовой продукции. Кто первый, AMD, ARM или IBM? 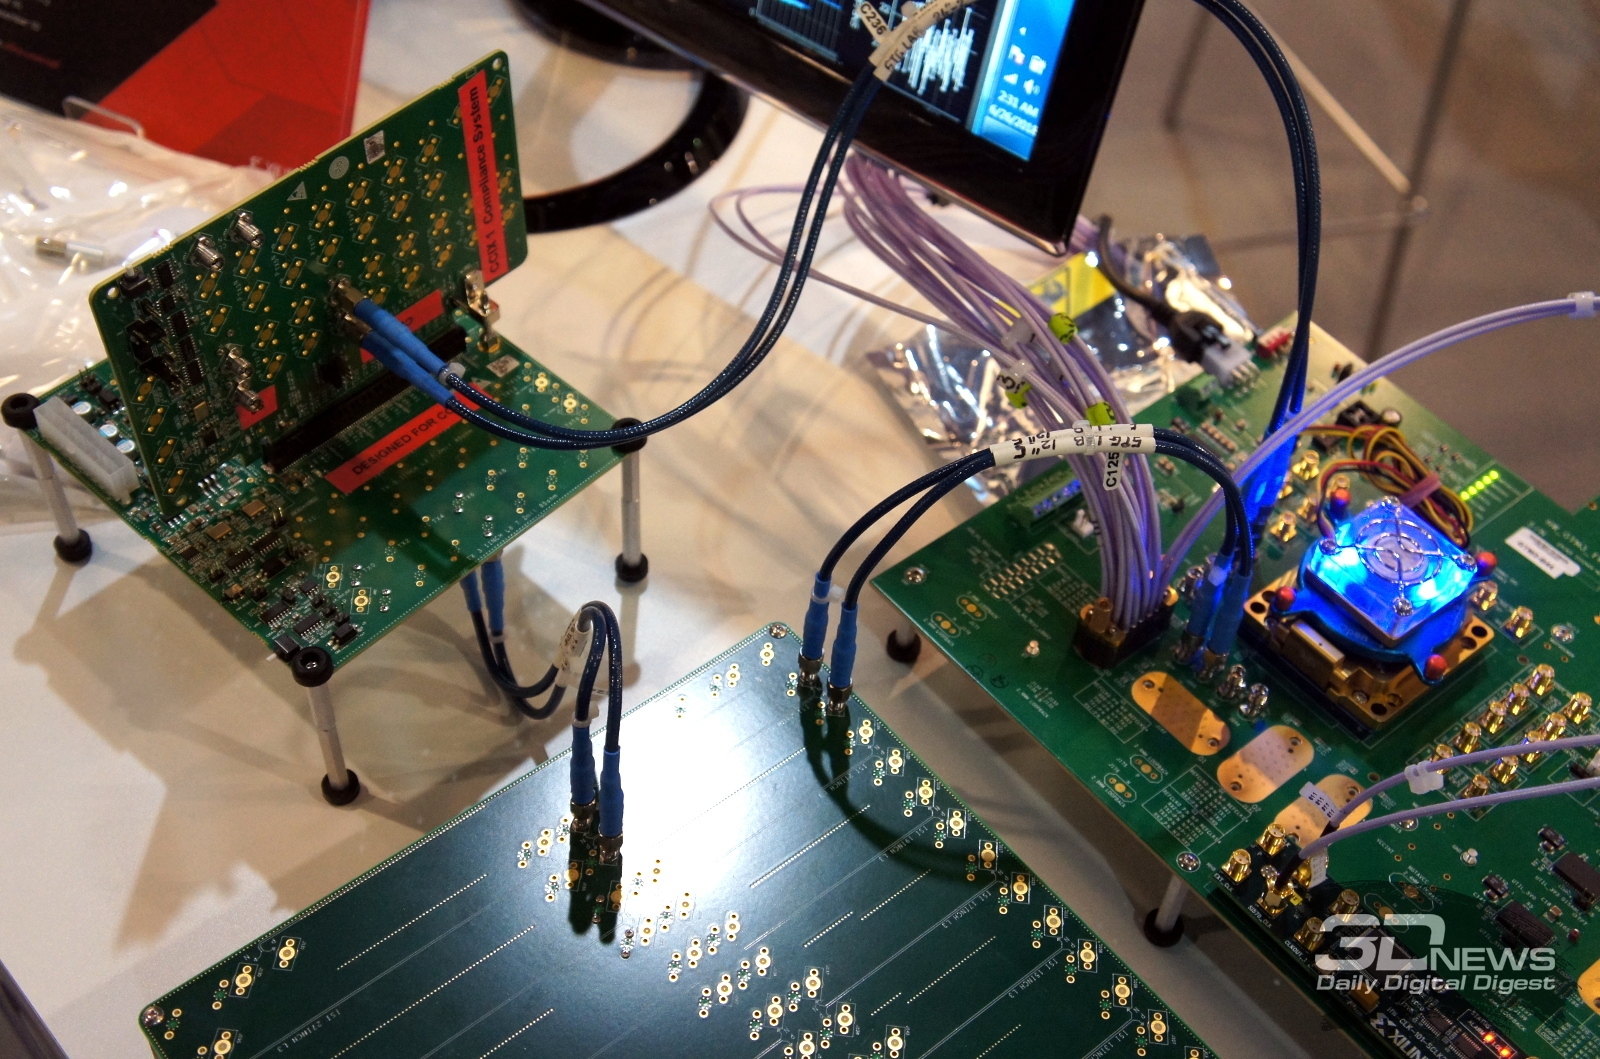
Тестовый набор CCIX 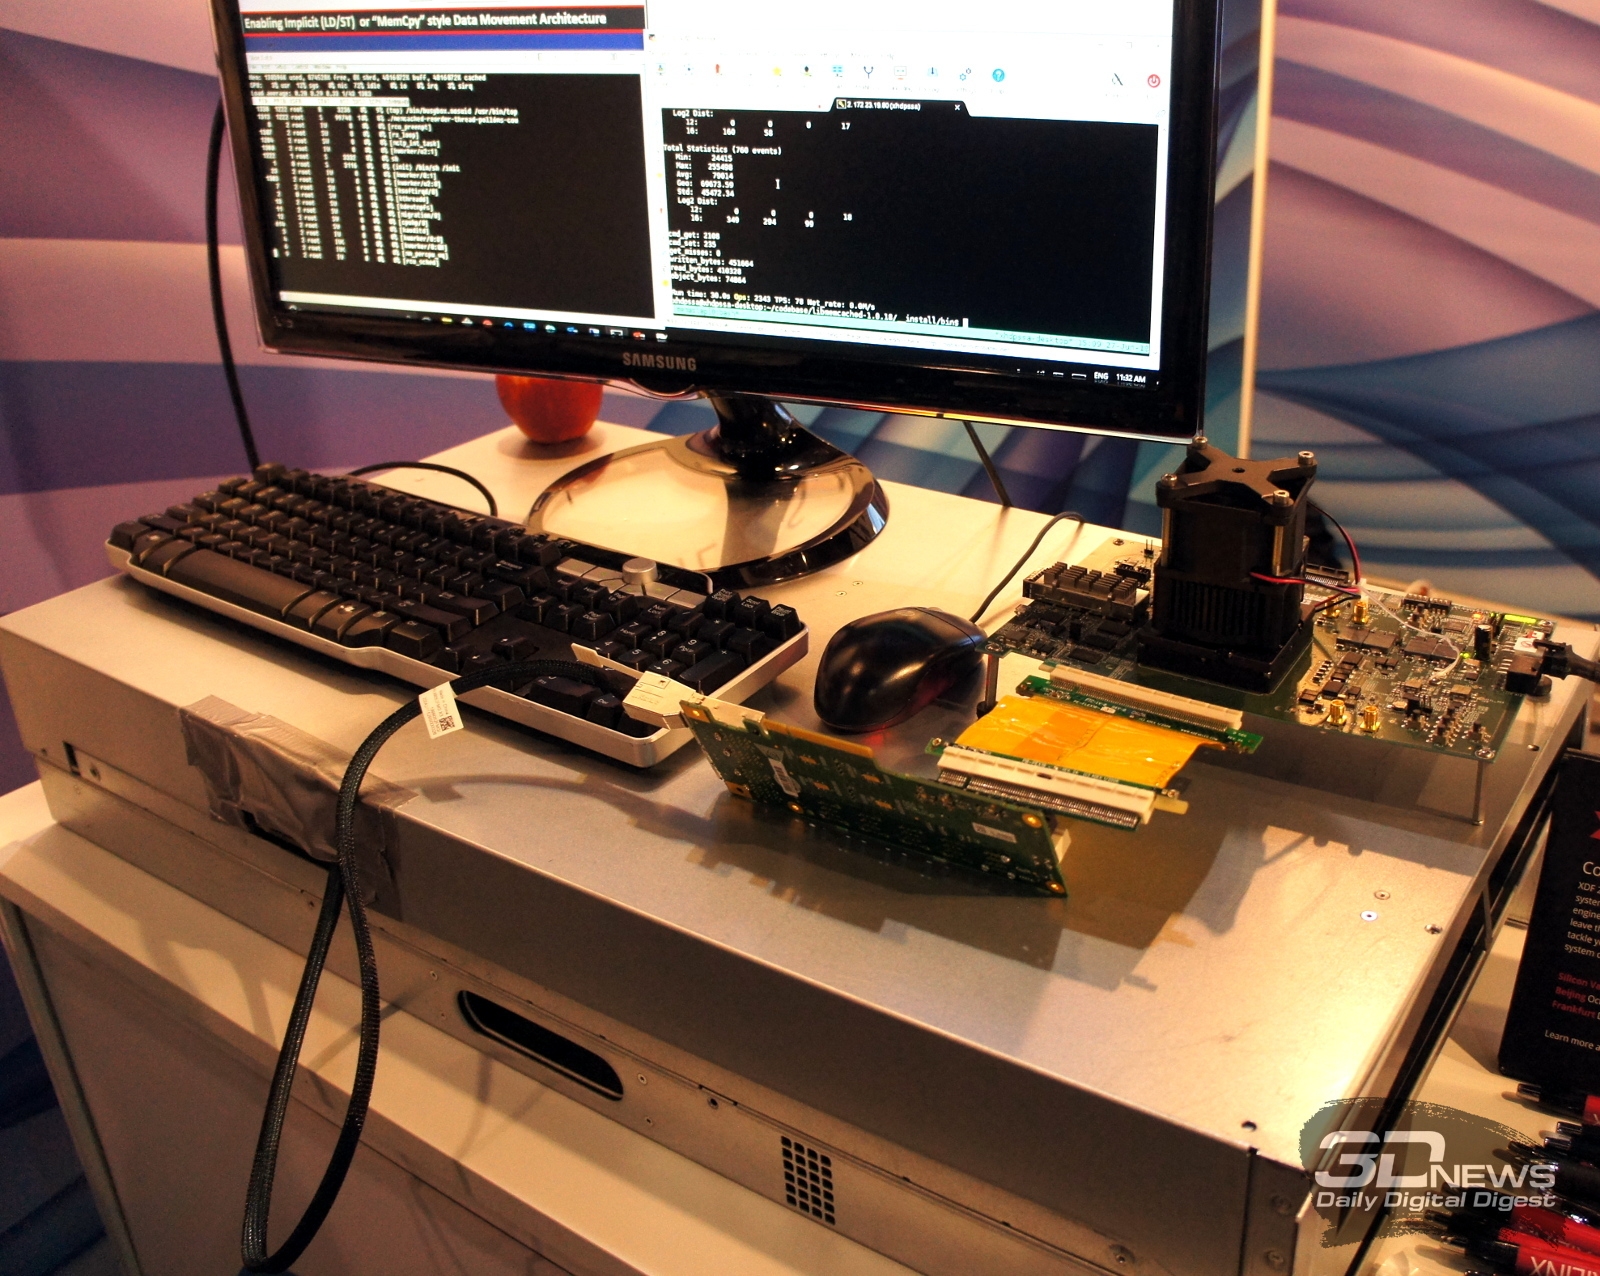
Рабочая демо-система с неназванным CPU и FPGA, соединённых шиной CCIX IBM представила первый сервер на процессоре POWER9
06.12.2017 [23:45],
Сергей Юртайкин
IBM представила свой первый собственный сервер на процессоре POWER9. Особенность решения под названием IBM Power Systems AC922 заключается в том, что новая аппаратная платформа разработана специально для работы с интенсивными вычислительными нагрузками технологий искусственного интеллекта (ИИ). 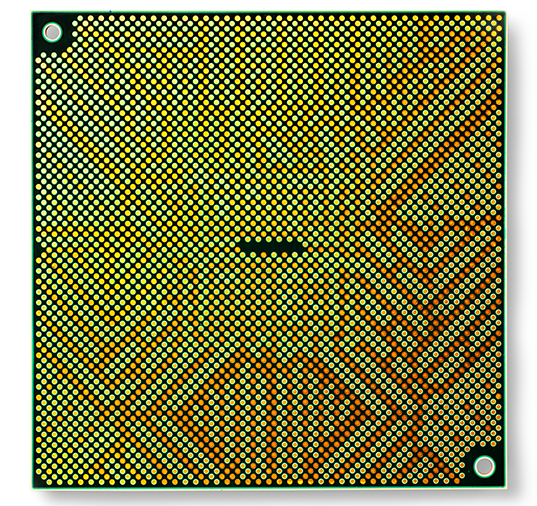
CPU IBM POWER9 В IBM отмечают, что Power 9 позволяет ускорить тренировки фреймворков глубинного обучения обучения почти в четыре раза, благодаря чему клиенты смогут быстрее создавать более точные ИИ-приложения. Утверждается, что новый сервер разработан для получения значительных улучшений производительности всех популярных фреймворков ИИ, таких как Chainer, TensorFlow и Caffe, а также современных баз данных, использующих ускорители, например, Kinetica. 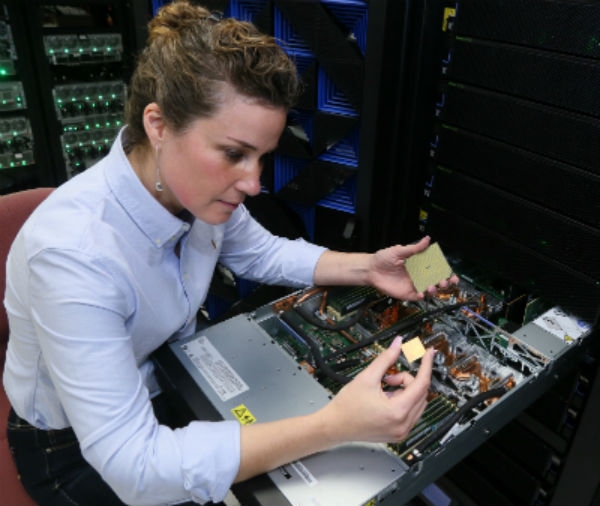
Сервер IBM Power System AC922 Сервер IBM Power Systems AC922 использует шину PCI-Express 4.0 и технологии NVIDIA NVLink 2.0 и CAPI 2.0/OpenCAPI, способные ускорить пропускную способность в 9,5 раза по сравнению с системами x86 на базе PCI-E 3.0. Это, в частности, позволяет задействовать ускорителям (GPU или FPGA) системную ОЗУ без значительных, по сравнению с прошлыми решениями, потерь производительности, что важно для обработки больших массивов данных. Кроме того, новые поколения карт расширения и ускорителей уже поддерживают эту шину. 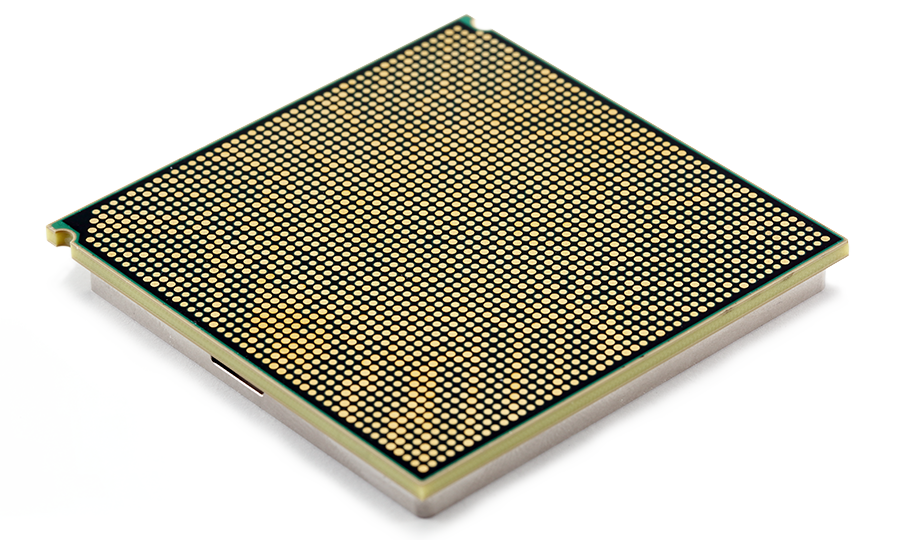 IBM Power Systems AC922 создан в нескольких конфигурациях, оснащаемых двумя процессорами POWER9. Стандартные версии включают CPU c 16 (2,6 ГГц, турбо 3,09 ГГц) и 20 (2,0/2,87 ГГц) ядрами (4 потока на ядро), а позже появятся версии с 18- и 22 -ядерными процессорами. Всего в сервере есть 16 слотов для модулей ECC DDR4-памяти, что на текущий момент позволяет оснастить его 1 Тбайт RAM. Для хранения данных предусмотрено два слота для 2,5" SSD/HDD (RAID-контроллера нет). 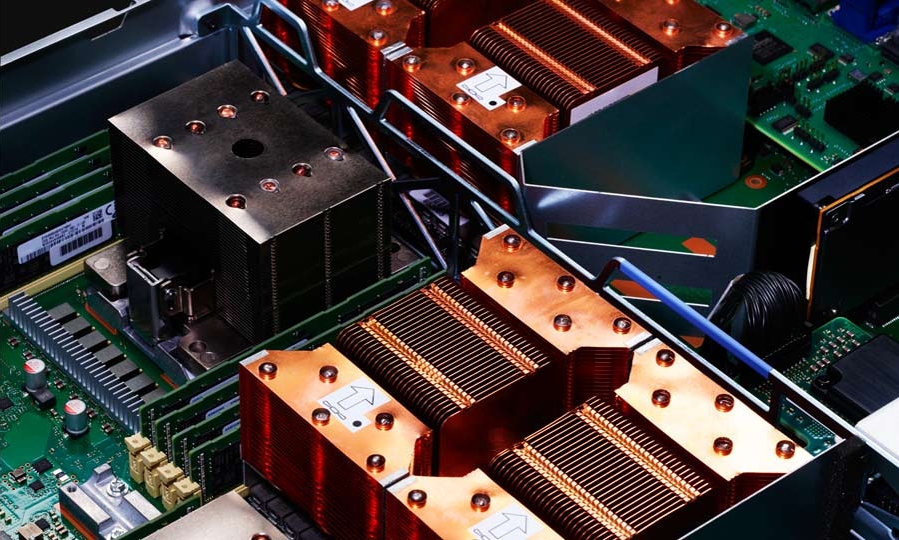 AC922 может иметь на борту от двух до четырёх ускорителей NVIDIA Tesla V100 форм-фактора SXM2 с памятью 16 Гбайт и шиной NVLink 2.0. В сумме они дают до 500 Тфлопс на расчётах половинной точности. Дополнительные ускорители можно подключить к слотам PCI-E 4.0. 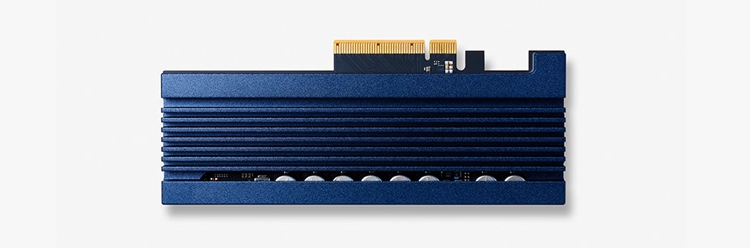 Сервер рассчитан на установку четырёх дополнительных низкопрофильных карт расширения: два слота PCI-E 4.0 x16, один PCI-E 4.0 x8 и один PCI-E 4.0 x4. Все слоты, кроме последнего, также умеют работать с CAPI. Также есть два порта USB 3.0. Поддерживается ОС Red Hat Enterprise Linux 7.4 for Power LE. 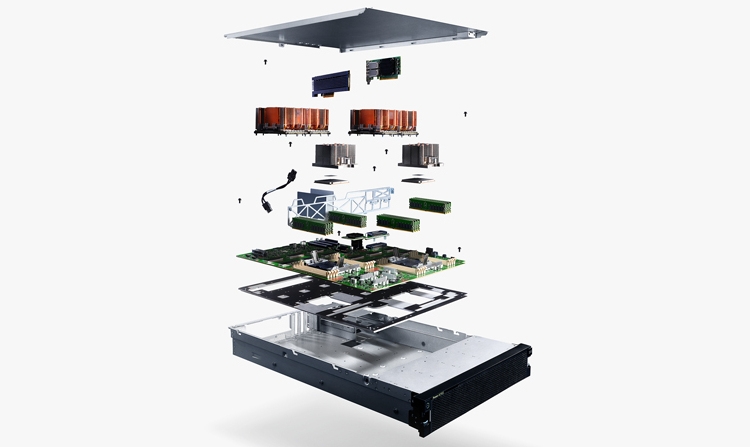 Процессоры IBM Power 9, которые нашли применение в IBM Power Systems AC922, легли в основу суперкомпьютеров Summit и Sierra Министерства энергетики США, а также используются компанией Google. Чипы и использующие их системы стали частью совместной работы участников организации OpenPower Foundation, в которую входят IBM, Google, Mellanox, NVIDIA и др. 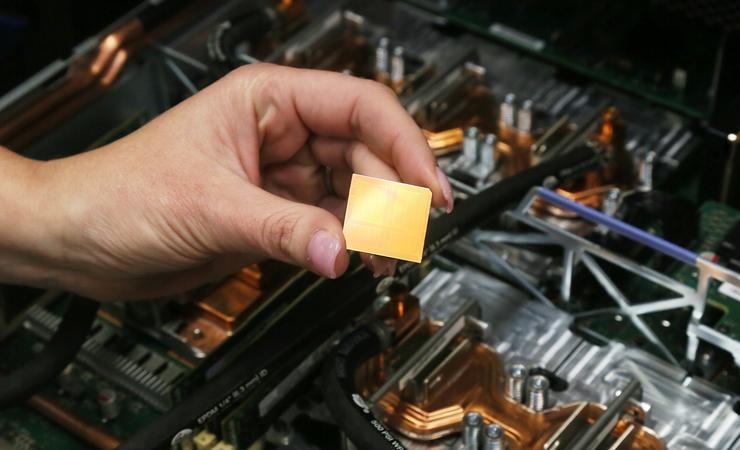
Процессор IBM Power 9 «Мы создали уникальную в своём роде систему для работы с технологиями ИИ и когнитивными вычислениями, — говорит старший вице-президент подразделения IBM Cognitive Systems Боб Пиччиано (Bob Picciano). — Серверы на Power 9 являются не только основой самых высокопроизводительных компьютеров, они позволят заказчикам масштабировать невиданные ранее инсайты, что будет способствовать научным прорывам и революционным улучшениям бизнес-показателей». 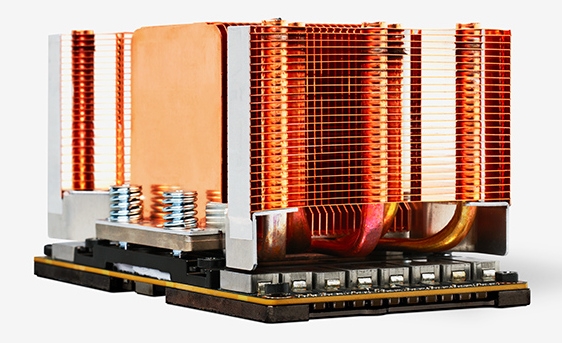 Сервер имеет стандартное 2U-шасси и оснащается двумя (1+1) блоками питания мощностью 2,2 кВт каждый. Система охлаждения может быть гибридной. Начало продаж IBM Power Systems AC922 намечено на 22 декабря 2017 года. В 2018 году будут доступны конфигурации с шестью ускорителями Tesla и СЖО. 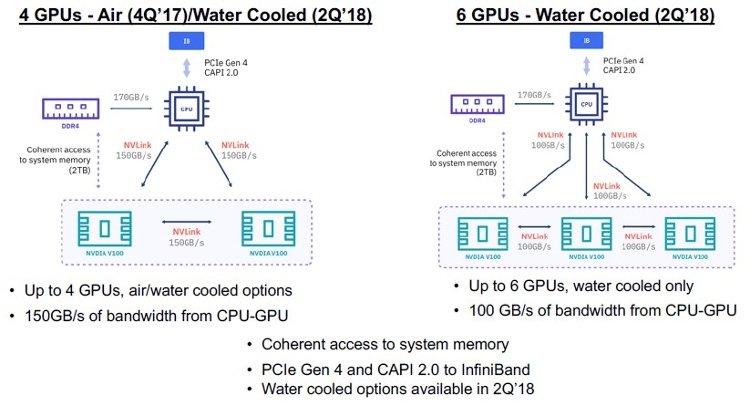 Начались коммерческие поставки 10-нм серверных чипов Qualcomm Centriq 2400
09.11.2017 [13:07],
Сергей Карасёв
Компания Qualcomm Datacenter Technologies, подразделение Qualcomm Incorporated, объявила о старте коммерческих поставок первых в мире 10-нанометровых серверных процессоров — решений семейства Centriq 2400. О разработке чипов Centriq 2400 стало известно ещё в декабре прошлого года. Позднее Qualcomm раскрыла детали об этих изделиях. И вот теперь настало время массовых поставок процессоров. 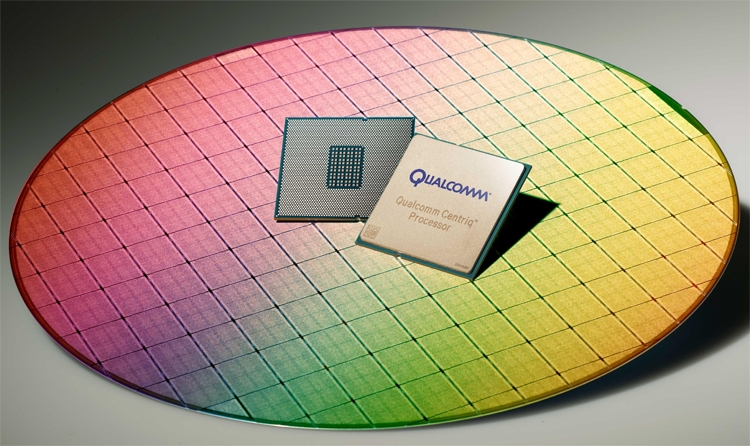
Источник изображений: Qualcomm В основу Centriq 2400 положены 64-битные вычислительные ядра с кодовым именем Falkor, обладающие поддержкой команд ARMv8. Количество таких ядер в составе чипов может достигать 48. Максимальная тактовая частота — 2,6 ГГц. 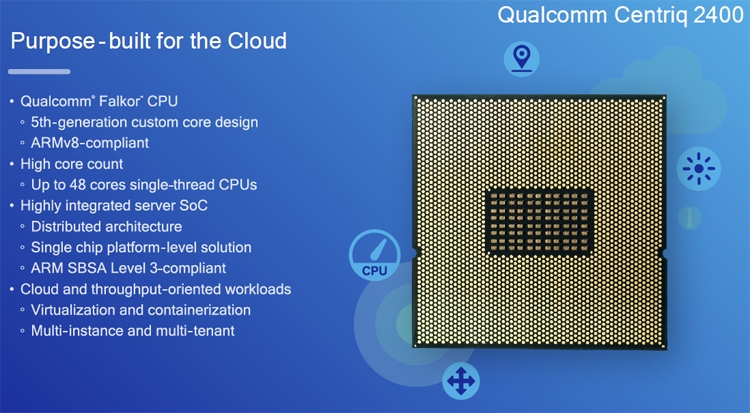 При изготовлении изделий применяется 10-нанометровая технология Samsung FinFET. Процессоры насчитывают до 18 млрд транзисторов. Каждая пара ядер снабжена 512 Кбайт общей кеш-памяти L2, а объём кеша L3 у чипов достигает 60 Мбайт. 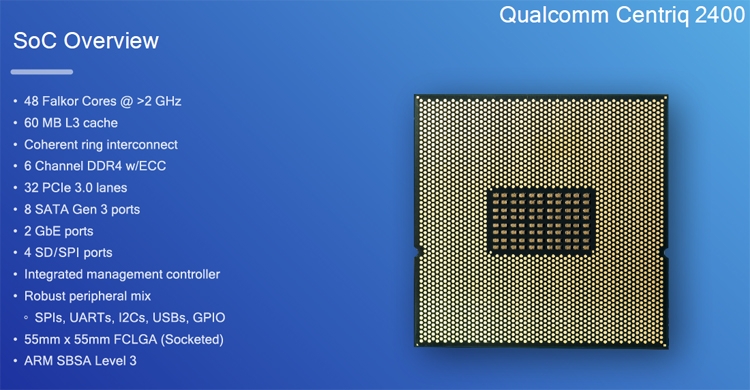 В состав Centriq 2400 вошли 6-канальный контроллер памяти с поддержкой DDR4-2667 МГц ECC (до двух модулей на канал), 32 линии PCI Express 3.0, интерфейсы SATA, USB и пр. 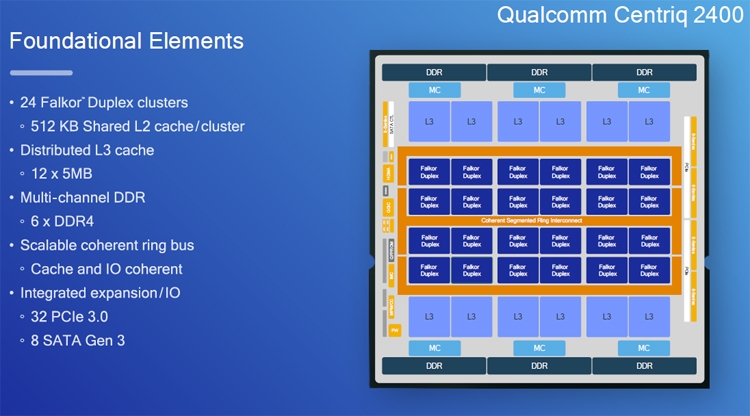 Процессоры ориентированы на современные облачные платформы и центры обработки данных. Более подробную информацию о технических характеристиках можно найти здесь. Что касается стоимости, то изделие Qualcomm Centriq 2460, насчитывающее 48 вычислительных ядер, обойдётся заказчикам в 1995 долларов США. Qualcomm готовит почву для серверного процессора Centriq
02.11.2017 [12:12],
Алексей Степин
Компанию Qualcomm представлять не надо — множество смартфонов оснащены именно процессорами этого разработчика, и многие пользователи не без оснований считают их лучшими, ставя данную серию выше моделей Samsung Exynos или MediaTek. С другой стороны, архитектура ARM пусть и очень медленно, но всё же проникает на корпоративный рынок, а именно — в сектор серверных решений. Известны проекты таких компаний, как Cavium, Applied Micro и даже AMD. Не стоит удивляться тому, что Qualcomm, имея огромный опыт в разработке процессоров с архитектурой ARM, тоже решила откусить кусочек от готовящегося пирога. Уже в течение двух лет существуют слухи о серверном процессоре Qualcomm, но теперь эти слухи переходят в разряд фактов. Последние несколько месяцев представители компании довольно охотно рассказывали о новом процессоре класса SoC под названием Centriq 2400. 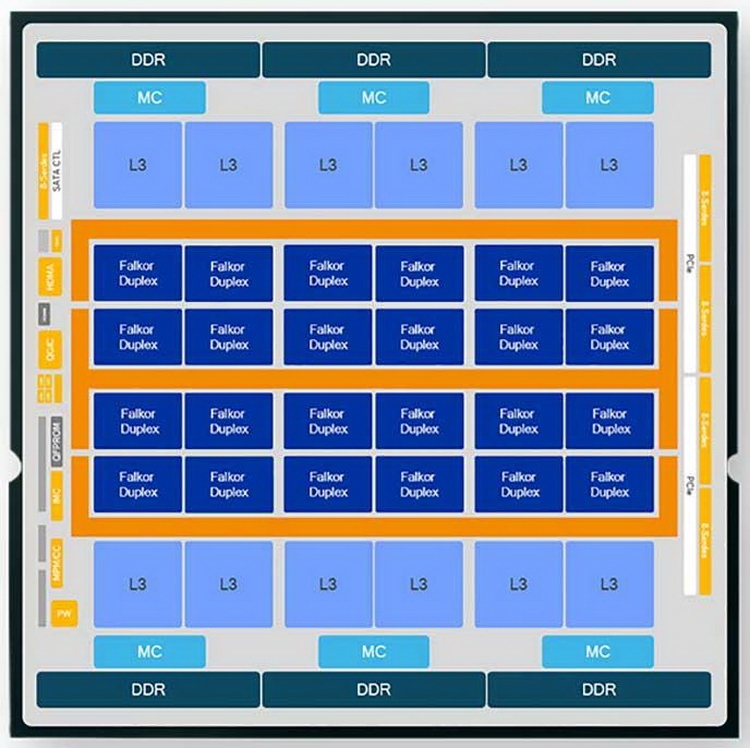
Шестиканальный контроллер памяти обещает отсутствие нехватки ПСП Так, теперь известно, что этот чип будет производиться с использованием 10-нанометрового техпроцесса, и главной целевой аудиторией этого продукта станут поставщики облачных услуг и владельцы крупных ЦОД, для которых очень важную роль играют такие параметры, как энергопотребление и энергоэффективность процессоров. Замах Qualcomm взяла серьезный: если верить заявлениям, система на базе одного процессора Centriq сможет предложить уровень производительности, эквивалентный решениям на базе пары процессоров Xeon с архитектурой Skylake. В отличие от Intel, Qualcomm не обязана тянуть за собой тяжкое наследие совместимости с процессорами настольного класса и использует в своей разработке всё лучшее, что было воплощено в чипах для смартфонов и планшетов. Centriq 2400 должен получить 24 процессорных ядра с кодовым названием Falkor. Это архитектура собственной разработки Qualcomm, но отвечающая всем требованиям стандарта ARMv8. 
Выглядит Cenriq практически так же, как и обычные Xeon, Opteron или EPYC На диаграмме слово Duplex присутствует не зря, поскольку в целом можно говорить о 48 однопоточных ядрах, но в будущем компания планирует наращивать и количество ядер, и количество потоков на ядро. Интересен также тот факт, что Intel отказалась от кольцевой внутренней шины в новых Xeon, а Qualcomm, наоборот, пришла к этой идее. Контроллер памяти DDR4 у Centriq шестиканальный и дополненный, к тому же, средствами аппаратного сжатия данных. Имеется встроенная поддержка сетевых стандартов 10 и 100 GbE, 32 линии PCIe (скорее всего, 3.0) и функций южного моста, а также развитая подсистема управлением питанием. В рамках Open Compute Project компания уже разработала две референсные платформы формата 1OU — с одним либо с двумя процессорными разъёмами под Centriq. Пока это практически всё, что известно о Сentriq 2400. Кое-что было опубликовано нами ранее, но пока мы не знаем тактовых частот и сроков начала массовых поставок. Однако судя по имеющимся сведениям, Qualcomm решила заняться развитием серверной ветки ARM всерьёз и надолго. Терафлопс в космосе: на МКС тестируется компьютер HPE Spaceborne
30.09.2017 [00:15],
Алексей Степин
Бытует мнение, что в космической отрасли используется всё самое лучшее, включая компьютерные компоненты. Это не совсем так: вы не встретите в космических аппаратах 18-ядерных Xeon и ускорителей Tesla. Во-первых, энергетические резервы за пределами Земли строго ограничены, и даже на МКС никто не будет тратить несколько киловатт на питание «космического суперкомпьютера». Во-вторых, практически вся электроника, работающая за пределами атмосферы, выпускается в специальном радиационно-стойком исполнении. Чаще всего за счёт техпроцессов «кремний на диэлектрике» (SOI) и «сапфировая подложка» (SOS), используется также биполярная логика вместо менее стойкой к внешним излучениям CMOS. 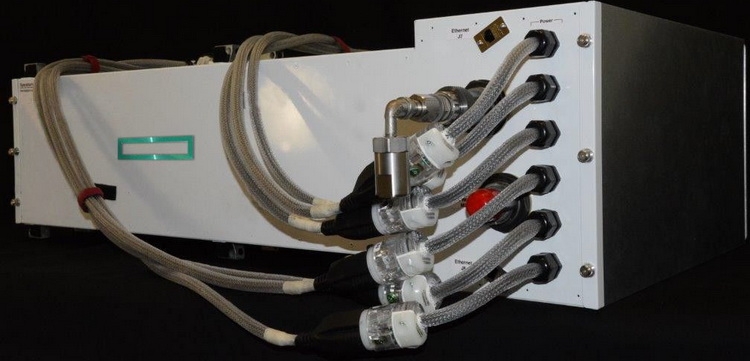
Мини-кластер в космическом исполнении. Охлаждение жидкостное Мощными в космосе считаются такие решения, как BAE Systems серии RAD, особенно новая RAD5500 (от 1 до 4 ядер, 45-нм SOI, PowerPC, 64 бита). Четырёхъядерный вариант RAD5545 развивает производительность более 3,7 гигафлопс при потреблении около 20 ватт. Иными словами, вычислительные мощности в космосе тоже растут, но совсем иными темпами, нежели на Земле. Тому подтверждением служит недавно вступивший в строй на борту Международной космической станции компьютер HPE Spaceborne. Если на Земле мощность суперкомпьютеров измеряется десятками и сотнями петафлопс, то Spaceborne куда скромнее — судя по проведённым тестам, его вычислительная мощность достигает 1 терафлопса. Достигнута она путём сочетания современных процессоров Intel с ускорителями NVIDIA Tesla P100 (NVLink-версия). 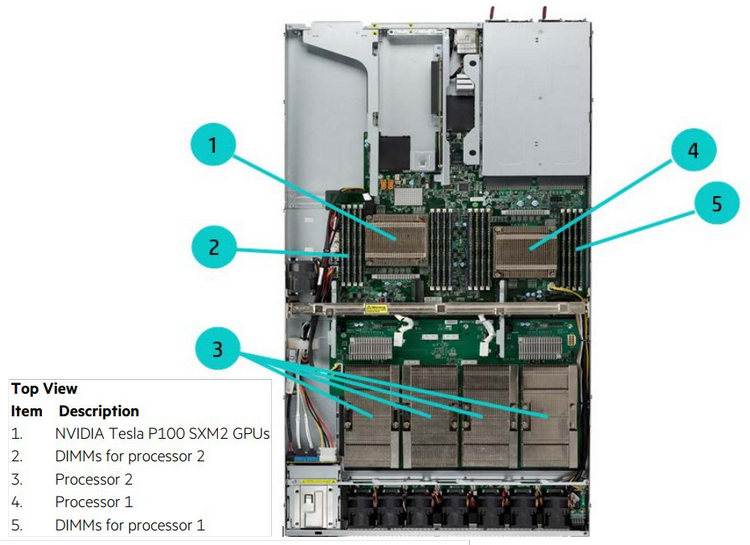
Конфигурация каждого из узлов Spaceborne Для космических систем это большое достижение, и не стоит иронизировать над этим показателем производительности. Интересно, что сама по себе система Spaceborne, доставленная на борт станции миссией SpaceX CRS-12, является своего рода экспериментом на тему «как чувствуют себя в космосе обычные компьютерные комплектующие». Это связка из двух серверов HPE Apollo 40 на базе Intel Xeon, объединённая сетью со скоростью 56 Гбит/с. 14 сентября на систему было подано питание (48 и 110 вольт), а недавно проведены первые тесты High Performance LINPACK. 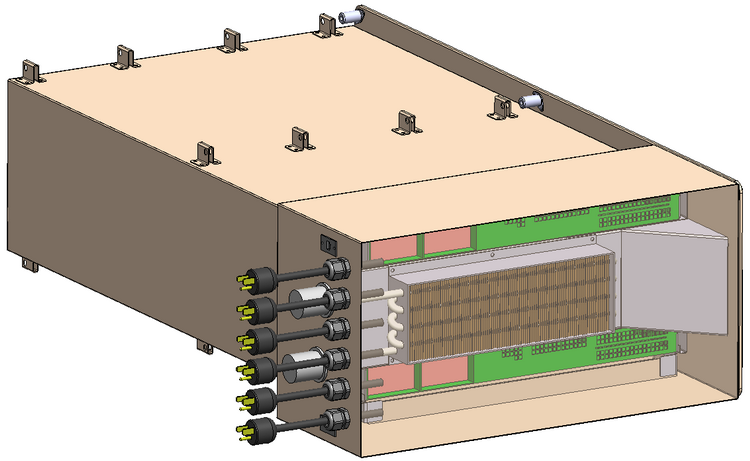
Системы охлаждения и электропитания Spaceborne Пока Spaceborne не будет использоваться для анализа научных данных или управления какими-либо системами станции. Его миссия — продемонстрировать то, насколько живучи обычные серверы в космосе. Результаты постоянных тестов будут сравниваться с аналогичной системой, оставшейся на Земле. Тем не менее, достижение первого терафлопса в космосе является своеобразным мировым рекордом. Это маленький шаг для супервычислений, но большой для всей космической индустрии, поскольку за Spaceborne явно последуют его более совершенные и мощные потомки. «Ростелеком» запустил личный кабинет для операторов связи
05.09.2017 [17:44],
Андрей Крупин
«Ростелеком» объявил о развёртывании в федеральном масштабе системы «Личный кабинет оператора», позволяющей российским телекоммуникационным компаниям дистанционно заказывать и подключать лицензируемые услуги связи, обмениваться с поставщиком бухгалтерскими документами, узнавать о новых сервисах в режиме онлайн и решать прочие задачи. Новый сервис обеспечивает структурированный учёт информации о взаимодействии, автоматизирует обмен расчётными данными, позволяет сократить сроки обработки заявок и ускорить процесс предоставления новых услуг операторам-партнёрам «Ростелекома». Ожидается, что использование нового инструмента уменьшит число телефонных переговоров и объем рутинного и ручного труда персонала как со стороны операторов связи, так и со стороны «Ростелекома», что позволит существенно сократить сроки заключения договоров и соглашений, а в дальнейшем — и сроки реагирования на различные запросы клиентов.  «Запуск личного кабинета для операторов связи — важный элемент построения технологического партнёрства на телекоммуникационном рынке. «Ростелеком» выполняет функцию не только инфраструктурного оператора, но создателя основы для эффективного межоператорского сотрудничества. Новый сервис позволит повысить прозрачность и оперативность взаимодействия операторов, а также предоставит нашим партнёрам лёгкий дистанционный доступ к телеком-инфраструктуре национального оператора связи и даст возможность пользоваться технологическими достижениями компании», — говорится в сообщении «Ростелекома». В «Ростелекоме» видят огромные перспективы нового сервиса на рынке и поэтому планируют развивать и совершенствовать его функциональные возможности. Qualcomm поделилась деталями о 48-ядерных процессорах Centriq 2400
23.08.2017 [12:40],
Геннадий Детинич
Пять лет назад компания Qualcomm приступила к разработкам процессора для серверного рынка. Успешный разработчик уникальных вычислительных архитектур, совместимых с наборами команд ARM, вполне обоснованно решил перенести опыт создания SoC для смартфонов и планшетов в область высокопроизводительных серверных решений. К тому времени требования к серверным процессорам изменились в сторону снижения потребления и лучшей масштабируемости. Социальные сети и облачные сервисы создают настолько неравномерную нагрузку на вычислительные ресурсы ЦОД, что обычные x86-совместимые или RISC/UNIX-платформы перестают считаться эффективным инструментом для решения насущных задач. 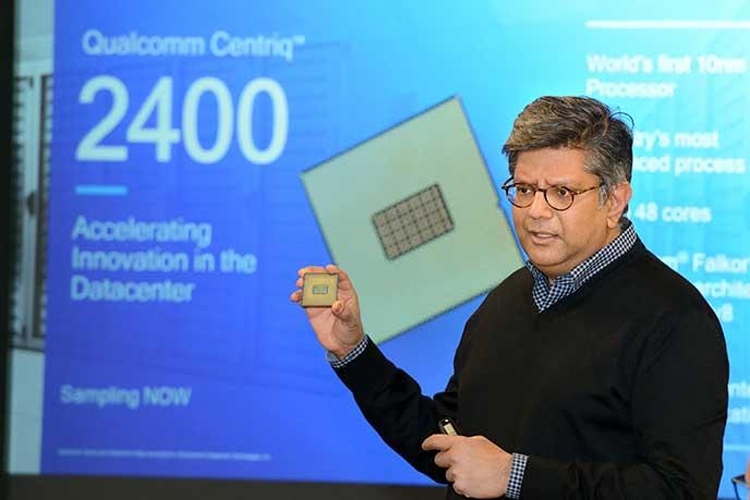 В декабре 2016 года Qualcomm сообщила о завершении разработки и начале пробных поставок процессора Centriq 2400 с числом ядер до 48 штук. На днях компания подтвердила график вывода новинки на рынок, который предусматривает массовые коммерческие поставки SoC Centriq 2400 позднее в текущем году. Также Qualcomm поделилась деталями о строении и архитектуре Centriq 2400. Ниже мы расскажем о ключевых особенностях разработки. 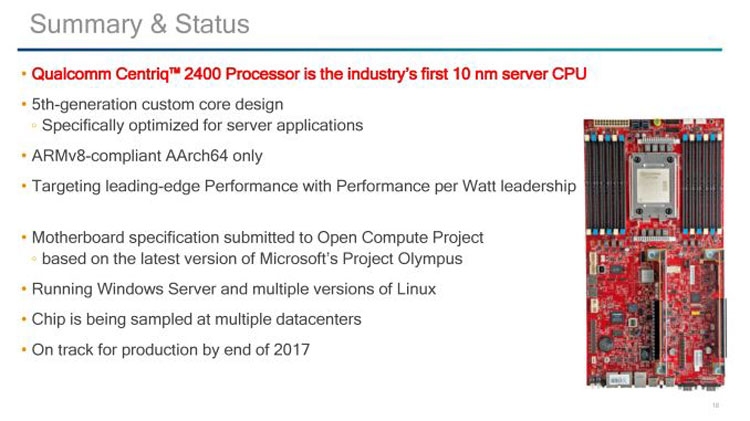 Начнём с того, что внутренний согласованный интерфейс однокристальной сборки Centriq 2400 представляет собой сегментированную кольцевую шину. Компания Intel, как нам известно, в новых серверных и высокопроизводительных настольных процессорах перестанет использовать кольцевую шину в пользу ячеистой шины, что должно улучшить масштабируемость архитектуры для многоядерного окружения. Компания AMD использует другой принцип обмена данными между кластерами в процессорах на ядрах Zen. Все они соединены между собой двунаправленной шиной, топология которой ближе к кольцевой. Сегментированная кольцевая шина в составе Centriq 2400 использует преимущества кольцевой шины (простота, сравнительно низкое потребление) и элементы ячеистой сети внутри сегмента, что даёт возможность балансировать между скоростью, задержками и потреблением. 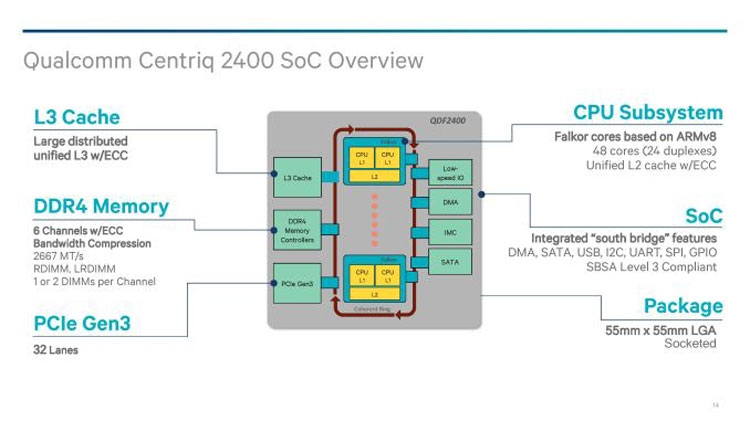 Вычислительные ядра в составе Centriq 2400 самостоятельно разработаны инженерами компании и носят кодовое имя Falkor. Это 64-битные решения с поддержкой команд ARMv8, которые разбиты на модули из двух связанных ядер (дуплексное строение, по определению Qualcomm). Подобное строение позволяет выпускать SoC Centriq 2400 с заданным числом ядер и облегчает масштабирование вычислительной структуры в процессе выполнения задачи. Каждая пара ядер имеет разделяемую кеш-память L2 и разделяемый доступ к кольцевой шине Qualcomm System Bus (QSB). 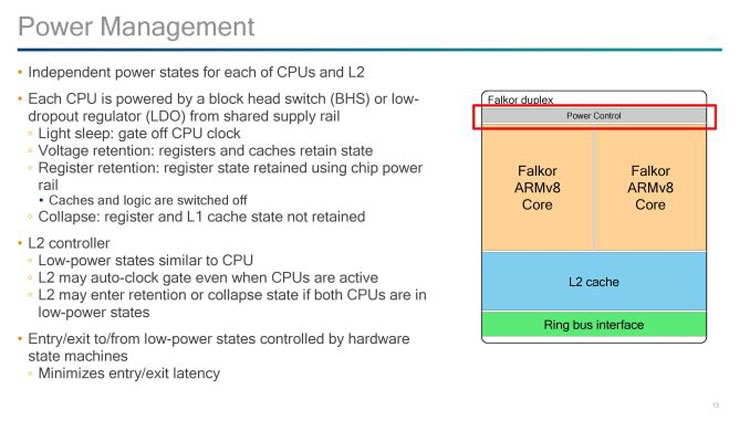 Для снижения потребления каждое ядро и кеш-память L2 имеют ряд состояний потребления энергии, которые контролируются на аппаратном уровне и могут переключаться с минимальными задержками. Вычислительные конвейеры Falkor имеют переменную длину с внеочередным исполнением команд. Это снижает вероятность простоя конвейеров в процессе работы с командами и инструкциями, не оптимизированными для немедленного исполнения. 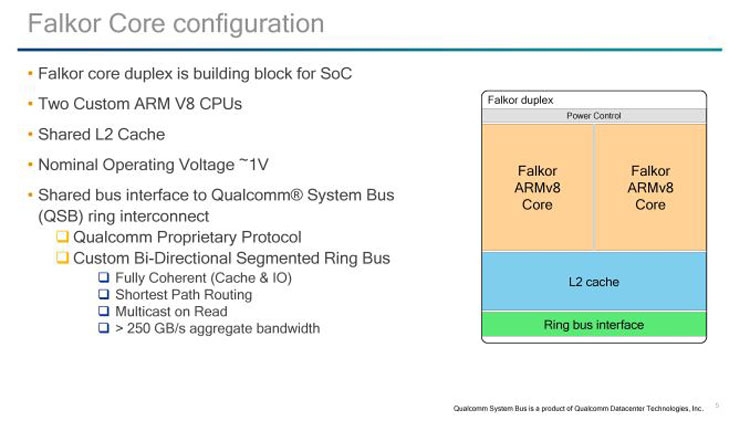 Иерархия кеш-памяти Falkor оптимизирована для обработки значительных массивов данных. Так, кеш-память первого уровня для приёма данных объёмом 32 Кбайт дополнена «несимметричной» кеш-памятью L1 для инструкций: 24 Кбайт L0 и 64 Кбайт L1 (всего 88 Кбайт). Всё это снабжено многоуровневым движком предварительной выборки, который динамически адаптируется под текущую нагрузку. В состав SoC Centriq 2400 вошли 6-канальный контроллер памяти с поддержкой DDR4-2667 МГц ECC (до двух модулей на канал), 32 линии PCI Express 3.0, интерфейсы SATA, USB и более специализированные сигнальные структуры. Также Centriq 2400 несёт интегрированный криптографический блок TrustZone и поддерживает аппаратную виртуализацию. В компании Qualcomm уверены, что данную разработку ждёт успешное будущее. Представлено семейство «4-в-1» процессоров AMD EPYC 7000
21.06.2017 [08:30],
Иван Грудцын
В ночь со вторника на среду AMD официально представила первые серверные процессоры с 14-нм микроархитектурой Zen, скромно именуемые EPYC. Семейство включает 8-, 16-, 24- и 32-ядерные модели «7000-й» серии для однопроцессорных и двухпроцессорных серверов (узлов). В распоряжение OEM-сборщиков поступят 12 CPU с ориентировочной стоимостью от $400 до $4000. Конструкция AMD EPYC довольно примечательна. По крайней мере старшие 32-ядерные модели будут состоять из четырёх кристаллов (8-ядерные блоки Zeppelin), сообщающихся друг с другом посредством высокоскоростного интерфейса Infinity Fabric. Последний также отвечает за взаимодействие двух процессоров в одной системе.   Разъём SP3 (4094 контакта) также можно назвать составным, но стоит отметить, что CPU EPYC — не просто «двойной Ryzen Threadripper», а полноценное серверное решение с поддержкой больших объёмов памяти, массы разнообразных накопителей, специализированных графических адаптеров и ускорителей на базе GPU.  О преимуществах процессоров EPYC 7000 известно не первый день. Среди них — восьмиканальный доступ к памяти, поддержка 2 Тбайт RAM и наличие у каждого CPU 128 линий PCI Express 3.0.  Недавняя утечка сведений об EPYC оказалась, собственно, утечкой, а не вымыслом. AMD действительно готова предложить клиентам девять 1P/2P и три 1P процессора с 8–32 ядрами и 16–64 потоками обработки данных. Из-за обилия блоков системной логики в структуре кристалла частоты EPYC 7000 Series невысоки, а TDP — как раз наоборот. Семейство возглавил 32-ядерный процессор EPYC 7601 с частотой 2,2/3,2 ГГц, 64 Мбайт кеш-памяти третьего уровня и тепловыделением до 180 Вт. Часть CPU имеют настраиваемый TDP в 155/170 Вт — таким образом, у системных интеграторов будет выбор между режимами энергосбережения и максимальной производительности в работе серверов.   AMD не сомневается в преимуществе своих решений над процессорами Broadwell-EP конкурента (Intel). По мнению маркетологов компании, EPYC 7000 намного превосходят Xeon E5-2600 v4 во всех отношениях. В некоторых случаях одного EPYC будет достаточно, чтобы заменить тандем Xeon.   AMD надеется, что двусторонний интерфейс Infinity Fabric с пропускной способностью 38 Гбайт/с на канал и 152 Гбайт/с между CPU-разъёмами позволит кристаллам Zeppelin эффективно взаимодействовать друг с другом. В рамках одного чипа каждый Zeppelin может обмениваться данными со всеми своими собратьями, а в пределах 2P-платформы реализован своего рода покристальный CrossFire.   В Саннивейле рекомендуют серверы в составе EPYC и ускорителей Radeon Instinct на чипах Vega и Polaris. Сотрудничество с AMD в деле создания высокопроизводительных серверов подтвердили компании HPE, Dell, ASUS, Gigabyte, Inventec, Lenovo, Sugon, Supermicro, Tyan, Wistron (материнские платы, серверы в сборе); Microsoft, Red Hat, VMware (программное обеспечение); Mellanox, Samsung Electronics, Xilinx (контроллеры, адаптеры).  
Прототип сервера Gigabyte на базе EPYC (ISC 2017)  Подробности о новых серверных процессорах AMD доступны на официальном сайте компании. HPE отделила подразделение IT-услуг
04.04.2017 [13:34],
Сергей Юртайкин
Корпорация Hewlett Packard Enterprise (HPE) закрыла сделку по передаче бизнеса в области корпоративных IT-услуг конкурирующей компании Computer Sciences. В результате слияния подразделения HPE Enterprise Services, специализирующегося на услугах консалтинга, аутсорсинга и системной интеграции, с Computer Sciences появилась компания DXC Technology. HPE оценивает свои доход от сделки в $13,5 млрд. Сюда входят стоимость доли HPE в новой компании, дивиденды для акционеров и переданные DXC долги и другие обязательства. 
Источник изображения: HPE Объединение HPE Enterprise Services и Computer Sciences было анонсировано в мае 2016 года. Тогда сообщалось, что сделка создаст поставщика IT-услуг с годовой выручкой в $26 млрд, а оставшийся у HPE бизнес (продажа серверов, систем хранения данных, сетевого оборудования, облачных инфраструктур и др. ) будет приносить компании доход в $33 млрд. В совет директоров DXC Technology вошла генеральный директор HPE Мег Уитмен (Meg Whitman). Компании планируют тесно сотрудничать друг с другом. При этом HPE обещает сохранить и развивать созданное недавно подразделение технических услуг Pointnext. После закрытия сделки с Computer Sciences компания HPE понизила прогноз по доходам. К примеру, по итогам текущего финансового года вендор ожидает прибыль на уровне 27–37 центов на акцию, тогда как прежде предсказывал 60–70 центов. Видео: как работает дата-центр «Яндекса» в Финляндии
07.12.2016 [14:50],
Андрей Крупин
Компания «Яндекс» разместила на своей странице видеохостинга YouTube ролик, рассказывающий об особенностях работы самого энергоэффективного центра обработки данных (ЦОД) российского интернет-гиганта, расположенного в городе Мянтсяля в шестидесяти километрах от Хельсинки (Финляндия). Финский центр обработки данных «Яндекса» является одиннадцатым по счёту ЦОД компании и первым, созданным в соответствие с концепцией GreenField, предполагающей проектирование и строительство здания под дата-центр «с нуля». Площадь вычислительного комплекса составляет 3400 кв. м, его проектная мощность достигает 40 МВт. Объект подключён к двум независимым магистральным источникам электроэнергии по 110 киловольт каждый. Для резервирования энерговводов предусмотрено резервное питание от семи установок DRUPS, за счёт кинетической энергии вращающихся барабанов обеспечивающих автономную работу систем дата-центра на момент запуска дизель-генераторных источников бесперебойного питания. Особенностью дата-центра «Яндекса» в Финляндии является система охлаждения, функционирующая по принципу Free Cooling (для охлаждения оборудования применяется наружный воздух) и позволяющая использовать тепло от серверов в полезных целях — для отопления жилых домов Мянтсяля. Серверы финского ЦОД «Яндекса» охлаждаются уличным воздухом, который впоследствии нагнетается в теплообменники, а те, в свою очередь, нагревают воду до 30-45 градусов. После этого станция донагрева увеличивает температуру воды до 55-60 градусов, которая затем поступает в городскую сеть. Такое сотрудничество с городом позволяет «Яндексу» экономить до трети расходов на электроэнергию, потребляемую дата-центром. «Яндекс» намерен и впредь совершенствовать систему охлаждения серверов уличным воздухом. Задействованные в финском ЦОД энергоэффективные технологии и инновационные решения компания планирует использовать в строящемся во Владимире центре обработки данных. Запуск нового дата-центра ожидается в первом квартале 2017 года. IBM рассказала о мощных процессорах Power9
26.08.2016 [15:36],
Сергей Карасёв
Корпорация IBM на конференции Hot Chips 28 в Купертино (Калифорния, США) раскрыла довольно подробную информацию о мощных процессорах Power9, которые выйдут на рынок в следующем году. Итак, сообщается, что чипы будут изготавливаться по 14-нанометровой технологии FinFET. Они получат 120 Мбайт кеша третьего уровня и смогут работать с буферизированными и не буферизированными модулями памяти DDR4. 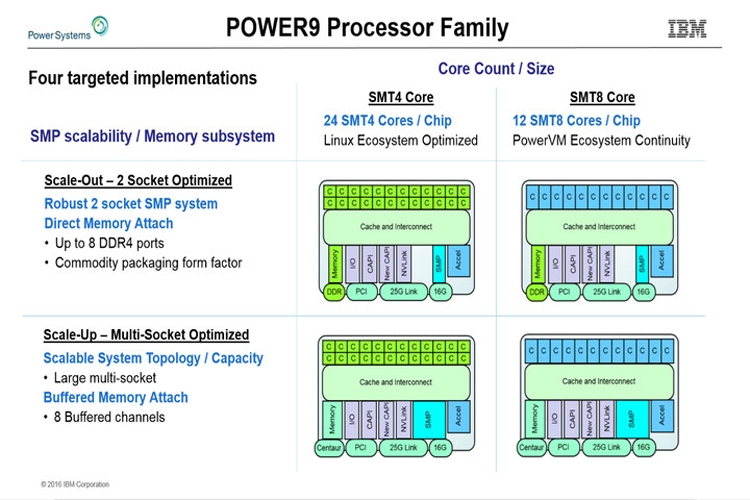 Корпорация IBM готовит несколько модификаций Power9. В частности, говорится об изделиях с 12 вычислительными ядрами, каждое из которых сможет одновременно обрабатывать восемь потоков инструкций. Такие процессоры будут ориентированы прежде всего на системы с виртуализацией. 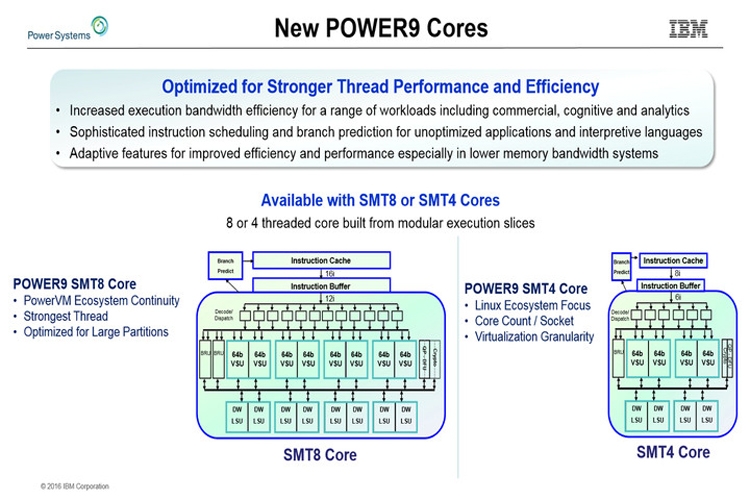 Кроме того, будут выпущены чипы с 24 вычислительными ядрами с поддержкой одновременной обработки четырёх потоков инструкций. Эти решения найдут применение в различных Linux-платформах. 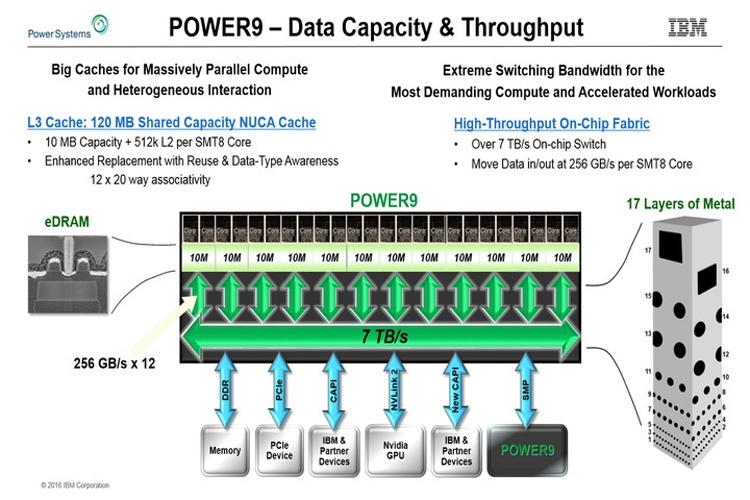 Отмечается, что в Power9 будут реализованы улучшенные средства предсказания ветвлений, что позволит поднять скорость вычислений. Кроме того, говорится о реализации новых инструкций для поддержки будущих перспективных технологий и о 48 линиях PCI Express 4.0. 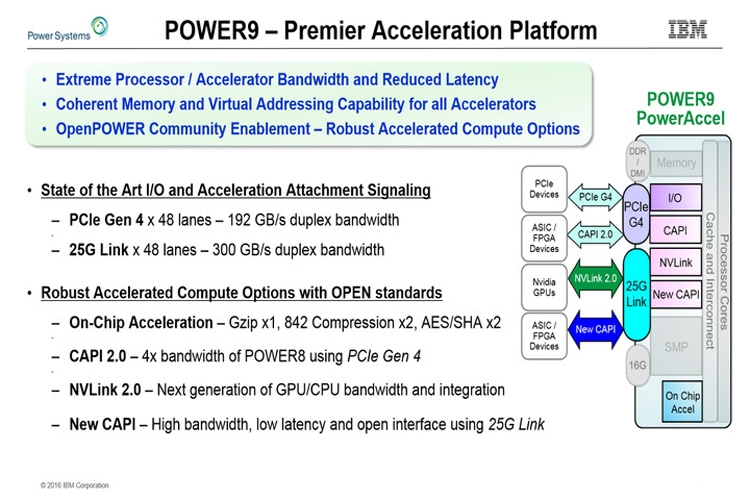 В общей сложности процессоры получат до 8 млрд транзисторов. Они обеспечат существенный прирост производительности по сравнению с изделиями предыдущего поколения. IDF 2016: Intel анонсировала Knights Mill — новую архитектуру ускорителей Xeon Phi для задач глубинного обучения
18.08.2016 [09:50],
Валерий Косихин
На конференции Intel Developer Forum, которая в данный момент проходит в Сан-Франциско, была названа следующая версия архитектуры MIC (Many Integrated Cores), основанные на которой продукты пополнят семейство ускорителей параллельных вычислений Xeon Phi — Knights Mill. От Intel давно не поступало новостей касательно планов по развитию этой линейки устройств. На сегодняшний день Intel выпустила два поколения Xeon Phi — Knights Corner в 2013 году и Knights Landing в 2016-м. Согласно предыдущим заявлениям, третье поколение получит кодовое название Knights Hill, а соответствующие чипы будут производиться по технологической норме 10 нм. В кратком выступлении, которое Intel посвятила анонсу Knights Mill, не пояснили, как новинка соотносится с прошлыми планами. Возможно, что Knights Mill является промежуточной остановкой на пути к Knights Hill. По другой версии, новый продукт олицетворяет ответвление от основного пути развития, предназначенное для специфической ниши — глубинного обучения. 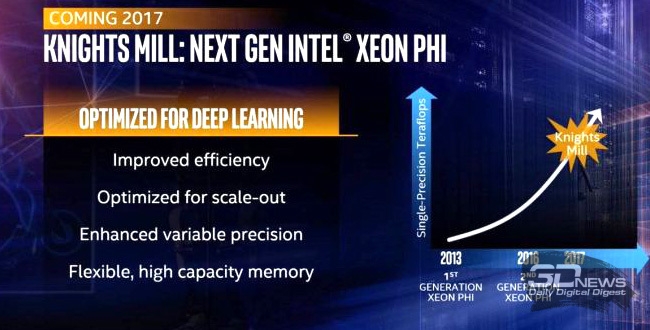 Глубинное обучение — одно из направлений задач машинного обучения, которое предполагает моделирование абстрактных понятий за счет построения многократно ветвящихся графов. На практике это применяется в программах компьютерного зрения, распознавания объектов, человеческой речи и т.п. Определяющий признак, который сделает Knights Mill подходящей платформой для глубинного обучения — то, что Intel довольно расплывчато обозначила термином «переменная точность». Скорее всего, речь идет о поддержке формата чисел с плавающей запятой FP16 (половинная точность) либо других форматов с еще меньшей разрядностью. FP16 является приоритетным форматом для задач глубинного обучения, поскольку они не требуют более высокой точности, а процессор достигает более высокой пропускной способности при условии, что FP16 поддерживается им «в железе». Поддержка половинной точности реализована в GPU последнего поколения от AMD и NVIDIA, и ускорители вычислений Tesla на базе архитектуры Pascal специально оптимизированы для высокой скорости в работе с FP16. Появление чипов Knights Mill упрочит позиции Intel в конкуренции с NVIDIA на этом рынке. При этом разработчики указывают на ряд преимуществ архитектуры MIC по сравнению с графическими процессорами. Xeon Phi, начиная с поколения Kings Landing, существуют в сокетном форм-факторе, который позволяет загружать ОС непосредственно с MIC без необходимости в отдельном CPU традиционной архитектуры. Также, наряду с массивом высокоскоростной набортной памяти MCDRAM (разновидность HBM) Knights Landing, как и его потомок Knights Mill, может напрямую адресовать внешние модули DDR4 SDRAM. NVIDIA Tesla не может похвастаться такими функциями. 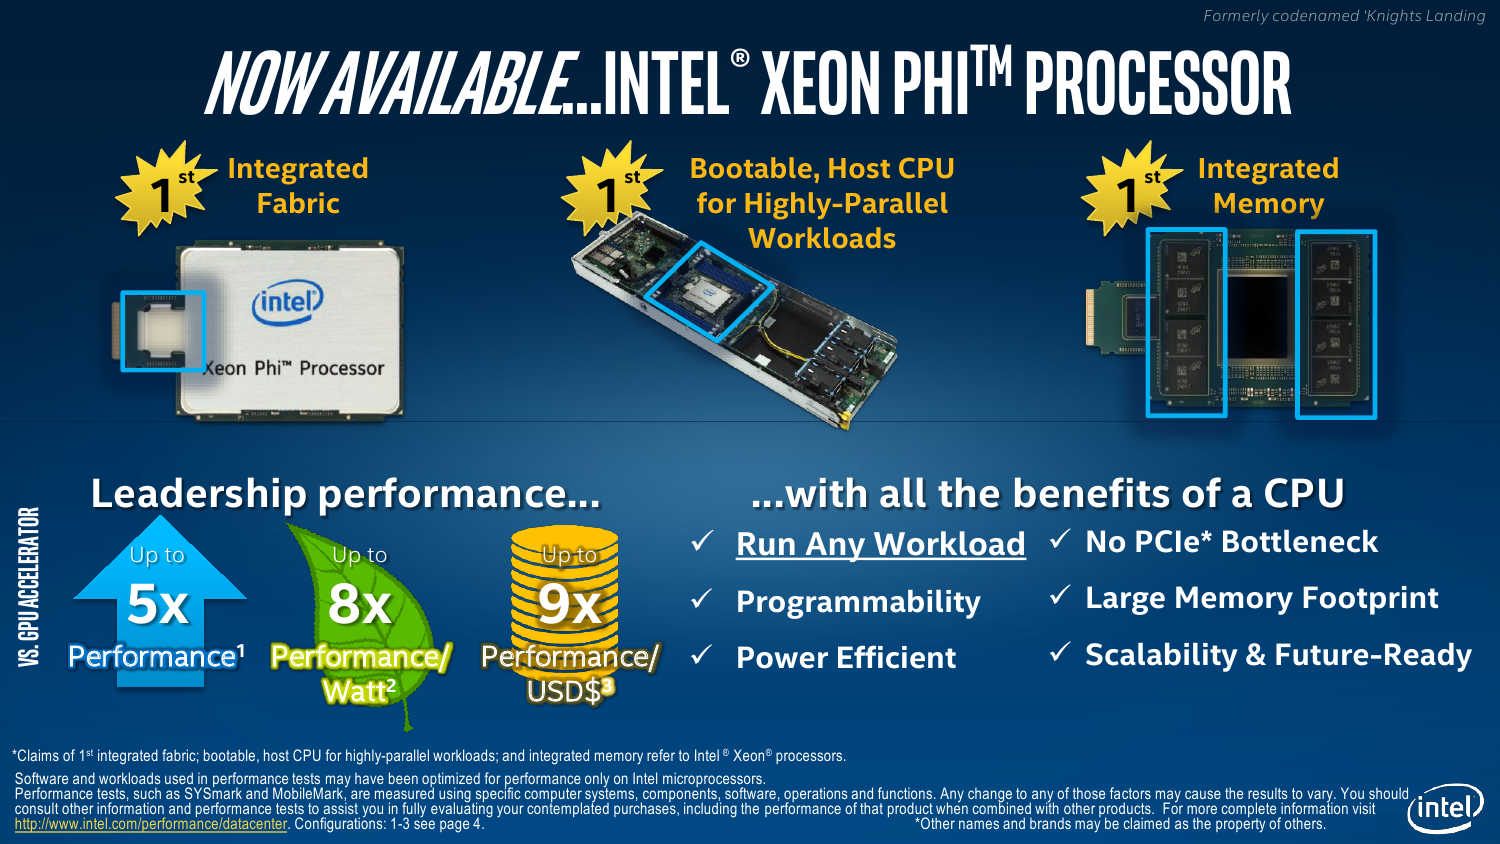 Массовое производство чипов Knights Mill намечено на 2017 г. Судя по графику на слайде Intel (который, впрочем, вряд ли отражает какие-либо твердые числа), Knights Mill удвоит показатели быстродействия, характерные для предыдущего поколения Xeon Phi. Это, в свою очередь, сигнализирует о применении техпроцесса 10 нм, и в таком случае не исключено, что Knights Mill — это просто новое название для ранее анонсированной архитектуры Knights Hill. Intel представила процессоры Xeon Phi Knights Landing
20.06.2016 [19:30],
Илья Гавриченков
Многоядерные ускорители вычислений Intel Xeon Phi продолжают своё развитие. Об их очередном поколении с кодовым именем Knights Landing разработчик рассказывает уже почти три года, а с конца прошлого года даже поставляет образцы систем с ними своим избранным партнёрам. Однако до официального анонса дело дошло только сейчас. В рамках проходящей в эти дни в Германии конференции ISC High Performance 2016 компания Intel официально объявила о выходе принципиально новых Xeon Phi на базе дизайна Knights Landing, ключевое свойство которых заключается в том, что теперь это — не сопроцессоры, а полноценные x86-процессоры, способные взять на себя роль центрального компонента системы. Иными словами, новые Xeon Phi могут работать полностью самостоятельно, не нуждаясь ни в каком дополнительном управляющем CPU. И это очень важное улучшение, так как проведённое коренное изменение архитектуры ликвидирует узкое место — шину PCI Express, которую используют для передачи данных предшествующие и конкурирующие ускорители вычислений, например, базирующиеся на GPU. 
Источник изображений: Intel Knights Landing воплощают собой уже третье поколение многоядерной x86-архитектуры Intel. Предыдущее поколение, известное под кодовым именем Knights Corner, базировалось на Pentium-подобных ядрах P54C. Новая же версия ускорителей переехала на модифицированную 14-нм микроархитектуру Airmont, известную по процессорам Atom. Однако в Knights Landing ядра Airmont попарно объединены в модули, которые включают также мегабайтный L2-кеш и четыре блока VPU (Vector Processing Unit), отвечающих за поддержку векторных инструкций AVX-512. Всего в новых процессорах Xeon Phi содержится до 36 таких модулей, то есть, общее число ядер в ускорителе может достигать 72. При этом каждое ядро дополнительно поддерживает технологию Hyper-Threading и способно выполнять до четырёх потоков одновременно, что наделяет Xeon Phi впечатляющим арсеналом средств для работы с параллельными вычислениями. Учитывая, что в Knights Landing производительность на поток по сравнению с Knights Corner выросла примерно втрое только за счёт смены микроархитектуры, обновление ускорителей Xeon Phi дало им возможность дотянуться до планки в 3 Тфлопс. Процессоры Knights Landing снабжены также интегрированной памятью MCDRAM с пропускной способностью до 500 Гбайт/с и объёмом 16 Гбайт, которая может взаимодействовать с системной шестиканальной DDR4-памятью по нескольким принципиально различным алгоритмам. Упоминания заслуживает и реализация в новых Xeon Phi отдельного двухпортового 100 Гбит/с-контроллера Omni-Path, который предполагается использовать для высокоскоростного объединения узлов, основанных на Knights Landing, в вычислительные кластеры. Объявленная сегодня линейка процессоров Xeon Phi поколения Knights Landing включает четыре модели с числом ядер от 64 до 72 и частотой от 1,3 до 1,5 ГГц. 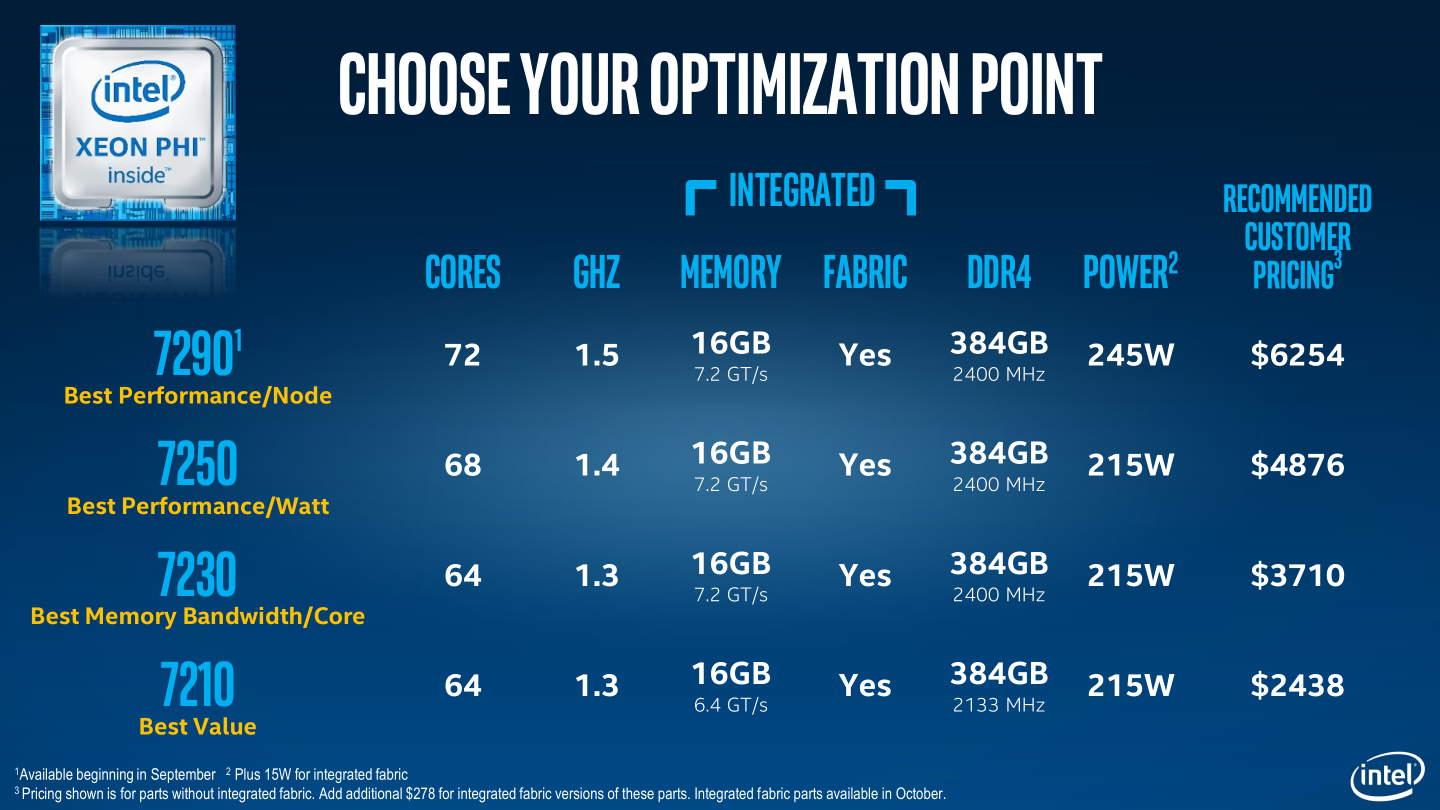 Стоит отметить, что в настоящее время для заказчиков доступны лишь три младшие модели: Xeon Phi 7250, 7230 и 7210. Самая же мощная 72-ядерная версия ускорителя, Xeon Phi 7290, обещана к сентябрю. Также пока Intel не поставляет варианты с интегрированным контроллером Omni-Path, который по плану появится в перечисленных моделях в октябре этого года. Высокая производительность процессоров Xeon Phi, простая масштабируемость систем на их основе, а также полная совместимость с x86-экосистемой и знакомым всем средствами разработки, делает новинки отличным вариантом для использования в массе областей, где требуются параллельные высокопроизводительного вычисления. И особенно Intel подчёркивает применимость построенных на Xeon Phi кластеров в системах машинного обучения и искусственного интеллекта, то есть тех областях, где в последнее время высокую активность развила NVIDIA, реализующая свои ускорители семейства Tesla. В подтверждение лидирующих характеристик Knights Landing, компания Intel приводит информацию о кратном превосходстве системы на базе Xeon Phi 7250 над системой, в которой используется конкурирующий ускоритель вычислений NVIDIA Tesla K80 и пара центральных процессоров Xeon E5-2697 v4. 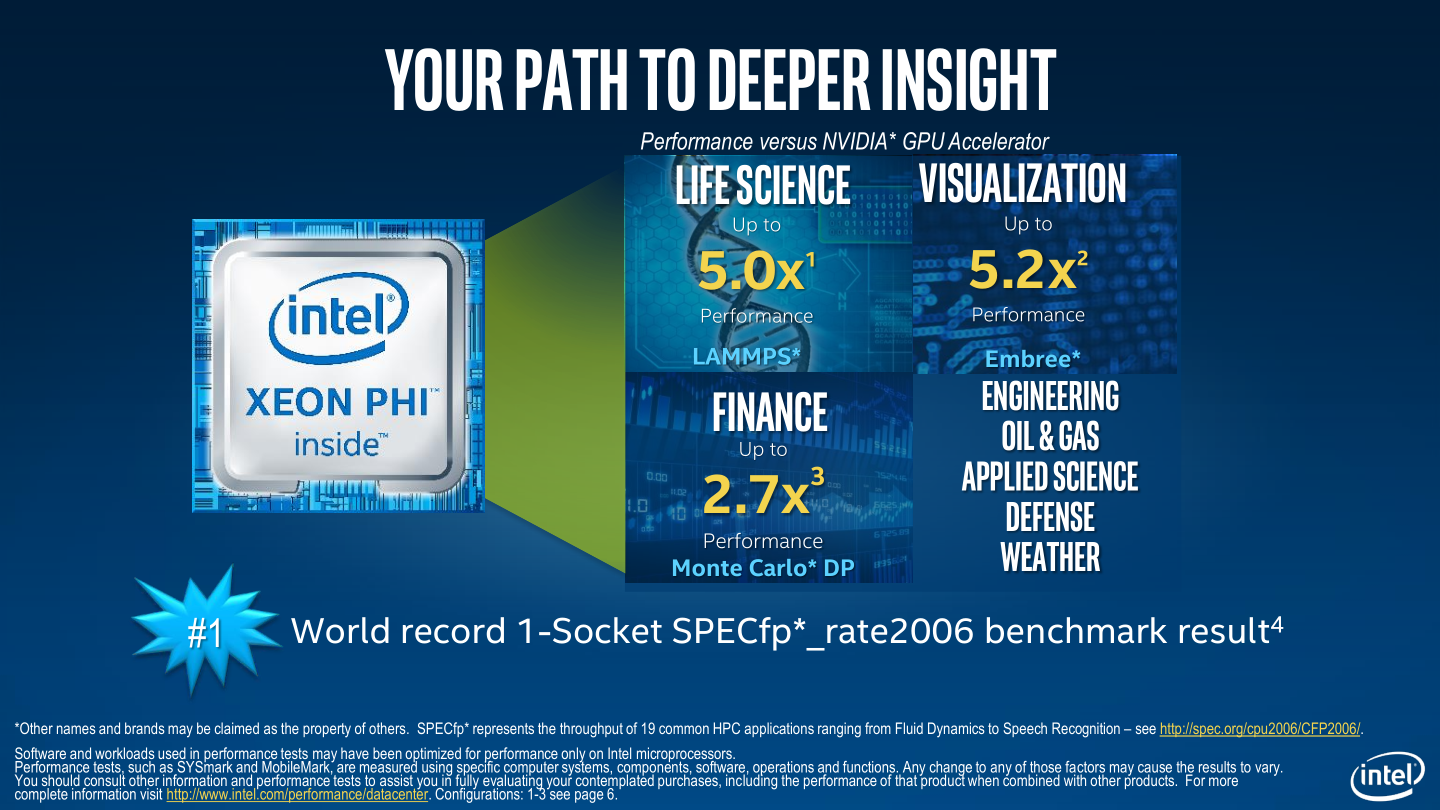 При этом, Intel говорит не только о достигающем пятикратного размера преимуществе Xeon Phi в производительности. Согласно информации компании, конфигурация с процессором Xeon Phi 7250 оказывается в восемь раз экономичнее и в девять — дешевле. Учитывая всё сказанное, Intel ожидает, что внедрение новых Xeon Phi пойдёт очень быстрыми темпами. До конца года производитель намеревается продать более ста тысяч процессоров, а готовые системы на базе Knights Landing будут поставлять более 50 компаний, включая Dell, Fujitsu, Hitachi, HP, Inspur, Lenovo, NEC, Oracle, Quanta, SGI, Supermicro, Colfax и другие. Кстати, в этом списке место нашлось и для российского интегратора — группы компаний РСК — которая собирается поставлять высокоплотные кластерные решения на базе Xeon Phi, оснащённые системами жидкостного охлаждения. 240-Тбайт 4U-стойки Backblaze по цене 3,6 цента за 1 Гбайт
27.04.2016 [14:00],
Александр Будик
Предоставляющая облачные сервисы компания Backblaze регулярно публикует статистические данные о выходе из строя жёстких дисков. Также она не скрывает информацию о спецификациях и дизайне своих систем. Последний анонс Backblaze касается её шестого поколения стоечных систем хранения данных, которые при увеличении совокупной ёмкости характеризуются ещё более низкой стоимостью в расчете на 1 Гбайт. 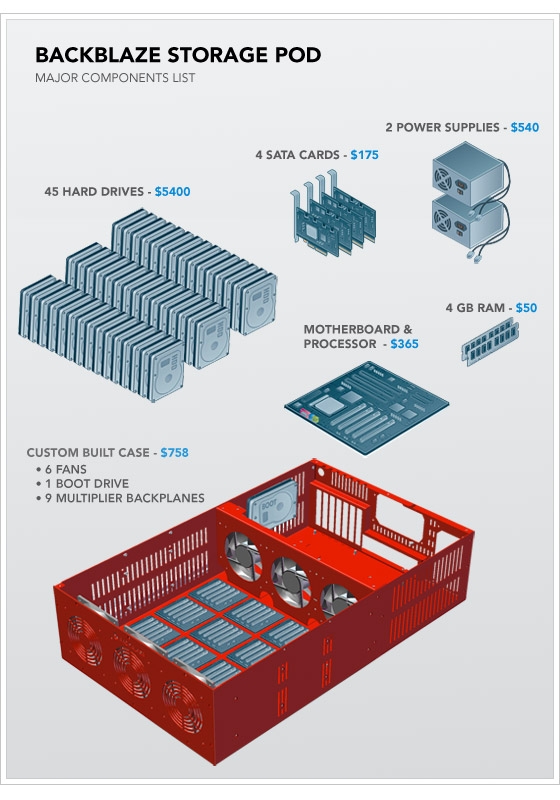
Первые поколения хранилищ Backblaze В одной из своих первых систем в 2009 году компания «упаковала» 45 HDD ёмкостью по 1,5 Тбайт каждый в стойки формата 4U. На тот момент стоимость одного гигабайта составила 12 центов. В следующих итерациях Backblaze экспериментировала с архитектурой системы, используя то концентраторы портов SATA, то карты PCI Express с SATA-контроллерами. Но каждый раз на один модуль приходилось ровно 45 HDD. 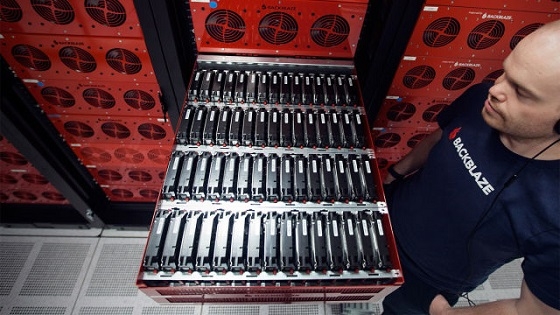
4U-стойка с 60 HDD В новом поколении 4U-стоек компания добавила контроллеры и концентраторы портов, что позволило увеличить количество накопителей до 60. Как и в пятой версии, новые системы используют процессор Ivy Bridge и 32 Гбайт оперативной памяти. Благодаря оптовым закупкам Backblaze имеет скидку более 20 %. Она строит свои системы с использованием 4-Тбайт накопителей Seagate. Стоимость одного гигабайта в таких 4U-стойках составила 3,6 цента, что примерно в три раза меньше по сравнению с первым поколением устройств. Как отмечают специалисты компании, использование 8-Тбайт дисков позволит увеличить плотность хранилища, но в таком случае удельная стоимость системы вырастет. Отметим, продажей систем хранения данных компания не занимается и собирает их только для своих нужд. |
|||||||||||||||
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.


 MWC 2018
 2018
 Computex
 IFA 2018